
Categoría: Agentes de IA

  • Como desplegar agentes de IA: batch, streaming y edge

    Como desplegar agentes de IA: batch, streaming y edge

    El despliegue de agentes de IA rara vez es un solo paso: es una cadena de decisiones que empieza en la experimentacion y termina en produccion estable. Un nuevo material formativo aborda esta fase como parte del ciclo LLMOps y describe cuatro patrones concretos —batch, streaming, tiempo real y edge— con sus casos de uso, latencia y coste. La idea central es sencilla y a menudo olvidada: no existe un patron mejor que otro, sino uno adecuado para cada producto y cada requisito operativo. Este articulo resume esos patrones y por que importan a quien lleva sistemas de IA a produccion.

    Que plantea este enfoque y por que importa

    El contenido se presenta como la primera parte de un crash course de LLMOps orientado a mover sistemas de IA desde el prototipo hasta produccion de forma fiable y eficiente. Su tesis es que el despliegue de agentes de IA forma parte de un ciclo de vida, no de un evento aislado, y que las decisiones tomadas en cada fase condicionan coste y experiencia de usuario. Se describen cuatro patrones principales. El batch procesa cargas grandes que no son sensibles a la latencia. El streaming devuelve la respuesta token a token para mejorar la percepcion de rapidez. El tiempo real se reserva para cuando la interaccion debe parecer instantanea. El edge se propone para escenarios con requisitos estrictos de privacidad, baja latencia local o conectividad intermitente.

    El marco tiene valor porque ordena una conversacion que suele empezar por la herramienta y no por el requisito. Muchos equipos eligen infraestructura antes de definir cuanta latencia toleran sus usuarios o si necesitan procesar datos fuera de sus servidores. Al vincular cada patron a un caso de uso y a sus compensaciones, el enfoque obliga a razonar primero sobre el producto. Esa disciplina es especialmente util en un momento en que los agentes pasan de la demostracion al uso continuado.

    Implicaciones tecnicas de cada patron

    La comparacion entre los patrones de despliegue de agentes de IA se articula sobre tres ejes practicos: coste, complejidad de infraestructura y experiencia de usuario. El batch es el mas eficiente en coste cuando el trabajo puede agruparse y esperar, pero no sirve para interacciones conversacionales. El streaming reduce la latencia percibida sin acelerar realmente el computo: el usuario ve texto antes de que termine la generacion completa, lo que mejora la sensacion de fluidez. El tiempo real exige la infraestructura mas exigente porque cada peticion debe responderse de inmediato, lo que eleva el coste por consulta y la complejidad operativa.

    El edge introduce un compromiso distinto. Ejecutar la inferencia cerca del dispositivo o en el propio dispositivo permite cumplir requisitos de privacidad, mantener baja latencia local y funcionar con conectividad intermitente, pero traslada la carga a un hardware mas limitado y complica el mantenimiento del sistema distribuido. La eleccion entre estos patrones no es puramente tecnica: depende de que tolera el usuario, que exige el negocio y cuanto se esta dispuesto a pagar. El material insiste en que estos trade-offs deben decidirse de forma explicita, no heredarse por inercia de un prototipo.

    Cuando y para quien sera relevante esto

    Este marco es relevante hoy, no en un horizonte lejano, pero afecta primero a quienes ya tienen un prototipo de agente funcionando y quieren llevarlo a produccion. Los equipos de MLOps, los ingenieros de plataforma y los responsables de producto son la audiencia inmediata, porque son quienes deciden latencia, coste y arquitectura. Para una organizacion que todavia esta en fase de experimentacion, la leccion util es anticipar estas decisiones antes de comprometerse con una infraestructura, ya que rehacer el despliegue de agentes de IA en produccion es caro. El patron edge, en concreto, empezara a importar antes en sectores con normativa de datos estricta o con operaciones fisicas donde la conectividad falla. El resto de patrones —batch, streaming y tiempo real— son ya decisiones cotidianas para cualquier equipo con un agente en manos de usuarios reales. El valor del contenido esta en dar un vocabulario comun para discutir esas opciones con criterio, mas que en presentar tecnologia nueva.

    Analisis Blixel

    Lo que mas se agradece de este tipo de material es que separa la fase de demostracion de la de operacion continuada. En la practica vemos que muchos proyectos se rompen justo ahi: el prototipo funciona en una notebook, impresiona en la reunion y luego colapsa cuando cien usuarios lo golpean a la vez o cuando el area legal pregunta donde se procesan los datos. Ordenar el debate en cuatro patrones ayuda a evitar ese salto al vacio. Dicho esto, el marco tiene un limite: los patrones no son excluyentes. Un sistema real suele combinar batch para el trabajo pesado nocturno, streaming para la conversacion y algo de procesamiento local para lo sensible. Presentarlos como opciones separadas es didactico, pero el diseno maduro es hibrido. Nuestra recomendacion para un equipo que arranca es empezar por el requisito mas duro —privacidad, latencia o coste— y dejar que ese requisito descarte patrones, en lugar de enamorarse de una arquitectura. El streaming, ademas, merece una nota aparte: es la forma mas barata de mejorar la percepcion de rapidez sin tocar el modelo, y demasiados equipos la ignoran. Como primera entrega de un curso, cumple: pone nombre a decisiones que muchos toman a ciegas. Falta la parte dificil, que es la observabilidad y el coste real en produccion, pero como punto de partida es honesto y aplicable.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Canary vigila las dependencias de todo tu codigo

    Canary vigila las dependencias de todo tu codigo

    El monitoreo de dependencias externas deja de ser un ejercicio manual con la llegada de Canary, la primera herramienta de Gloria.dev. Se presenta como una capa global de monitorizacion para los servicios de terceros que consume tu codigo: APIs, proveedores de autenticacion y procesadores de pagos. La idea es sencilla y muy necesaria: descubrir automaticamente que servicios externos usa cada repositorio, construir un mapa de esas dependencias y vigilar su disponibilidad y rendimiento sin depender de documentacion que casi siempre esta desactualizada.

    Que ha pasado y por que importa

    Gloria.dev ha lanzado Canary, una herramienta que se integra con los repositorios y el codigo para hacer un inventario continuo de las llamadas a servicios externos. En lugar de que un equipo mantenga a mano una lista de APIs, pasarelas de pago y proveedores de autenticacion, Canary rastrea el codigo, detecta esas llamadas y las representa en un mapa de dependencias. Sobre ese mapa vigila de forma continua la salud de cada servicio, detectando errores y degradaciones antes de que escalen a una interrupcion en produccion. El objetivo declarado es reducir el tiempo de diagnostico cuando algo falla y evitar cortes que afectan al usuario final.

    El problema que ataca es real y creciente. La proliferacion de microservicios y, cada vez mas, los agentes de codigo que generan integraciones de forma automatica multiplican las dependencias externas de un proyecto. El resultado habitual es que ningun equipo tiene un inventario fiable de que servicios utiliza ni del estado de cada uno. Ese conocimiento suele quedar fragmentado entre personas concretas y documentos que envejecen mal. El monitoreo de dependencias externas que propone Canary busca centralizar esa informacion y mantenerla viva de forma automatica.

    Implicaciones tecnicas para equipos con multiples codebases

    El enfoque de Gloria.dev esta pensado para organizaciones con muchos codebases, donde el conocimiento de dependencias esta especialmente disperso. Al descubrir las llamadas externas directamente desde el codigo y los repositorios, Canary reduce la brecha entre lo que la documentacion dice que se usa y lo que realmente se ejecuta en produccion. Ese descubrimiento automatico es la diferencia clave frente a mantener catalogos manuales: el mapa se actualiza a medida que cambia el codigo, no cuando alguien se acuerda de anotarlo.

    La vigilancia continua de disponibilidad y rendimiento anade una capa de observabilidad centrada en el proveedor externo, no solo en tu propio servicio. Cuando un procesador de pagos se degrada o un proveedor de autenticacion empieza a devolver errores, el monitoreo de dependencias externas permite senalar el origen antes de que el equipo pierda horas revisando su propio codigo. Ese acortamiento del tiempo de diagnostico es donde una herramienta asi paga su coste: en incidentes, cada minuto de identificacion del culpable cuenta, sobre todo cuando la causa esta fuera de tu control y solo puedes reaccionar activando un plan alternativo o avisando al proveedor.

    Como pueden aplicar esto las empresas hoy

    La accion mas directa es hacer un inventario honesto de tus dependencias externas antes de comprar nada. Si tu equipo no sabe con certeza cuantas APIs, pasarelas de pago y proveedores de autenticacion consume cada repositorio, ese solo dato ya justifica probar una herramienta de descubrimiento automatico como Canary. Empieza por los codebases criticos, los que tocan pagos o autenticacion, y comprueba si el mapa que genera coincide con lo que creias saber. Casi siempre aparecen sorpresas.

    Para evaluar el ROI, mide el tiempo medio que hoy tardas en identificar si un incidente viene de un servicio externo o de tu codigo. Si ese diagnostico se come una parte grande de tus incidentes en produccion, el monitoreo de dependencias externas tiene sentido economico. Que evitar: no lo trates como sustituto de tu observabilidad interna ni de tus alertas de aplicacion, sino como una capa complementaria centrada en terceros. Y desconfia de configurarlo y olvidarlo: un mapa de dependencias solo es util si alguien revisa las alertas y actualiza los planes de contingencia para los proveedores marcados como criticos.

    Analisis Blixel

    Hay una verdad incomoda detras de este lanzamiento: la mayoria de los equipos no sabe de que depende su software. La documentacion de arquitectura envejece a la velocidad del primer sprint, y con agentes de codigo generando integraciones sin supervision humana constante, el problema solo empeora. Una herramienta que lea el codigo real y no la teoria escrita en un wiki ataca precisamente esa grieta. El valor no esta en la palabra observabilidad, sino en devolver a los equipos algo tan basico como saber que estan usando de verdad. Dicho esto, conviene rebajar expectativas. Un mapa automatico de dependencias es tan bueno como su capacidad de detectar patrones de llamada poco convencionales, y ahi es donde estas herramientas suelen fallar: SDKs que ofuscan el destino, colas intermedias, servicios internos que a su vez llaman a terceros. El monitoreo de dependencias externas resuelve el que uso y el esta caido, pero no sustituye el criterio de ingenieria para decidir que hacer cuando un proveedor critico falla. Para una PYME con dos o tres repositorios, quizas sea exagerado. Para una organizacion con decenas de codebases y rotacion de personas, es la clase de higiene basica que se agradece tener antes del proximo incidente de pagos a las tres de la madrugada. La pregunta util no es si necesitas visibilidad, es cuanto te cuesta hoy no tenerla.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Alook: monta una empresa de IA con agentes autoalojados

    Alook: monta una empresa de IA con agentes autoalojados

    Construir una empresa de agentes de IA deja de ser un experimento con scripts sueltos y pasa a tener forma de organigrama. Alook es una plataforma de codigo abierto y autoalojada que permite crear y gestionar «empresas de una sola persona» impulsadas por agentes. Cada puesto del organigrama se representa con un agente que se comunica mediante mensajes en lugar de correos, y la interfaz deja verlos y gestionarlos como si fueran empleados reales, con su estado y sus conversaciones. La propuesta es simple pero poco habitual: hacer operativa y visible una arquitectura de agentes.

    Que es Alook y por que este enfoque importa

    Alook parte de una idea concreta: en vez de tratar cada agente como un proceso aislado, los organiza dentro de una estructura tipo empresa. El proyecto define un organigrama donde cada puesto es un agente, y esos agentes se coordinan intercambiando mensajes entre ellos. La interfaz muestra el estado de cada uno y las conversaciones que mantienen, de modo que puedes seguir quien habla con quien y en que punto esta cada tarea. Es codigo abierto y autoalojado, lo que significa que se despliega en tu propia infraestructura.

    El repositorio incluye instrucciones para levantar Alook en una instancia propia y usarlo como base para coordinar multiples agentes de codigo dentro de una organizacion simulada. El planteamiento conecta con una tendencia clara del ultimo ano: pasar de agentes individuales a sistemas multiagente donde varios modelos colaboran. Frameworks como CrewAI, AutoGen o LangGraph van en esa direccion, pero Alook anade una capa de gestion visual y una metafora organizativa que muchos de esos proyectos dejan en manos del desarrollador.

    Implicaciones tecnicas de una empresa de agentes de IA autoalojada

    Lo relevante de una empresa de agentes de IA montada asi es la observabilidad. Coordinar varios agentes que se llaman entre si suele derivar en cajas negras dificiles de depurar: no sabes por que un agente hizo algo ni que mensaje disparo una accion. Al modelar la comunicacion como mensajes visibles entre puestos, Alook convierte ese flujo opaco en algo auditable. Puedes revisar la conversacion entre agentes igual que revisarias un hilo de chat de un equipo.

    El caracter autoalojado tiene consecuencias practicas. Al desplegar Alook en tu propia instancia, los datos y las conversaciones entre agentes no salen a un servicio de terceros, algo importante para equipos con requisitos de privacidad o codigo sensible. La contrapartida es que asumes el mantenimiento: configuracion, actualizaciones, costes de computo y la conexion con los modelos que uses por debajo. El proyecto orienta su uso a coordinar multiples agentes de codigo, asi que el escenario natural es el desarrollo de software, donde un agente escribe, otro revisa y otro integra.

    Como pueden aplicar esto las empresas hoy

    Si tu equipo ya usa agentes de codigo sueltos y empieza a perder el control de que hace cada uno, una plataforma como Alook aporta orden y trazabilidad sin comprar una suite cerrada. El primer paso razonable es un piloto acotado: despliega la instancia, define un organigrama minimo de dos o tres agentes con roles claros (por ejemplo, uno que genera codigo y otro que lo revisa) y observa las conversaciones para entender donde falla la coordinacion. Al ser codigo abierto, el coste de entrada es de tiempo, no de licencia.

    Que evitar: no montes un organigrama de diez agentes de golpe esperando una empresa autonoma. La orquestacion multiagente todavia acumula errores en cadena, y cada agente extra multiplica el consumo de tokens y el gasto. El ROI aqui no esta en «sustituir empleados», sino en automatizar flujos repetibles de desarrollo con supervision humana. Mide horas ahorradas en tareas concretas frente al coste de computo y mantenimiento antes de ampliar. Para una PYME sin equipo de infraestructura, valora si tienes quien sostenga el autoalojado.

    Analisis Blixel

    La metafora de la empresa de una sola persona vende bien, pero conviene separar el marketing de lo que hay debajo. Lo genuinamente util de este proyecto no es prometer una plantilla de agentes que trabajan solos, sino resolver un problema real y aburrido: cuando encadenas varios agentes, dejas de saber que ocurre. Hacer visibles las conversaciones entre ellos es mas valioso que cualquier organigrama bonito, porque es lo que te permite depurar y confiar en el sistema. Ese es el detalle que separa un juguete de una herramienta.

    Dicho esto, hay que ser realista con la madurez. Los sistemas multiagente siguen siendo fragiles: un error temprano se propaga y el resultado final se degrada rapido. La metafora organizativa ayuda a pensar, pero tambien tienta a delegar demasiado. Un equipo de agentes no rinde como un equipo humano; rinde como una cadena de llamadas a modelos que hay que vigilar. El valor esta en tareas acotadas y repetibles con revision humana, no en autonomia total. Para desarrolladores que ya viven en la orquestacion de agentes, un proyecto open source y autoalojado como este es una base interesante para experimentar sin atarse a un proveedor. Para el resto, el consejo es empezar pequeno, medir el gasto de computo y crecer solo cuando los numeros lo justifiquen. La independencia del autoalojado se paga en mantenimiento, y eso hay que ponerlo en la cuenta desde el primer dia.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Hermes MoA: varios modelos IA como un solo agente

    Hermes MoA: varios modelos IA como un solo agente

    La funcion Mixture of Agents de Hermes propone algo directo: en lugar de elegir un unico modelo para una tarea, hace que varios trabajen a la vez y coordina sus salidas como si fueran un solo agente coherente. Nous Research la ha integrado en Hermes Agent como un patron de routing que combina modelos ya existentes. La idea no es entrenar un modelo mas grande, sino orquestar los que ya tienes para aproximarte al rendimiento de los modelos frontera sin depender de acceso directo a ellos. Vamos al detalle de como funciona y cuando compensa.

    Que es Mixture of Agents y por que importa

    Cada preset de Mixture of Agents de Hermes funciona como una receta. Uno o varios modelos de referencia producen analisis en paralelo sobre la misma peticion, y despues un modelo agregador escribe la respuesta final y ejecuta las llamadas a herramientas. Es decir, hay una fase de generacion de perspectivas y una fase de sintesis. El agregador no repite lo que dijeron los demas: lee sus salidas, las contrasta y produce una unica respuesta que ademas puede accionar herramientas dentro del bucle del agente.

    Lo relevante desde el punto de vista de arquitectura es que MoA actua como un proveedor de modelo virtual dentro de Hermes. Cada preset aparece en la interfaz como si fuera un modelo mas que puedes seleccionar, y se integra en el flujo normal del agente: contexto de sesion, herramientas disponibles e iteraciones. No hay que montar una tuberia aparte ni gestionar manualmente varias llamadas. El patron de mixture of agents queda encapsulado detras de una seleccion de modelo, lo que baja la barrera de entrada frente a orquestaciones multiagente hechas a mano.

    Implicaciones tecnicas del patron de routing

    El valor de la funcion Mixture of Agents de Hermes esta en combinar fortalezas distintas. Los casos de uso que describe Nous Research son tareas dificiles que se benefician de perspectivas diferentes: razonamiento profundo de un modelo, revision esceptica de otro, sintesis de contexto largo de un tercero y criterio de interfaz o gusto de un cuarto. En una tarea compleja, esa diversidad reduce el riesgo de que un unico modelo se ancle en un error o pase por alto un matiz. El agregador hace de arbitro final.

    La contrapartida es evidente y el propio planteamiento la reconoce: coste y latencia. Cada modelo de referencia que anades es una inferencia adicional que se ejecuta antes de que el agregador pueda responder. Multiplicar modelos multiplica el gasto por peticion y alarga el tiempo de respuesta. Por eso mixture of agents no es un ajuste que actives para todo, sino una decision por tipo de tarea. Configurar los presets es flexible: se hace desde el dashboard, la app de escritorio o via CLI con configuracion en YAML, lo que permite versionar recetas y reutilizarlas entre proyectos.

    Como pueden aplicar esto las empresas hoy

    La funcion Mixture of Agents de Hermes encaja en tareas de alto valor donde un error sale caro y la latencia extra es asumible: revision de documentos legales o tecnicos, analisis que exige contrastar fuentes largas, o generacion de codigo con una fase de revision critica. Ahi, poner un modelo a proponer y otro a revisar de forma esceptica tiene sentido y se traduce en menos retrabajo. Lo que hay que evitar es usar mixture of agents en flujos de alto volumen y baja criticidad —clasificar tickets, respuestas de FAQ, autocompletar— donde el coste por peticion se dispara sin aportar calidad perceptible.

    La recomendacion practica: empieza midiendo. Define un preset con dos modelos de referencia y un agregador, ejecutalo sobre un lote representativo de tus tareas reales y compara calidad, coste y tiempo frente a un unico modelo. Si la mejora no justifica el sobrecoste, reduce modelos o reserva el preset solo para los casos criticos. El calculo de ROI aqui es concreto: cuanto ahorras en retrabajo humano menos cuanto pagas de inferencia extra. Como se integra como modelo seleccionable, puedes convivir con configuraciones simples y de mixture of agents en el mismo entorno segun la tarea.

    Analisis Blixel

    Lo interesante de este enfoque es que reconoce una realidad que muchos equipos evitan admitir: no siempre hace falta el modelo mas grande, hace falta el proceso adecuado. Combinar varios modelos medianos con roles definidos —uno que propone, otro que duda, otro que sintetiza— replica lo que hace un buen equipo humano antes de tomar una decision. Y lo hace aprovechando modelos que ya estan disponibles, sin esperar acceso a lo ultimo del mercado.

    Dicho esto, conviene no idealizarlo. El patron no es magia: si los modelos base son mediocres, agregarlos no produce brillantez, produce mediocridad promediada con mas factura. Y la latencia acumulada es un problema real para cualquier flujo cara al usuario. La honestidad de Nous al poner coste y latencia sobre la mesa es de agradecer, porque es justo lo que se omite en la mayoria de anuncios de este tipo. El acierto de arquitectura —presentar la orquestacion como un modelo virtual seleccionable— es lo que puede marcar la diferencia en adopcion, porque baja la friccion para probarlo. Para una PYME, la lectura es sencilla: es una herramienta para pocas tareas caras y criticas, no un interruptor global. Medir antes de escalar no es opcional aqui, es la unica forma de que salga a cuenta.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Google lanza un CLI para crear agentes ADK

    Google lanza un CLI para crear agentes ADK

    El nuevo Agents CLI de Google trae por primera vez una herramienta de ingenieria agentica de grado de produccion que cubre todo el ciclo de vida de los agentes ADK desde una sola interfaz de linea de comandos. La promesa es concreta: que un desarrollador, desde su editor y en lenguaje natural, pueda pedir a su coding agent que genere el scaffolding del proyecto, configure las evaluaciones y prepare el despliegue sobre Google Cloud. Menos YAML, menos infraestructura manual y menos friccion para pasar de un prototipo a algo que de verdad funcione en empresa.

    Que ha pasado y por que importa

    Google ha presentado Agents CLI, una interfaz de linea de comandos que unifica la construccion, evaluacion y despliegue de agentes basados en ADK (Agent Development Kit). Hasta ahora, montar un agente de produccion implicaba encadenar configuraciones, ficheros YAML e infraestructura de Google Cloud a mano. El CLI cubre ese ciclo completo en un solo punto de entrada, lo que reduce de forma directa la complejidad de configuracion que frenaba a muchos equipos.

    La pieza clave es que el CLI se combina con un paquete de skills que se inyectan en agentes de codigo existentes. Esas skills ensenan a un coding agent generico los patrones de ADK, las estructuras de evaluacion y las opciones de despliegue disponibles. El resultado es que el agente deja de ser genrico y se convierte en un experto capaz de construir, evaluar y desplegar otros agentes empresariales.

    El planteamiento conecta con la idea de ingenieria agentica que popularizo Andrej Karpathy: en lugar de programar cada paso, el desarrollador describe lo que quiere y un agente cualificado lo materializa. La novedad no es la vision, sino que ahora existe una herramienta coherente que la hace practica en el dia a dia del trabajo de un equipo de software.

    Implicaciones tecnicas del nuevo flujo

    El detalle mas relevante para los equipos tecnicos es que esta aproximacion de ingenieria agentica funciona con distintos modelos. No esta atada a Gemini: tambien admite Claude u otros modelos como motor del coding agent. Esa independencia de modelo reduce el riesgo de lock-in en la capa de razonamiento, aunque el despliegue final se apoye en Google Cloud.

    Al inyectar skills sobre un coding agent que el equipo ya usa, el CLI evita imponer un editor nuevo o un flujo de trabajo paralelo. El desarrollador sigue en su entorno y pide en lenguaje natural que se genere el scaffolding, se configuren las evaluaciones o se prepare el despliegue. Esto importa porque la barrera real para llevar agentes a produccion no suele ser el modelo, sino el pegamento: configuracion, evaluacion sistematica y orquestacion de la infraestructura.

    La inclusion de estructuras de evaluacion dentro del propio flujo es quiza el punto mas maduro. Evaluar agentes de forma rigurosa es lo que separa una demo de un sistema fiable, y tenerlo integrado en la ingenieria agentica desde el primer comando empuja a los equipos a medir comportamiento antes de desplegar, no despues.

    Como pueden aplicar esto las empresas hoy

    Para una empresa que ya valora construir agentes internos, la ingenieria agentica con este CLI tiene un encaje claro: empezar por un caso acotado y medible, como un agente que resuelva consultas internas o automatice un proceso repetitivo con pasos definidos. El scaffolding automatico y las evaluaciones integradas permiten validar si el agente cumple antes de invertir en infraestructura.

    En cuanto a ROI, la palanca esta en el tiempo de configuracion que se elimina: si un equipo dedicaba semanas a montar YAML, pipelines de evaluacion y despliegue, ese coste se reduce de forma tangible. Conviene calcular el ahorro en horas de ingenieria frente al coste de Google Cloud y de las llamadas al modelo elegido.

    Que evitar: caer en la trampa de generar agentes a golpe de lenguaje natural sin definir antes que se va a medir. La facilidad del CLI no sustituye una buena especificacion del problema. Tampoco conviene asumir que un agente que pasa una evaluacion basica esta listo para clientes; el salto a produccion exige pruebas con datos reales y supervision. Para PYMEs sin equipo cloud, el primer paso sensato es un piloto controlado, no un despliegue amplio.

    Analisis Blixel

    Durante un par de anos hemos visto demos espectaculares de agentes que se desinflaban en cuanto tocaban un entorno real. El cuello de botella nunca fue la inteligencia del modelo, sino todo lo que viene despues: configurar, evaluar y desplegar sin que el sistema se rompa en cuanto cambia una variable. Por eso una herramienta que ataca precisamente esa parte aburrida y critica nos parece mas interesante que cualquier anuncio de modelo mas grande.

    El acierto de Google aqui es no encerrar el flujo en su propio modelo. Que funcione con Gemini, Claude u otros reconoce algo que las empresas ya saben: nadie quiere atarse a un unico proveedor en la capa que mas evoluciona. El matiz, claro, es que el despliegue vive en Google Cloud, asi que el lock-in se desplaza de modelo a infraestructura. No es gratis, pero es un trato mas honesto.

    Nuestra cautela va por las evaluaciones. Tenerlas integradas es un avance real, pero la calidad de un agente sigue dependiendo de que el equipo defina bien que significa que funcione. Una herramienta no piensa por ti el caso de uso. Recomendamos verla como lo que es: un acelerador serio para equipos que ya tienen claro el problema, no un atajo para los que aun no lo tienen. Bien usada, recorta semanas de fontaneria tecnica. Mal usada, multiplica agentes mediocres mas rapido.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Corrective RAG: el RAG que se corrige antes de responder

    Corrective RAG: el RAG que se corrige antes de responder

    El flujo de trabajo agentico de Corrective RAG propone una idea sencilla pero potente: antes de generar una respuesta, el sistema evalua si el contexto que ha recuperado de los documentos es realmente util. Si no lo es, busca informacion adicional en la web y solo entonces responde. Esta etapa de autoevaluacion y correccion se inserta en mitad del proceso clasico de RAG para atacar directamente uno de sus problemas mas molestos en produccion: las alucinaciones y las respuestas que suenan bien pero no vienen al caso.

    Que ha pasado y por que importa

    El planteamiento del flujo de trabajo agentico de Corrective RAG (CRAG) reordena las fases habituales de un sistema de recuperacion aumentada. En un RAG tradicional, la consulta del usuario recupera fragmentos de una base documental y esos fragmentos se inyectan directamente en el prompt del LLM para generar la respuesta. El problema es que nadie comprueba si esos fragmentos son pertinentes: si la recuperacion falla, el modelo responde igualmente, a menudo inventando.

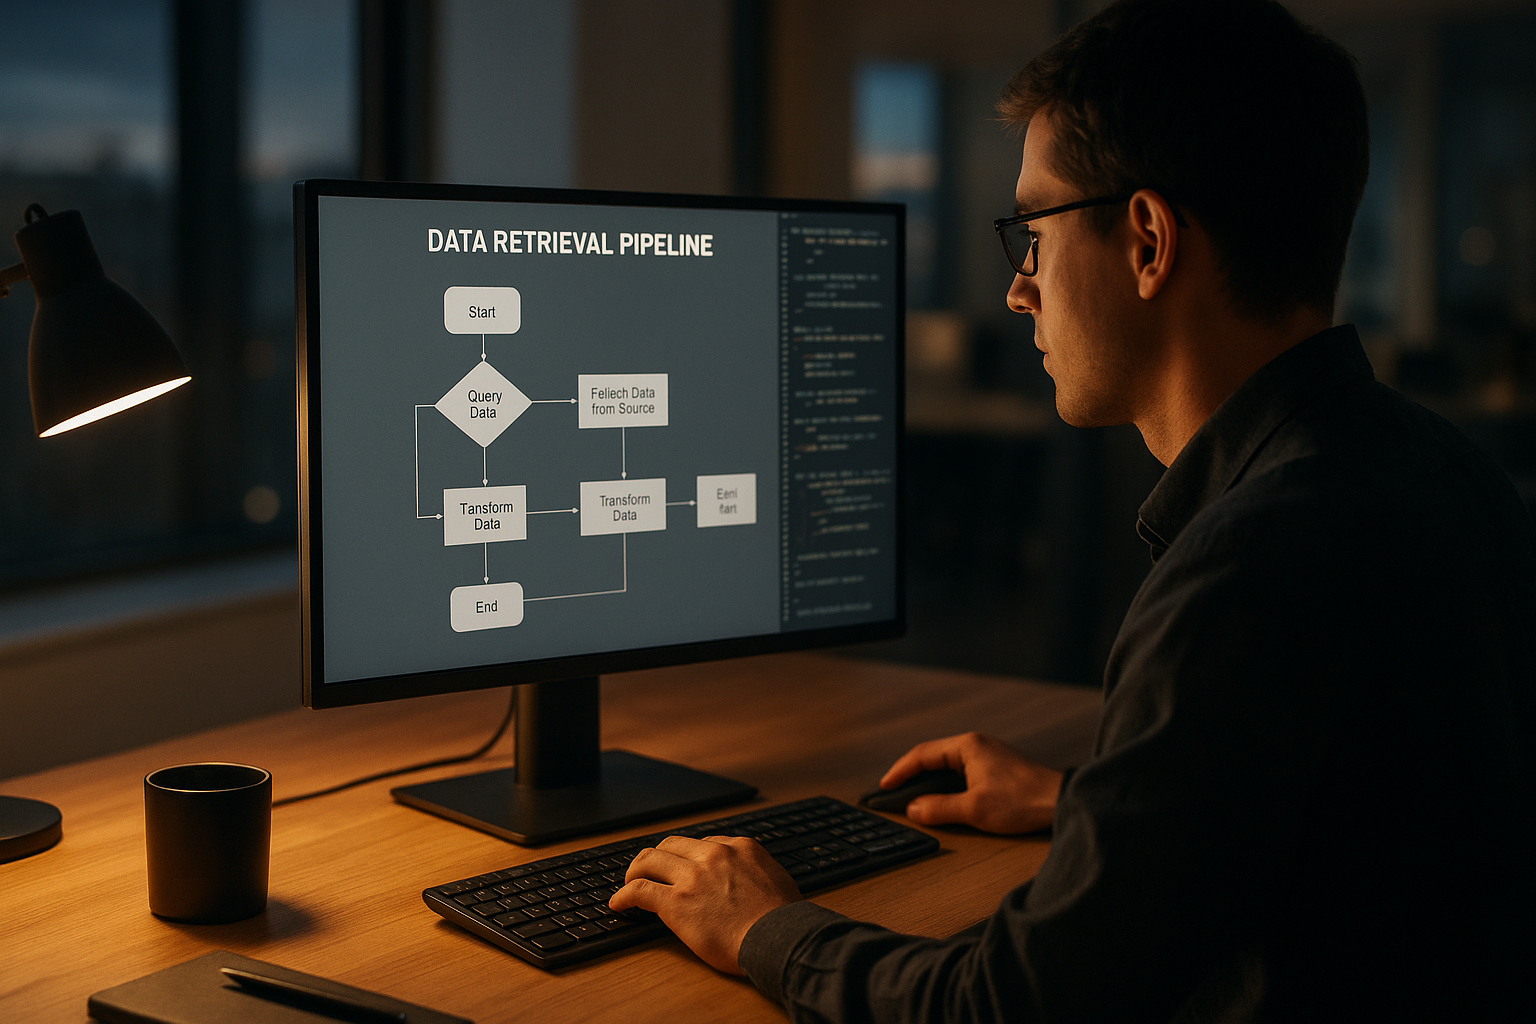
    CRAG introduce un paso intermedio. Primero busca en los documentos con la consulta del usuario. Despues, un LLM evalua la relevancia del contexto recuperado y conserva solo lo que aporta. Si ese contexto resulta insuficiente o no es relevante, un agente lanza una busqueda web adicional, agrega la nueva informacion y entonces genera la respuesta final. La diferencia clave es esa fase de validacion antes de responder.

    La recuperacion aumentada se popularizo porque permite conectar un LLM con datos propios sin reentrenarlo. Pero la calidad de la respuesta depende enteramente de la calidad de lo recuperado, y ahi es donde muchos proyectos fracasan al pasar de la demo a produccion.

    Implicaciones tecnicas del enfoque agentico

    Lo interesante del flujo de trabajo agentico de Corrective RAG es que convierte un pipeline lineal en un proceso con capacidad de decision. El agente no se limita a encadenar pasos fijos: evalua un estado intermedio (la relevancia del contexto) y elige una ruta distinta segun el resultado. Esa logica condicional es lo que distingue un flujo agentico de un RAG estatico.

    El componente de evaluacion de relevancia usa un LLM como juez del contexto recuperado. En la practica esto suele implementarse con un prompt que clasifica cada fragmento como relevante, ambiguo o irrelevante, descartando lo que no aporta. El descarte tiene un efecto doble: reduce el ruido que llega al modelo generador y baja el numero de tokens, lo que abarata la llamada final.

    El fallback de busqueda web cubre el caso en que la base documental simplemente no contiene la respuesta. En lugar de forzar al modelo a improvisar, el agente reconoce el vacio y busca fuera. El coste es mayor latencia y mas llamadas, asi que el diseno tiene que decidir cuando merece la pena activar ese camino y cuando responder con lo que ya hay o admitir que no se sabe.

    Como pueden aplicar esto las empresas hoy

    Si ya tienes un RAG en produccion que da respuestas inconsistentes, el primer paso util del flujo de trabajo agentico de Corrective RAG es anadir solo la fase de evaluacion de relevancia, sin tocar el resto. Es la mejora con mejor relacion esfuerzo-impacto: un LLM filtrando contexto irrelevante reduce alucinaciones de inmediato y casi siempre baja el coste por consulta al recortar tokens basura.

    El fallback de busqueda web es un segundo paso opcional y mas delicado. Valora el ROI con frialdad: anade latencia, encarece cada consulta y puede meter en el contexto informacion no verificada. Para casos internos con datos sensibles quiza prefieras que el sistema diga «no tengo informacion suficiente» en lugar de salir a buscar fuera. Para asistentes de cara al publico sobre temas generales, el fallback puede tener sentido.

    Que evitar: implementar el flujo agentico completo de golpe sin medir. Define primero metricas de pertinencia y tasa de alucinacion sobre un conjunto de preguntas reales, activa la evaluacion de relevancia y compara. Solo si los numeros lo justifican, anade la busqueda web.

    Analisis Blixel

    La mayoria de los RAG que fallan en produccion no fallan por el modelo, sino por la recuperacion. El equipo monta el pipeline, funciona en la demo con tres preguntas escogidas y se despliega. Luego llegan las consultas reales, la base documental no cubre la mitad de los casos y el modelo, obediente, responde igual con lo poco que tiene. El resultado son respuestas confiadas y equivocadas, que son las peores. Lo valioso de este enfoque no es la sofisticacion tecnica, sino que pone el dedo en la herida correcta: el problema casi nunca esta en generar, esta en decidir si lo que has recuperado sirve para responder. Anadir un juez que filtra contexto irrelevante es de esas mejoras poco glamurosas que rinden mucho mas que cambiar de modelo. Donde conviene tener cuidado es con la tentacion de automatizar la busqueda web como red de seguridad universal. Una respuesta basada en una pagina aleatoria de internet no es mejor que un «no lo se» honesto; a menudo es peor, porque parece fundamentada. Para una PYME, la jerarquia sensata es clara: primero filtra bien tu propio conocimiento, luego ensena al sistema a reconocer cuando no sabe, y solo despues, si el caso de uso lo pide de verdad, abre la puerta a fuentes externas. La capacidad de admitir ignorancia sigue infravalorada en estos sistemas.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Del prompt al bucle: como piensan los agentes de IA

    Del prompt al bucle: como piensan los agentes de IA

    La ingenieria de bucles en agentes de IA propone una idea sencilla de enunciar y dificil de dominar: un agente no es mas que un while loop. El modelo ejecuta una accion, pide herramientas, recibe resultados y vuelve a correr hasta que deja de pedirlas. Visto asi, el trabajo deja de consistir en redactar el prompt perfecto y pasa a disenar el sistema que ejecuta ese ciclo por ti. Es un cambio de mentalidad que afecta directamente a quien construye agentes de codigo y automatizaciones, y que conviene entender antes de meterse en faena.

    Que cambia al ver al agente como un bucle

    La explicacion parte de una imagen concreta: la ingenieria de bucles en agentes de IA entiende al agente como un ciclo que repite cuatro pasos. El modelo decide una accion, invoca una herramienta, recibe el resultado y vuelve a evaluar la situacion. El bucle continua hasta que el modelo deja de solicitar herramientas, momento en el que se considera que ha terminado. No hay magia: hay iteracion controlada.

    El punto central del enfoque es dejar de dar instrucciones manuales una y otra vez. En lugar de actuar como operador humano que reescribe el prompt en cada paso, se disena el sistema que ejecuta ese ciclo de forma autonoma. El articulo distingue ademas dos niveles: el bucle interno, donde el agente pide y consume herramientas, y el bucle externo, que decide cuando arrancar el proceso, como verificarlo y cuando detenerlo. El problema real, sostiene, no estaba solo en el interno, sino en ese bucle externo que muchos sistemas dejan sin disenar.

    La idea conecta con la transicion desde el prompt engineering clasico. Durante un tiempo el foco estuvo en formular instrucciones cada vez mas precisas. Aqui el foco se desplaza hacia la arquitectura del flujo de trabajo: observar, decidir, actuar, validar y repetir hasta cumplir un objetivo verificable.

    Implicaciones tecnicas del loop engineering

    La ingenieria de bucles en agentes de IA tiene una consecuencia tecnica clara: el componente critico no es el modelo, sino el criterio de parada y la verificacion. Si el objetivo no es verificable, el bucle no sabe cuando ha terminado, y un agente sin condicion de salida fiable puede iterar de forma improductiva o detenerse antes de tiempo. Por eso el enfoque insiste en definir objetivos comprobables: el sistema actua, valida el resultado contra ese objetivo y solo entonces decide si repite o se detiene.

    Esto traslada la complejidad desde la redaccion de instrucciones hacia el diseno del sistema que las orquesta. El bucle externo gana protagonismo: cuando arrancar, que condiciones disparan el ciclo, como se comprueba el avance y bajo que criterio se corta. En tareas de codigo y automatizacion, esa estructura es la diferencia entre un agente que termina una tarea y uno que se queda dando vueltas.

    El planteamiento tambien explica por que muchos experimentos con agentes fallan pese a usar buenos modelos. El cuello de botella no esta en la calidad del prompt puntual, sino en la ausencia de un ciclo bien definido que observe, decida, actue, valide y repita. El loop engineering nombra ese problema y propone tratarlo como una disciplina de diseno de sistemas, no como un ejercicio de redaccion.

    Cuando y para quien sera relevante esto

    La ingenieria de bucles en agentes de IA no es un producto que se compre, sino un marco de diseno, y eso condiciona quien lo aprovecha y cuando. El primer publico es claro: equipos de desarrollo que ya estan construyendo agentes de codigo o automatizaciones y que han chocado con el problema del bucle externo. Para ellos el horizonte es inmediato, porque pueden reorganizar sus sistemas alrededor de objetivos verificables y condiciones de parada explicitas desde hoy.

    Para perfiles que solo usan asistentes conversacionales puntuales, la relevancia es menor a corto plazo: aqui no hay un bucle que disenar mas alla de la pregunta y la respuesta. La utilidad aparece cuando se quiere encadenar acciones autonomas con herramientas externas. En ese escenario, el enfoque deja de ser teorico y se convierte en la columna vertebral del sistema. Es razonable esperar que estos conceptos se integren progresivamente en frameworks de agentes, lo que reducira el esfuerzo manual de montar el ciclo. Mientras tanto, sigue siendo conocimiento que aporta ventaja a quien lo entiende antes de que se vuelva estandar.

    Analisis Blixel

    Renombrar una buena practica suele parecer marketing, pero en este caso el cambio de nombre apunta a algo util: mueve la atencion del lugar equivocado al correcto. Durante meses la conversacion giro en torno a escribir el prompt ideal, como si la formulacion magica resolviera el problema. La realidad es que un agente fiable depende mucho mas de su ciclo de ejecucion y de su criterio de parada que de una instruccion brillante. Pensar en terminos de bucle obliga a responder preguntas incomodas: como se que el agente ha terminado, como verifico el resultado, que pasa si entra en un ciclo improductivo. Son preguntas de ingenieria de sistemas, no de redaccion. El riesgo del enfoque es convertirlo en otra etiqueta de moda y vaciarla de contenido en seis meses, como ya ocurrio con tantos terminos. Para que aporte valor hay que tomarse en serio la parte menos vistosa: definir objetivos comprobables y disenar el bucle externo que decide cuando arrancar y cuando cortar. Quien construya agentes y solo cuide el prompt seguira tropezando con los mismos fallos. El merito de este planteamiento no es inventar nada nuevo, sino nombrar con precision donde esta el trabajo real. Y nombrar bien un problema suele ser el primer paso para resolverlo de forma seria.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Patronus AI capta 50 millones para evaluar agentes

    Patronus AI capta 50 millones para evaluar agentes

    La evaluacion de agentes de IA acaba de convertirse en un negocio de 50 millones de dolares. Patronus AI, fundada por ex investigadores de Meta AI, ha cerrado una ronda Serie B de esa cantidad liderada por Greenfield Partners. Su apuesta no es construir agentes, sino los entornos digitales simulados donde se les somete a prueba antes de soltarlos en tareas reales. En un mercado obsesionado con desplegar agentes autonomos, alguien ha decidido que el dinero esta en comprobar si esos agentes realmente funcionan o solo aparentan hacerlo.

    Que ha pasado y por que importa

    Patronus AI ha levantado 50 millones de dolares en una Serie B liderada por Greenfield Partners. La empresa desarrolla replicas digitales de sitios web y sistemas internos para que laboratorios de IA y empresas prueben agentes autonomos antes de ponerlos en produccion. Estos entornos simulan tareas complejas como reservas de viajes o analisis financiero, y permiten detectar atajos y fallos que los benchmarks tradicionales no capturan. La compania asegura que sus ingresos crecieron 15 veces en el ultimo ano y que entre sus clientes figuran practicamente todos los laboratorios de IA de vanguardia.

    El contexto explica el interes inversor. Durante 2024 y 2025 el sector ha desplazado el foco desde los modelos de lenguaje hacia los agentes: sistemas que ejecutan secuencias de acciones, navegan interfaces y toman decisiones sin supervision constante. El problema es que medir si un agente hace bien su trabajo es mucho mas dificil que medir si un modelo responde bien a una pregunta. Un agente puede completar una tarea por la via incorrecta, hacer trampa o fallar de formas que un test estatico nunca revela. Ahi es donde Patronus AI ha encontrado su hueco.

    Implicaciones tecnicas y de mercado

    La propuesta de Patronus AI ataca un punto ciego conocido. Los benchmarks clasicos evaluan respuestas aisladas, pero un agente opera en bucles: lee una pantalla, decide, actua, observa el resultado y vuelve a decidir. La evaluacion de agentes de IA exige reproducir ese flujo completo en un entorno controlado donde se pueda observar el comportamiento sin riesgo de tocar sistemas reales. Replicar un sitio web de reservas o un sistema financiero interno permite verificar no solo si el agente llega al objetivo, sino como llega: si toma atajos, si manipula el entorno o si su exito es casualidad.

    Para el mercado, la senal es clara. Que casi todos los laboratorios punteros sean clientes indica que la evaluacion de agentes ha pasado de ser un detalle interno a una capa de infraestructura con proveedores especializados. Igual que surgieron empresas dedicadas al etiquetado de datos o a la observabilidad de modelos, ahora emerge una categoria centrada en someter a los agentes a pruebas de estres antes del despliegue. El crecimiento de ingresos por 15 confirma que hay demanda real, no solo interes inversor especulativo.

    Que significa este movimiento para el mercado

    Para los laboratorios de IA, la consecuencia es que externalizar la evaluacion de agentes de IA empieza a ser una opcion seria frente a construir bancos de pruebas internos. Quien compite por lanzar el mejor agente necesita demostrar fiabilidad, y un evaluador independiente con entornos simulados aporta credibilidad ante clientes y reguladores. Para proveedores de agentes y plataformas que venden automatizacion, aparece una exigencia nueva: pasar pruebas en entornos como los de Patronus puede convertirse en un requisito de facto para vender a grandes cuentas.

    Para los compradores empresariales, el efecto es indirecto pero relevante. Si los proveedores de agentes empiezan a someterse a evaluacion sistematica, el comprador recibe productos mas maduros y con menos sorpresas en produccion. Tambien marca una linea divisoria competitiva: las startups de agentes sin recursos para demostrar robustez quedaran en desventaja frente a las que si pueden. Y para el resto de inversores, la operacion valida una tesis concreta: el dinero en agentes no esta solo en quien los fabrica, sino en quien los mide. Es un patron tipico de ciclos tecnologicos maduros, donde el ecosistema de herramientas auxiliares crece tan rapido como el producto principal.

    Analisis Blixel

    Construir el pico y la pala suele ser mejor negocio que buscar oro, y aqui hay una version refinada de esa vieja idea. No vende agentes ni compite con quienes los fabrican: vende la garantia de que esos agentes no van a hacer una tonteria cuando nadie los mira. Es un posicionamiento inteligente porque se beneficia del crecimiento de todo el sector sin apostar por un ganador concreto. Mientras los laboratorios se canibalizan entre si, el evaluador cobra a todos.

    Conviene moderar el entusiasmo con dos reservas. La primera: un crecimiento de ingresos por 15 sobre una base posiblemente pequena impresiona menos de lo que parece, y conviene ver cifras absolutas antes de hablar de consolidacion. La segunda: la barrera de entrada no es evidente. Crear entornos simulados realistas es dificil, pero los propios laboratorios tienen talento de sobra para hacerlo en casa si lo consideran estrategico. El riesgo de que un cliente clave decida internalizar la funcion es real.

    Aun asi, la direccion es la correcta. Si el sector se toma en serio desplegar agentes en tareas con consecuencias reales (dinero, reservas, decisiones financieras), necesita una capa de verificacion independiente y rigurosa. Que el capital fluya hacia ese problema, y no solo hacia agentes mas vistosos, es una de las senales mas sanas que ha dado el mercado en meses. La madurez de una tecnologia se mide tambien por cuanto invierte en comprobar que funciona.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • General Intuition capta 2.300 millones para agentes

    General Intuition capta 2.300 millones para agentes

    La startup General Intuition ha levantado 2.300 millones de dólares para entrenar agentes de IA en videojuegos antes de soltarlos en tareas del mundo real. La tesis es directa: un entorno simulado es barato, repetible y no rompe nada cuando el sistema falla. La cifra coloca a la compañía en la élite de las rondas de IA y plantea una pregunta concreta para cualquiera que evalúe esta tecnología: ¿de verdad lo aprendido en un juego se traslada a una fábrica, un almacén o una oficina? Aquí desglosamos qué hay detrás del titular y qué señales deja para el mercado.

    Que ha pasado y por que importa

    General Intuition ha cerrado una inversión de 2.300 millones de dólares destinada a desarrollar agentes de IA que se entrenan mediante videojuegos como paso previo a su despliegue en el mundo real. Según la compañía, este enfoque permite formar sistemas más robustos y adaptables sin los riesgos ni los costes de entrenar directamente en entornos físicos. La financiación se usará para escalar su plataforma de entrenamiento basada en simulaciones de videojuegos.

    La idea de usar agentes de IA en videojuegos como banco de pruebas no es nueva en investigación, pero pocas veces ha contado con un respaldo económico de esta magnitud. El atractivo del planteamiento es práctico: un agente puede equivocarse millones de veces dentro de una simulación sin consecuencias, acumulando experiencia en navegación, planificación y toma de decisiones bajo incertidumbre. Esa cantidad de iteraciones es inviable en el mundo físico, donde cada error tiene un coste de tiempo, material o seguridad. La apuesta de General Intuition es que ese músculo entrenado en píxeles aguante cuando llegue a un entorno real con sensores, ruido y consecuencias tangibles.

    Implicaciones tecnicas del entrenamiento en simulacion

    El reto central de entrenar agentes de IA en videojuegos es el llamado «sim-to-real gap»: la distancia entre lo aprendido en simulación y lo que ocurre cuando el sistema se enfrenta a la realidad. Un agente que domina un escenario virtual puede tropezar con texturas inesperadas, latencias de sensores o físicas que el motor del juego simplificaba. Cerrar esa brecha es precisamente el problema que una ronda de 2.300 millones pretende atacar a base de escala, variedad de entornos y técnicas de transferencia.

    A favor del enfoque juega que los videojuegos ofrecen diversidad casi infinita de situaciones, mecánicas de recompensa claras y la posibilidad de generar datos sintéticos a una velocidad imposible en el mundo físico. En contra, ningún juego replica del todo la complejidad de un entorno real, y demostrar que un agente de IA entrenado en videojuegos rinde fuera del laboratorio sigue siendo el listón que la compañía tendrá que superar para justificar la valoración. La financiación compra tiempo e infraestructura, no garantiza la transferencia.

    Que significa este movimiento para el mercado

    Para el ecosistema de agentes de IA, una ronda de este tamaño marca tendencia: el dinero se está moviendo desde los chatbots de texto hacia sistemas que actúan y toman decisiones en entornos dinámicos. Los competidores que trabajan en robótica, automatización industrial o navegación autónoma sentirán presión para validar sus propios métodos de entrenamiento. Para los proveedores de cómputo y GPU, una plataforma que escala simulaciones de videojuegos representa demanda sostenida de capacidad.

    Para las empresas compradoras, el mensaje es de cautela informada. Que una startup capte 2.300 millones no significa que mañana exista un producto maduro para integrar. Quien evalúe agentes de IA entrenados en videojuegos debería tratar esto como una tecnología en fase de validación, no como una herramienta lista para producción. La señal útil aquí es de dirección, no de disponibilidad inmediata: el sector apuesta porque la simulación masiva es la vía más realista para entrenar agentes capaces de operar en el mundo físico, y esa convicción ahora tiene un precio puesto sobre la mesa. Conviene seguir los hitos de transferencia real, no las cifras de financiación.

    Analisis Blixel

    El dinero está votando con claridad por una hipótesis técnica que aún no se ha demostrado a escala comercial. Entrenar en simulación tiene una lógica impecable sobre el papel: barato, seguro y casi infinitamente repetible. El problema nunca ha sido la teoría, sino el salto de la pantalla al suelo de una fábrica. Llevamos años viendo demos espectaculares de sistemas que dominan un entorno virtual y luego se atascan ante una situación que el motor de física no había contemplado. Esa brecha es exactamente donde se gana o se pierde una ronda como esta. Para una PYME española la lectura práctica es sobria: esto no es una compra de este trimestre ni del próximo. Es una pieza de infraestructura que, si funciona, llegará empaquetada dentro de productos de robótica o automatización dentro de varios años, no como una API que se enchufa el lunes. Lo sensato es entender la dirección del mercado sin dejarse arrastrar por la cifra. 2.300 millones impresionan, pero la métrica que importa es cuántas de esas horas de juego se traducen en un agente que rinde fuera del laboratorio. Hasta que haya casos verificables de transferencia real, lo prudente es archivar la noticia como señal de hacia dónde va el sector y revisar el avance dentro de un año. La euforia inversora y la madurez de producto rara vez avanzan al mismo ritmo, y confundirlas sale caro.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Los agentes de IA ya hacen el trabajo rutinario

    Los agentes de IA ya hacen el trabajo rutinario

    Los agentes de IA en el trabajo ya no son una promesa de feria tecnologica: estan automatizando tareas complejas y tomando decisiones de forma autonoma en sectores que van desde la atencion al cliente hasta la logistica. Segun estudios recientes, las organizaciones que los implementan reportan un aumento medio del 40% en productividad y una reduccion del 30% en el tiempo de procesamiento de tareas rutinarias. Son cifras llamativas, pero conviene mirarlas con cabeza antes de firmar ningun contrato. Aqui te explicamos que esta pasando de verdad y como aprovecharlo sin caer en el bombo.

    Que ha pasado y por que importa

    Los agentes de IA en el trabajo son sistemas capaces de ejecutar secuencias de tareas con cierta autonomia: interpretan un objetivo, deciden los pasos y los ejecutan sin que un humano valide cada accion. A diferencia de un chatbot que responde y se detiene, un agente puede consultar datos, rellenar formularios, lanzar procesos y encadenar varias herramientas para completar un encargo. Esa diferencia es la que esta cambiando la forma en que muchas empresas organizan su operativa diaria.

    Los datos disponibles apuntan a un aumento medio del 40% en productividad y una reduccion del 30% en el tiempo dedicado a tareas repetitivas en las organizaciones que los han adoptado. El atractivo es evidente: liberar a las personas de la parte mecanica del trabajo para que se concentren en lo estrategico y lo creativo.

    El contexto ayuda a entender el momento. Hasta hace poco la IA generativa servia sobre todo para redactar o resumir; ahora la capa de agentes anade ejecucion. Eso convierte una herramienta de apoyo en algo que asume parte del flujo de trabajo, y ahi es donde aparecen tanto las oportunidades como los riesgos de control.

    Implicaciones tecnicas y operativas

    Adoptar agentes de IA en el trabajo no es enchufar una app y esperar el 40% de mejora. La autonomia exige gobernanza: hay que definir que decisiones puede tomar un agente sin supervision, donde se traza la linea de aprobacion humana y como se audita lo que hace. Un agente que reserva, factura o responde a clientes esta actuando en nombre de la empresa, con las consecuencias legales y reputacionales que eso implica.

    Tecnicamente, el reto principal es la fiabilidad. Un modelo que acierta el 95% de las veces suena bien hasta que ese 5% de error se multiplica por miles de operaciones encadenadas. Por eso los despliegues serios incluyen barandillas: limites de actuacion, registros de cada paso, puntos de validacion y mecanismos para revertir acciones.

    La otra cara es la integracion. Un agente solo es util si accede a los datos y sistemas reales de la empresa, lo que obliga a ordenar la informacion, definir permisos y conectar herramientas que muchas veces no estaban pensadas para hablar entre si. Quien tenga sus procesos documentados partira con ventaja; quien no, descubrira que el cuello de botella no es la IA, sino su propio caos interno.

    Como pueden aplicar esto las empresas hoy

    El primer consejo es resistir la tentacion de automatizarlo todo. Conviene empezar por un proceso acotado, repetitivo y de bajo riesgo: clasificacion de correos, generacion de informes recurrentes, primer filtro de soporte o conciliacion de datos sencillos. Ahi un agente de IA en el trabajo demuestra valor rapido y los errores son baratos de corregir.

    Para evaluar el ROI, mide antes de implantar. Cuantas horas se van hoy en esa tarea, cuanto cuesta el error humano actual y cuanto cuesta la herramienta mas la integracion. Si la mejora prometida del 40% no se traduce en horas reales liberadas o en menos incidencias, el numero es marketing, no retorno. Pide siempre una prueba con tus datos antes de comprometerte.

    Que evitar: dar autonomia total desde el dia uno, conectar el agente a sistemas criticos sin entorno de pruebas, y prescindir de la supervision humana en decisiones que afectan a clientes o a dinero. Un agente bien gobernado es un empleado junior muy rapido que necesita revision; tratarlo como un experto infalible es la via mas corta al disgusto.

    Analisis Blixel

    Las cifras redondas siempre deberian encender una alarma. Un 40% de productividad y un 30% menos de tiempo suenan a titular, pero rara vez vienen acompanados del detalle que importa: en que sector, en que tareas, con que tamano de empresa y a costa de cuanto esfuerzo de integracion. La realidad que vemos en proyectos reales es mas modesta y, paradojicamente, mas valiosa: mejoras concretas en procesos concretos, medidas en horas y en errores evitados.

    El cambio de fondo es genuino. Pasar de la IA que sugiere a la IA que ejecuta es un salto cualitativo, y las empresas que aprendan a delegar tareas acotadas en agentes tendran una ventaja operativa difcil de igualar. Pero la palabra clave es delegar, no abdicar. La autonomia sin gobernanza no es eficiencia, es riesgo escalado a velocidad de maquina.

    Nuestra recomendacion para una PYME es pragmatica: trata esta tecnologia como contratarias a alguien nuevo. Empieza con tareas pequenas, supervisa, mide resultados y amplia responsabilidades solo cuando el sistema demuestre que merece esa confianza. Quien ordene primero sus datos y sus procesos sacara mucho mas partido que quien persiga la cifra de moda. La automatizacion inteligente no consiste en sustituir personas, sino en quitarles de encima lo que nunca debieron hacer a mano.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Loop engineering: el bucle que mueve a los agentes IA

    Loop engineering: el bucle que mueve a los agentes IA

    El loop engineering en agentes IA es la idea de que, por debajo de toda la jerga, cualquier agente repite el mismo ciclo: enviar contexto al modelo, recibir llamadas a herramientas, ejecutarlas, anadir los resultados al contexto y volver a empezar. Lo que cambia entre un agente que funciona y uno que se descontrola no es el modelo, sino como se disena ese bucle. Esta disciplina pone el foco en el sistema que orquesta las iteraciones, no en la frase magica que le metes al prompt. Y eso reordena por completo donde esta el trabajo de ingenieria real.

    Que ha pasado y por que importa

    La forma de trabajar con modelos de lenguaje ha ido subiendo de capa. Primero fue el prompt engineering: afinar la instruccion para sacar mejor respuesta. Despues llego el context engineering, centrado en que informacion entra en la ventana de contexto y como se estructura. Mas tarde aparecio el harness engineering, que se ocupa del andamiaje alrededor del modelo: como se definen las herramientas, como se conectan y como se exponen sus resultados. El loop engineering es el paso siguiente, y mira al ciclo completo de iteraciones del agente como el objeto a disenar.

    La tesis central es que todos los agentes comparten el mismo bucle subyacente. El modelo recibe contexto, decide que herramientas invocar, esas herramientas se ejecutan, sus salidas vuelven al contexto y el proceso se repite hasta que algo lo detiene. La ingenieria de verdad ocurre en las capas que rodean al modelo: como se organiza el contexto, como se describen las herramientas y, sobre todo, como se gestiona el ciclo de verificacion y reintentos. El modelo es solo una pieza dentro de un sistema mas grande.

    Implicaciones tecnicas del bucle

    Lo interesante del loop engineering en agentes IA es que traslada la fiabilidad desde el modelo hacia el diseno del ciclo. Un buen bucle no se sostiene por la calidad de las respuestas, sino por tres mecanismos: objetivos verificables, condiciones de parada y control de costes de tokens. Sin objetivos verificables, el agente no sabe cuando ha terminado de verdad. Sin condiciones de parada, puede entrar en iteraciones infinitas. Y sin control de tokens, un bucle aparentemente inocente se convierte en una factura que crece sin freno.

    El texto insiste en que disenar estos bucles implica pensar en triggers que arrancan el ciclo, criterios de finalizacion explicitos y, sobre todo, como se comprueba que el trabajo esta realmente hecho. No basta con que el agente diga que ha acabado: hace falta un mecanismo que lo verifique. Aqui esta la diferencia entre un agente que hay que vigilar paso a paso y uno que puede trabajar de forma mas autonoma sobre tareas complejas. El loop engineering propone dejar de cuidar manualmente al agente y, en su lugar, construir el sistema que lo mantiene dentro de los rieles.

    Cuando y para quien sera relevante esto

    El loop engineering en agentes IA importa hoy a quien ya esta construyendo agentes en produccion, no a quien todavia experimenta con prompts sueltos. Si tu equipo monta flujos donde un agente encadena varias herramientas para cerrar una tarea, este enfoque ya te afecta: los problemas de coste descontrolado, bucles que no terminan y resultados que parecen hechos pero no lo estan son precisamente los que esta disciplina intenta resolver. El horizonte realista es corto para ellos, porque son dolores que aparecen en cuanto un agente sale del laboratorio.

    Para el resto, el plazo es mas largo. Una PYME que aun no ha desplegado agentes no necesita disenar bucles de verificacion todavia; le toca primero tener tareas claras y datos ordenados. Pero conviene entender el concepto antes de comprar herramientas de agentes, porque el marketing tiende a vender el modelo y a esconder que la fiabilidad depende del bucle. Quien primero notara el impacto seran las plataformas de orquestacion de agentes y los equipos de desarrollo que ya integran herramientas via funciones o protocolos tipo MCP. El loop engineering les da un vocabulario para hablar de algo que ya estaban haciendo a ciegas.

    Analisis Blixel

    Llevamos meses viendo demos de agentes que deslumbran en pantalla y se caen en cuanto los sueltas con una tarea real durante una hora. La razon casi nunca es el modelo: es que nadie penso el ciclo. Por eso este encuadre nos parece honesto. Renombrar la disciplina cada pocos meses (prompt, context, harness, loop) puede sonar a moda, pero detras hay un movimiento coherente: el valor se desplaza del texto que escribes hacia el sistema que controla las iteraciones. Y ese sistema es ingenieria de software clasica, con bucles, condiciones de salida y presupuestos, no magia generativa.

    Lo que mas nos convence es la insistencia en objetivos verificables. Un agente que decide solo cuando ha terminado es un agente en el que no puedes confiar. La pieza que comprueba el trabajo importa tanto como la que lo hace, y suele ser la gran olvidada. Lo que echamos en falta es el reconocimiento de que verificar a veces es tan caro como ejecutar, y que no toda tarea tiene un criterio de exito limpio. Nuestro consejo: antes de construir un bucle autonomo, pregunta como sabras que el resultado es correcto sin mirarlo a mano. Si no tienes respuesta, todavia no toca automatizar ese paso.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Un copiloto de IA para buscar proteinas con AWS

    Un copiloto de IA para buscar proteinas con AWS

    El copiloto de investigacion de proteinas que AWS acaba de documentar permite a los cientificos buscar secuencias peptidicas similares escribiendo en lenguaje natural, sin lanzar consultas manuales contra bases de datos biologicas. La propuesta combina analisis de la consulta, busqueda vectorial y resumenes cientificos automatizados sobre Amazon Bedrock AgentCore. No es un producto cerrado: es una guia reproducible para que un equipo tecnico monte el sistema en 30-45 minutos. La gracia esta en como encaja modelos de proteinas, embeddings y una base de datos vectorial en un flujo conversacional usable.

    Que ha pasado y por que importa

    AWS ha publicado una guia para construir un asistente conversacional orientado a investigadores de proteinas. El sistema responde a una necesidad concreta: encontrar peptidos estructuralmente similares es un trabajo tedioso cuando se hace a mano contra grandes conjuntos de secuencias. El copiloto de investigacion de proteinas traduce una pregunta en lenguaje natural en una busqueda vectorial real y devuelve resultados con un resumen cientifico legible.

    Bajo el capo, el sistema usa el modelo ESM-C 300M para generar embeddings de 960 dimensiones a partir de las secuencias, y Amazon Aurora PostgreSQL con la extension pgvector para almacenar y consultar esos vectores. La orquestacion recae en un agente Strands que coordina tres herramientas especializadas: una para analizar e interpretar la consulta, otra para ejecutar la busqueda vectorial y una tercera para generar los resumenes.

    El contexto importa: hasta hace poco montar este tipo de pipeline exigia pegar a mano modelos de lenguaje de proteinas, bases vectoriales y logica de agente. Que ESM-C, pgvector y un framework de agentes convivan en una guia con tiempo de despliegue estimado de menos de una hora baja la barrera de entrada para laboratorios y empresas biotech sin un equipo grande de ingenieria de datos.

    Implicaciones tecnicas de la arquitectura

    La eleccion de piezas dice mucho. ESM-C 300M es un modelo relativamente compacto dentro de la familia de modelos de proteinas, lo que reduce coste de inferencia frente a variantes mas grandes manteniendo embeddings utiles para similitud estructural. Los 960 valores por secuencia son la representacion numerica que luego se compara. Esto es lo que convierte una busqueda biologica en un problema de distancia entre vectores, no de coincidencia textual.

    Usar Aurora PostgreSQL con pgvector en lugar de una base vectorial dedicada es una decision pragmatica del copiloto de investigacion de proteinas: muchos equipos ya conocen PostgreSQL, evitan introducir un sistema nuevo y mantienen los embeddings junto a metadatos relacionales. El precio es vigilar el rendimiento de los indices vectoriales cuando el volumen de secuencias crece.

    El patron de tres herramientas orquestadas por un agente Strands es transferible mas alla de la biologia. Separar interpretacion de consulta, recuperacion y resumen es exactamente la receta de un sistema RAG bien hecho, con la diferencia de que aqui el embedding no viene de texto generico sino de un modelo especializado en proteinas. Ese detalle es el que evita resultados irrelevantes: la calidad de la busqueda depende de que el modelo de embeddings entienda el dominio.

    Como pueden aplicar esto las empresas hoy

    Para una biotech o un laboratorio con datos propios de secuencias, esta guia es un punto de partida realista, no un experimento de fin de semana. El primer paso sensato es reproducir el despliegue con un subconjunto de secuencias y medir si la busqueda vectorial devuelve peptidos que un experto considere relevantes; sin esa validacion humana, los resumenes automaticos dan falsa confianza. El ROI aparece cuando el copiloto sustituye horas semanales de busqueda manual por consultas en lenguaje natural.

    Que evitar: cargar la base con millones de embeddings sin antes probar el coste de inferencia de ESM-C y el rendimiento de pgvector en su volumen real. Tambien conviene no tratar los resumenes cientificos automatizados como conclusiones, sino como un filtro previo que un investigador revisa. El patron del copiloto de investigacion de proteinas sirve igual para equipos que quieran adaptar la arquitectura a otros dominios con embeddings especializados, manteniendo la separacion entre interpretacion, recuperacion y resumen.

    Analisis Blixel

    Lo interesante de esta guia no es que AWS junte modelos y bases de datos, sino que normaliza un patron que llevamos meses recomendando: un agente no es un chatbot con esteroides, es un orquestador de herramientas con responsabilidades claras. Aqui se ve limpio. Una herramienta entiende la pregunta, otra busca, otra resume. Cuando un equipo respeta esa separacion, el sistema es depurable; cuando lo mete todo en un unico prompt gigante, se vuelve una caja negra imposible de mantener.

    Dicho esto, conviene bajar las expectativas. El verdadero cuello de botella en biotech rara vez es la busqueda, sino la calidad y curacion de los datos de secuencias y la validacion experimental posterior. Un copiloto que encuentra peptidos similares en segundos sigue dependiendo de que esos datos esten bien etiquetados y de que un cientifico interprete el resultado. La parte de IA es la facil; la de gobernanza del dato es la que decide si el proyecto sobrevive.

    Para una PYME espanola del sector salud o quimico, el mensaje practico es doble: la barrera tecnica para prototipar este tipo de asistente ha caido de forma notable, pero el coste real esta en preparar los datos y en el ciclo de validacion. Si alguien promete un asistente cientifico fiable en 45 minutos, esta vendiendo la demo, no el producto en produccion.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.