Categoría: Regulación y Ética

  • Meta retira la cláusula de scraping que alarmó a editores

    Meta retira la cláusula de scraping que alarmó a editores

    La cláusula de scraping de Meta ha desaparecido de los términos comerciales de la compañía. El texto permitía a Meta utilizar cualquier contenido de los dominios, páginas web o URLs asociados a una cuenta de empresa para desarrollar, investigar y entrenar sus productos. Para editores y empresas con cuenta de Meta Business, esa redacción dejaba una duda seria: podía leerse como un permiso para rastrear sus webs y alimentar modelos de IA. Meta asegura que no era ese su alcance, pero la frase ya no figura en el documento.

    Qué decía la cláusula de scraping de Meta y por qué preocupó

    El punto central es la amplitud de la redacción. La cláusula no hablaba de un conjunto limitado de datos ni de un uso concreto: se refería a cualquier contenido de los dominios, páginas web o URLs vinculados a una cuenta de empresa. Y el propósito que describía era igualmente amplio: desarrollar, investigar y entrenar los productos de Meta. Quien tenga una cuenta de Meta Business, por ejemplo para gestionar publicidad o una página corporativa, aceptaba esos términos al usar el servicio.

    Expertos legales calificaron la disposición de notable. Lo hicieron porque, leída al pie de la letra, podía interpretarse como una autorización de la propia empresa para que Meta rastreara su sitio web y usara lo que encontrara para entrenar modelos de inteligencia artificial. No es un matiz menor para un medio de comunicación, una tienda online o cualquier compañía que publica contenido propio y lo considera un activo.

    La respuesta de Meta fue acotar el alcance. Según la compañía, los términos de rastreo solo se aplicaban a sus productos de publicidad y negocio, y la retirada de la cláusula no modifica la manera en que utiliza sus web crawlers. Dicho de otro modo: Meta sostiene que el texto no era una licencia general para entrenar IA con cualquier web, y que quitarlo tampoco cambia sus prácticas actuales de rastreo.

    Hay que separar dos planos que a menudo se mezclan. Uno es lo que dice un contrato firmado por el titular de una cuenta. Otro es cómo funcionan los crawlers, los programas automáticos que visitan páginas web de forma masiva. Meta afirma que la cláusula afectaba solo al primero, y que el segundo sigue igual. Lo que consta de forma verificable es que el texto contractual se ha eliminado y que la empresa ha dado esa explicación.

    Implicaciones técnicas y legales de retirar la cláusula de scraping de Meta

    Desde el punto de vista contractual, la retirada elimina una ambigüedad. Un contrato que permite usar «cualquier contenido» de las URLs de una cuenta para entrenar productos genera un riesgo jurídico para quien lo firma, y también para quien lo redacta, porque invita a litigios sobre qué se consintió realmente. Al quitar la frase, Meta reduce el margen para que un editor o una empresa alegue que ya había dado permiso, o para que otra parte sostenga lo contrario.

    Desde el punto de vista técnico, lo importante es lo que no cambia. Meta ha dicho que la modificación no altera cómo usa sus web crawlers. Eso significa que los mecanismos habituales con los que un titular de web gestiona el acceso de los rastreadores siguen siendo la referencia práctica. Un cambio en un documento legal no sustituye a la configuración técnica de un sitio, y viceversa: ni el texto de los términos ni su retirada sustituyen a las decisiones que cada empresa toma sobre quién puede leer su web.

    El episodio también deja ver una tensión de fondo. El entrenamiento de modelos de IA necesita grandes volúmenes de contenido, y buena parte de ese contenido lo producen terceros: editores, creadores, empresas. Qué se puede rastrear, con qué base legal y bajo qué condiciones es un debate abierto en el sector. Que una cláusula comercial genere alarma entre expertos jurídicos demuestra lo sensible que es el asunto, incluso cuando la compañía afirma que su intención era mucho más limitada.

    Conviene no sacar conclusiones que el material disponible no sostiene. No hay constancia, en lo que Meta ha comunicado, de que la cláusula se aplicara para entrenar modelos con webs de clientes, ni de que su eliminación responda a un acontecimiento concreto. Lo que sí está claro es que un texto redactado de forma muy amplia fue leído por especialistas como algo más de lo que la empresa dice que significaba, y que la compañía optó por retirarlo.

    Qué significa este movimiento para el mercado

    Para los editores y las empresas con presencia en las plataformas de Meta, la lección es práctica: los términos comerciales son contratos vivos y conviene revisarlos cuando cambian. Quien gestiona una cuenta de Meta Business debería saber qué ha aceptado y qué ha dejado de aceptar. La retirada de la cláusula de scraping de Meta es una buena noticia para ellos, pero la aclaración de la empresa es una declaración, no una garantía contractual adicional sobre el futuro.

    Para otras plataformas tecnológicas, el caso funciona como aviso. Si una redacción amplia sobre contenido de terceros y entrenamiento de IA provoca reacciones de especialistas jurídicos y obliga a aclaraciones públicas, el coste reputacional de la ambigüedad es real. Es razonable esperar que los departamentos legales de otras compañías revisen cómo describen en sus condiciones el uso de datos para desarrollar y entrenar productos, aunque cada una decidirá según sus propios riesgos.

    Para los proveedores de servicios y agencias que gestionan cuentas de Meta en nombre de clientes, el asunto toca otra puerta: ellos firman o administran esos términos por cuenta ajena. Documentar qué versión de las condiciones estaba vigente en cada momento es una práctica sensata cuando el contenido de un cliente puede verse afectado por el texto.

    Por último, para quienes compran o contratan IA, el episodio recuerda que el origen de los datos de entrenamiento es una variable de riesgo. Cuanto más claras sean las condiciones sobre qué contenido se usa y con qué permiso, menos disputas habrá más adelante. La transparencia contractual, hoy, es parte del producto.

    Análisis Blixel

    Una cláusula que desaparece tras la alarma de los expertos no se puede leer como un simple retoque administrativo. Cuando los abogados leen un texto de una manera y la empresa dice que significaba otra, el problema es la redacción, y Meta lo ha resuelto de la forma más sencilla: borrándola. Es lo correcto, pero no cierra el debate de fondo.

    Lo más revelador es la aclaración. Meta insiste en que el cambio no modifica cómo usa sus web crawlers. Es decir, la retirada de la cláusula de scraping de Meta no altera la práctica, solo la apariencia contractual. Para un editor, eso es una noticia a medias: desaparece un riesgo de interpretación, pero no se obtiene ninguna información nueva sobre qué rastrea la compañía ni para qué lo usa.

    Mi posición es que las empresas con cuenta de Meta Business no deberían quedarse tranquilas solo porque el texto haya cambiado. Lo sensato es revisar sus términos con asesoría jurídica, comprobar qué controles técnicos aplican a su web y exigir a las plataformas condiciones concretas sobre el uso de sus datos y contenidos. Esperar a que un experto detecte una frase incómoda no es una estrategia.

    Para las PYMEs, que rara vez leen los términos comerciales de principio a fin, el caso es un recordatorio incómodo: aceptar condiciones por defecto significa delegar decisiones que pueden afectar a su propiedad intelectual. En la era del entrenamiento de IA, esa lectura ha dejado de ser opcional.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • Wahlberg abre la puerta a que un clon de IA siga su legado

    Wahlberg abre la puerta a que un clon de IA siga su legado

    El clon de IA en el cine ha vuelto a la conversación con una declaración de Mark Wahlberg: el actor defiende que la inteligencia artificial se use «de la forma correcta» y se muestra abierto a que una réplica digital suya continúe su legado. No es un anuncio de producto ni un acuerdo firmado, sino una postura pública de una figura conocida de Hollywood. Aun así, importa a productoras, empresas de medios y equipos que desarrollan réplicas de voz e imagen, porque ahí se cruzan consentimiento, derechos y contratos.

    Qué ha dicho Wahlberg sobre el clon de IA en el cine y por qué importa

    Conviene empezar por lo que sabemos y lo que no. El único dato verificable es que Mark Wahlberg se declara abierto a que un clon de IA suyo continúe su legado y que defiende un uso de la tecnología en el cine «de la forma correcta». No hay cifras, no hay una productora concreta, no hay un contrato anunciado y tampoco una descripción técnica de cómo sería ese clon. Cualquier detalle más allá de eso sería inventado, y no vamos a rellenar el hueco con suposiciones.

    Lo relevante es la señal. Durante los últimos años, buena parte de la conversación pública sobre réplicas digitales de actores ha sido defensiva: miedo a perder trabajo, a que una voz o un rostro se reutilicen sin permiso, a que un intérprete quede fuera de decisiones sobre su propia imagen. Que un actor de primera fila hable de aceptar un clon de IA, con la condición implícita de hacerlo bien, mueve el debate del «sí o no» hacia el «cómo y bajo qué reglas». Esa es la discusión que de verdad tiene consecuencias prácticas.

    Para quien desarrolla o contrata tecnología de voz e imagen sintéticas, la frase «de la forma correcta» es un buen recordatorio de que el problema no está en la capacidad técnica, que ya existe, sino en el marco que la rodea.

    Consentimiento, derechos y contratos: donde se decide el clon de IA en el cine

    Cuando un actor acepta que exista una réplica digital suya, se abren preguntas que ningún modelo resuelve por sí solo. ¿Quién es el propietario de los datos de entrenamiento, es decir, las grabaciones de voz, imagen y movimiento? ¿Quién controla el modelo resultante? ¿Para qué proyectos se puede usar y para cuáles no? ¿Durante cuánto tiempo? ¿Qué ocurre si el actor cambia de opinión o fallece? ¿Cómo se compensa cada uso? Un legado continuado por una réplica solo es defendible si esas respuestas están por escrito y el intérprete las ha aceptado de forma informada.

    Este es también el terreno donde se mueve la regulación. En España, el derecho a la propia imagen y a la voz está protegido por ley, y el consentimiento tiene que ser expreso y acotado a un uso. A escala europea, la normativa de IA incluye obligaciones de transparencia para el contenido sintético, de modo que el público pueda saber cuándo una imagen o una voz no son reales. Ninguna de estas normas prohíbe un clon autorizado, pero sí exige que la autorización sea clara y que el resultado no engañe al espectador.

    El punto técnico que suele pasarse por alto es la trazabilidad. Si una empresa genera una réplica, necesita saber con qué material se entrenó, bajo qué licencia y con qué límites de uso. Sin ese registro, cualquier disputa posterior se convierte en un problema legal y de reputación a la vez.

    Además, hay una diferencia importante entre dos escenarios que a menudo se mezclan: la réplica de un actor vivo que participa en las decisiones y la réplica que sigue funcionando cuando él ya no puede opinar. El segundo caso exige previsiones contractuales mucho más cuidadas.

    Qué pueden aprender las empresas que trabajan con voz e imagen sintéticas

    No hace falta rodar una película para encontrarse con este problema. Cualquier empresa que cree un avatar de un directivo, una voz sintética de un locutor o una réplica de un presentador para formación o marketing trabaja con la misma lógica que el clon de IA en el cine, a menor escala. La lección útil es contractual y concreta. Primero, el consentimiento debe ser específico: qué se clona, para qué usos y en qué canales. Segundo, hay que fijar la duración y las condiciones de revocación, incluyendo qué pasa con los modelos ya generados si la persona retira su permiso. Tercero, conviene dejar por escrito quién es el propietario del modelo y de los datos de entrenamiento, y si el proveedor tecnológico puede reutilizarlos. Cuarto, si hay compensación, que esté ligada a usos definidos y no a una cesión abierta. Y quinto, etiquetar el contenido como sintético desde el principio, porque las obligaciones de transparencia europeas van en esa dirección. Lo que conviene evitar es la cesión genérica de imagen y voz «para cualquier uso presente o futuro», una fórmula cómoda hoy y problemática mañana.

    Análisis Blixel

    Una frase como «de la forma correcta» no significa nada hasta que alguien la convierte en cláusulas. Es fácil estar a favor de un uso responsable de la IA en abstracto; lo difícil es decidir quién firma, qué se cede y qué se puede revocar. Por eso la declaración de Wahlberg es interesante, pero no concluyente: sabemos su disposición, no las condiciones. Y las condiciones son todo.

    Hay además un matiz de poder. Un actor de su trayectoria tiene capacidad de negociar términos, asesoría legal y margen para decir que no. La mayoría de intérpretes, locutores o creadores no tienen esa posición. Si el modelo de referencia se construye a partir de acuerdos entre estrellas y grandes estudios, el riesgo es que el resto del sector acabe aceptando contratos estándar que nadie ha negociado de verdad. La apertura de un famoso no puede servir como coartada para normalizar cesiones amplias a quien no puede discutirlas.

    Mi posición es clara: el clon de IA en el cine es defendible si cumple tres requisitos, consentimiento informado y acotado, control real del intérprete sobre los usos y transparencia hacia el público. Si falta cualquiera de los tres, deja de ser un legado y pasa a ser explotación de una imagen. Para las empresas que no hacen cine la conclusión es práctica: antes de comprar o construir una réplica de voz o imagen, resuelvan el papeleo. La tecnología ya está disponible, lo escaso es el criterio para usarla con permiso y con límites.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • Los micrófonos de Flock oyen más que disparos, según su web

    Los micrófonos de Flock oyen más que disparos, según su web

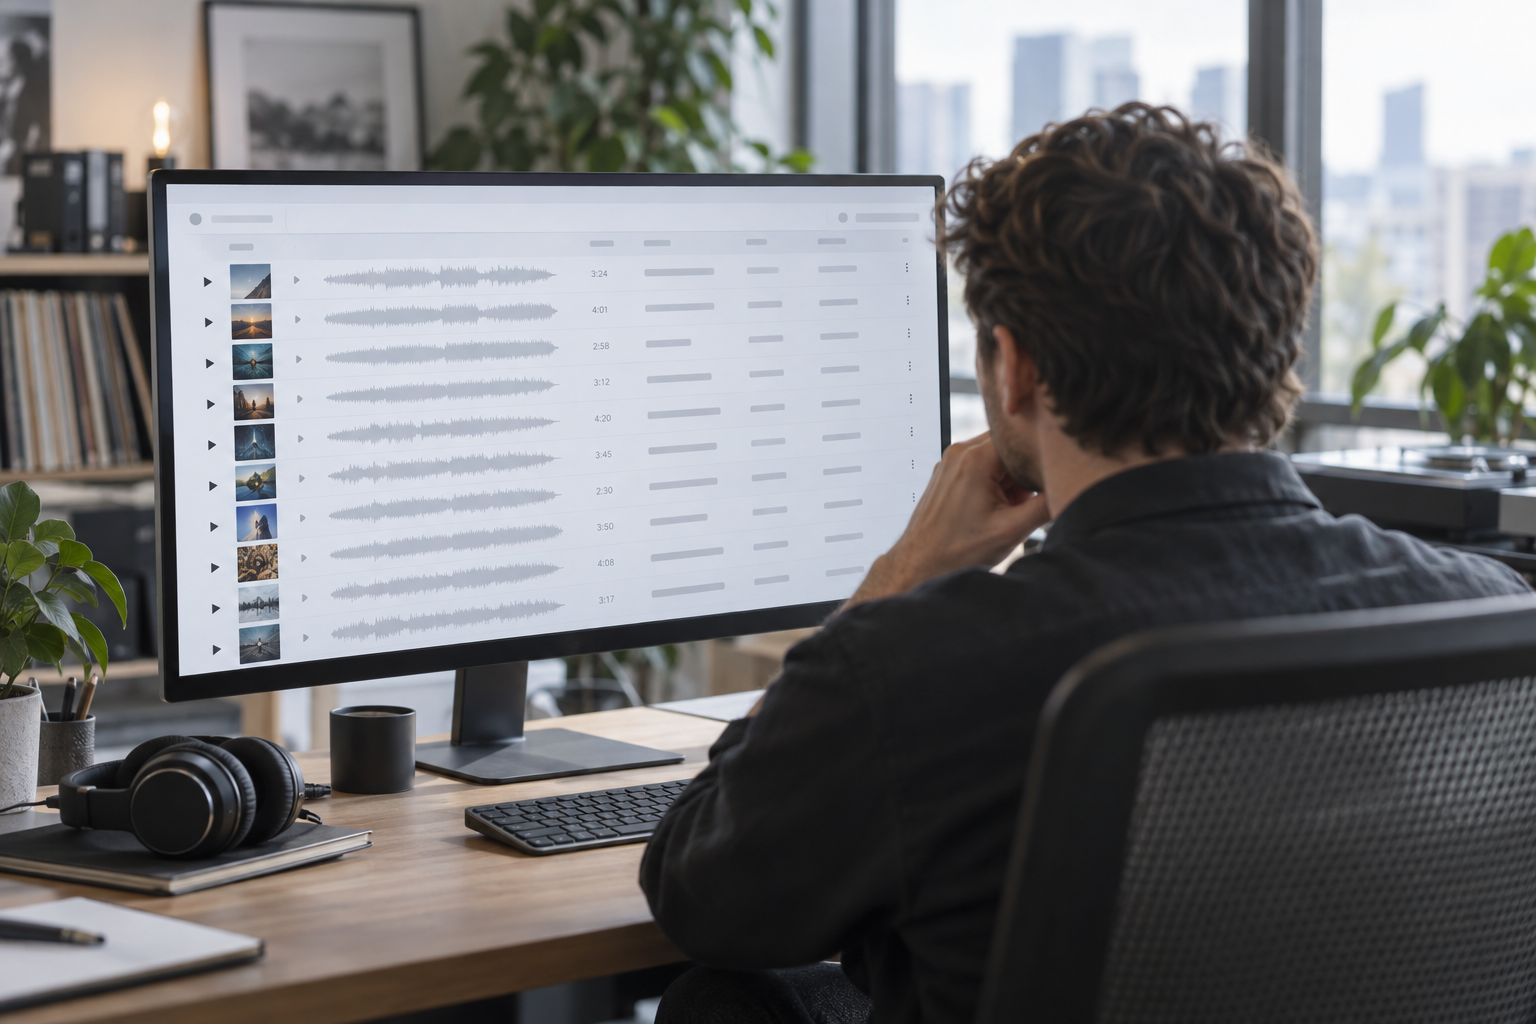
    Los micrófonos de Flock están en el centro de una discrepancia incómoda. Garrett Langley, CEO de la compañía, afirmó en un evento tecnológico que su producto Gunshot Detection detecta «solo disparos». Sin embargo, la web de la propia empresa indica que también identifica choques de coche, fuegos artificiales y sideshows, las exhibiciones de coches en la calle. Un portavoz ha matizado después el mensaje. Para empresas y administraciones que evalúan sistemas de vigilancia, el episodio deja una lección clara: conviene contrastar lo que dice un proveedor en un escenario con lo que figura en su documentación comercial.

    Qué ha pasado con los micrófonos de Flock y por qué importa

    Durante su intervención en un evento del sector, Langley defendió que el sistema de detección de disparos de Flock está limitado a un único tipo de sonido: los disparos. Es un mensaje sencillo y tranquilizador, pensado para responder a las dudas habituales sobre privacidad cuando se habla de micrófonos instalados en espacios públicos. El problema es que la comunicación comercial de la empresa cuenta otra cosa. Su web explica que el producto reconoce además choques de coche, fuegos artificiales y sideshows.

    Tras detectarse la diferencia, un portavoz de Flock aclaró que la tecnología detecta sobre todo disparos, pero también esos otros sonidos. Añadió dos límites concretos: el sistema no analiza conversaciones y tampoco detecta gritos ni situaciones de angustia. Es decir, la empresa no niega la lista de sonidos que aparece en su web; lo que corrige es la formulación absoluta del CEO. Entre «solo disparos» y «sobre todo disparos» hay una diferencia que, en un contrato público, no es menor.

    La importancia del asunto no está en que el producto reconozca un choque o un petardo, algo razonable en un sistema acústico. Está en que el alcance declarado por el máximo responsable y el alcance descrito en el material de ventas no coinciden. Quien compra o autoriza este tipo de tecnología toma decisiones con la información que recibe, y esa información tiene que ser coherente en todos los canales.

    Implicaciones técnicas y de mercado de los micrófonos de Flock

    Desde el punto de vista técnico, un sistema de detección acústica clasifica sonidos. Si el catálogo de sonidos que reconoce incluye disparos, choques, fuegos artificiales y sideshows, eso describe un conjunto de eventos que el sistema es capaz de identificar y notificar. Lo que dijo el portavoz sobre conversaciones y gritos delimita lo que el producto no hace, pero esa frontera depende de la palabra de la empresa y de lo que se pueda auditar. El input no aporta detalles sobre cómo se verifica, así que no se puede afirmar nada más allá de la declaración.

    En cuanto al tamaño del despliegue, Langley señaló que el número de micrófonos de Flock es comparable al de ShotSpotter, el otro gran nombre del sector. Según datos publicados por la prensa especializada, ShotSpotter tenía en 2024 unos 25.000. Esa comparación sitúa a Flock en la misma escala de infraestructura que el actor que lleva años siendo referencia en detección acústica de disparos, y explica por qué cualquier ambigüedad en sus mensajes recibe atención.

    El contexto también cuenta. La vigilancia con sensores en la vía pública afronta un escrutinio creciente por privacidad. En ese entorno, cada afirmación de un directivo sobre qué capta y qué no capta un dispositivo se compara con la documentación pública. Si no cuadra, el debate deja de ser sobre la tecnología y pasa a ser sobre la credibilidad del proveedor, que es un problema más difícil de resolver con un comunicado.

    Hay además una cuestión de falsos positivos conceptuales. Los fuegos artificiales y los choques no son disparos, y la propia web los menciona como sonidos que el sistema puede identificar. Para un cliente municipal o corporativo, saber qué categorías genera el producto es necesario para definir protocolos de respuesta, cuánto personal se moviliza y con qué criterio.

    Qué significa este episodio para el mercado de la vigilancia

    Para los competidores, el caso es una oportunidad y un aviso a la vez. Quien venda detección acústica, con ShotSpotter como comparación más evidente, sabe que las comparaciones entre discurso público y documentación se van a hacer. Un mensaje preciso y alineado en todos los canales pasa a ser parte del producto, no un detalle de marketing.

    Para los compradores, ya sean administraciones o empresas que gestionan grandes recintos, la consecuencia práctica es de proceso de compra. Lo razonable es pedir por escrito la lista completa de sonidos que el sistema detecta, qué datos se almacenan, durante cuánto tiempo y qué queda expresamente fuera del alcance, como las conversaciones o los gritos. Esa lista debería formar parte del contrato y no depender de lo que se diga en una presentación.

    Para los proveedores de menor tamaño que trabajan con sensores o con cualquier tecnología que capte audio, el mensaje es parecido. Las afirmaciones absolutas, del tipo «solo hace X», son frágiles: basta una página de producto que diga otra cosa para que se vuelvan en contra. Es más sólido describir con exactitud qué hace el sistema, qué no hace y cómo se puede comprobar.

    Y para los reguladores, el episodio ofrece un ejemplo concreto de por qué se piden requisitos de transparencia. No hace falta un incidente grave para ver el desajuste; basta comparar una declaración pública con la web del fabricante. Cuanto más claras sean las obligaciones de documentación, menos margen queda para formulaciones que simplifican de más.

    Análisis Blixel

    La confianza en la tecnología de vigilancia no se pierde por lo que hace el sensor, sino por la distancia entre lo que se promete y lo que se puede comprobar. Aquí esa distancia es pequeña en términos técnicos y grande en términos de reputación. Que un sistema acústico reconozca fuegos artificiales o choques no escandaliza a nadie con sentido común. Lo que sí desgasta es que el CEO diga «solo disparos» y la web diga otra cosa. Nadie pregunta por un matiz; la pregunta es qué más se matizará cuando alguien lo cuestione.

    Mi posición es que los proveedores de este sector deberían dejar de vender con frases absolutas y empezar a publicar fichas técnicas precisas: sonidos detectados, sonidos excluidos, datos conservados y plazos. Con los micrófonos de Flock, la aclaración del portavoz sobre conversaciones y gritos es útil, pero llega después de la polémica y como respuesta, no como política de transparencia. Un compromiso documentado y auditable pesaría mucho más que una frase en un escenario.

    Para quien compra, la regla es práctica: lo que no esté por escrito en el contrato no existe. Si un directivo dice una cosa y el material comercial dice otra, hay que quedarse con lo más restrictivo para el proveedor y exigir que se refleje en el acuerdo. No es desconfianza excesiva, es diligencia básica cuando el producto instala micrófonos en espacios donde hay ciudadanos que nunca han dado su consentimiento a nada.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • YouTube Music estrena etiquetas por la música con IA

    YouTube Music estrena etiquetas por la música con IA

    Las etiquetas de YouTube Music son la reacción más reciente de una plataforma ante un problema que el sector ya no discute: la música generada con IA llega a los servicios de streaming en cantidades que complican el descubrimiento y la gestión de los catálogos. YouTube Music ha lanzado nuevas etiquetas en su servicio justo en ese contexto. Con la información disponible no se pueden confirmar cifras, criterios de etiquetado ni fechas de despliegue, así que conviene separar con claridad lo que se sabe de lo que sigue sin aclarar.

    Qué ha pasado con las etiquetas de YouTube Music y por qué importa

    El dato firme es sencillo: YouTube Music ha introducido nuevas etiquetas en su servicio, y lo ha hecho mientras la música creada con modelos generativos inunda las plataformas de streaming. Esa coincidencia es la que da sentido a la noticia. Una etiqueta es, en esencia, una capa de información que acompaña a un contenido y le dice al usuario, al algoritmo o al gestor del catálogo algo sobre ese contenido. Que una plataforma de este tamaño añada etiquetas cuando se multiplica el material sintético indica que el problema ya se gestiona dentro del producto y no solo en comunicados o debates públicos.

    Lo que no sabemos es igual de relevante. No hay confirmación sobre qué señalan exactamente esas etiquetas, quién decide cuándo se aplican, si dependen de una declaración del autor o de una detección automática, ni cuándo llegarán a todos los mercados. Tampoco hay cifras sobre cuánta música generada con IA se sube ni sobre qué porcentaje del catálogo afecta. Cualquier análisis serio tiene que partir de esa limitación y evitar rellenar los huecos con suposiciones.

    Para quien publica o distribuye audio, la noticia importa por una razón práctica: la forma en que se presenta un contenido en una plataforma condiciona cómo lo encuentra la gente y cómo se trata dentro del catálogo. Una etiqueta nueva cambia esa presentación, aunque todavía no sepamos hasta qué punto.

    El contexto es conocido. Los modelos generativos de música han bajado la barrera para producir pistas completas, y los servicios de streaming son abiertos por diseño: cualquiera con un distribuidor puede subir material. Cuando producir cuesta poco y subir cuesta poco, el volumen crece más deprisa que la capacidad humana de revisarlo. Las etiquetas son una de las pocas herramientas de bajo coste que una plataforma tiene para reaccionar sin prohibir nada.

    Implicaciones técnicas y de mercado de las etiquetas de YouTube Music

    Desde el punto de vista técnico, etiquetar contenido sintético plantea dos problemas distintos que conviene no mezclar. El primero es la declaración: que quien sube la pista indique cómo se ha hecho. Es barato y escalable, pero depende de la honestidad del que sube. El segundo es la detección: que la plataforma identifique por sí misma si una pista procede de un modelo generativo. Es más robusto sobre el papel, pero exige tecnología fiable y asumir errores en ambas direcciones, es decir, pistas humanas marcadas como sintéticas y al revés. Hoy no podemos decir cuál de los dos enfoques sigue YouTube Music, y esa es precisamente la pregunta que más afecta a los usuarios profesionales de la plataforma.

    En el plano del mercado, la etiqueta introduce una variable nueva en la competencia por la atención. Si el oyente ve una marca que distingue el origen de la pista, esa información puede influir en lo que decide escuchar. Si además el sistema de recomendación la utiliza como señal, la visibilidad de un catálogo dependerá en parte de cómo esté clasificado. De momento no hay confirmación de que ocurra lo segundo, pero es el punto que cualquier distribuidor debería seguir de cerca.

    Para los desarrolladores que trabajan con modelos generativos de música, el mensaje es directo: la trazabilidad del resultado empieza a tener valor comercial. Saber qué modelo generó una pista, con qué condiciones de licencia, qué intervención humana hubo después y qué metadatos acompañan al archivo deja de ser un asunto interno y pasa a ser información que una plataforma puede pedir o inferir. Quien construya un producto sobre estos modelos hará bien en diseñar desde el principio un registro de procedencia de cada pieza que genera.

    También hay una lectura para los catálogos mixtos, donde conviven grabaciones humanas, material producido con herramientas de IA y obras híbridas. Las etiquetas simplifican la presentación, pero la realidad creativa es más gradual: una pista puede tener una voz generada y una base grabada, o una melodía humana con arreglos automáticos. Si las categorías de la plataforma son demasiado gruesas, los casos intermedios pueden quedar mal representados, y eso se acabará notando en reclamaciones y en conflictos de metadatos.

    Qué pueden hacer hoy las empresas que publican o distribuyen audio

    La lección útil aquí no es esperar a que se aclaren los criterios, sino preparar la información que cualquier criterio acabará pidiendo. Primera acción: hacer un inventario de qué piezas del catálogo se han creado total o parcialmente con modelos generativos y anotar la herramienta, la fecha y las condiciones de uso. Es un trabajo aburrido, pero una hora de orden hoy evita semanas de revisión cuando una plataforma pida explicaciones sobre una pista concreta.

    Segunda acción: definir una política interna sencilla de declaración. Si una pista tiene componentes sintéticos, se declara como tal en el momento de subirla, siempre que el distribuidor o la plataforma lo permitan. Declarar por iniciativa propia es mejor que descubrir que una etiqueta se ha aplicado desde fuera y sin posibilidad de matizar.

    Tercera acción: medir antes de decidir. Si una empresa usa música generada para vídeos corporativos, pódcast o canales propios, conviene comparar el rendimiento de sus publicaciones antes y después de que las etiquetas se activen en su mercado. Sin esa referencia no se podrá saber si el cambio afecta o no a las escuchas.

    Y una cosa que evitar: apostar por subir grandes volúmenes de pistas generadas con la esperanza de ganar por cantidad. Sin conocer los criterios de las etiquetas ni cómo las usa el sistema de recomendación, es una estrategia con riesgo de reputación y sin datos que la respalden. Para una PYME con un catálogo pequeño, la calidad y la claridad sobre el origen del material son la inversión más segura.

    Análisis Blixel

    Etiquetar es barato; verificar es caro, y de esa diferencia depende que esta medida sirva de algo. Una etiqueta que se apoya solo en lo que declara quien sube la pista informa al oyente tanto como la honestidad media del sector, que no es una garantía. Una etiqueta basada en detección exige una infraestructura costosa y asumir que se equivocará. Por eso lo importante de las etiquetas de YouTube Music no es que existan, sino quién paga el coste de que sean fiables. Hoy esa respuesta no está disponible, y quien la dé como cerrada está adelantando información que no tiene.

    Mi posición es que la transparencia sobre el origen de la música es razonable y, a medio plazo, inevitable. Un oyente tiene derecho a saber qué escucha, igual que un lector quiere saber si un texto lo ha escrito una persona. Pero la etiqueta no debería convertirse en un estigma automático. Hay creadores que usan IA como una herramienta más dentro de un proceso con criterio humano, y meterlos en la misma categoría que quien sube miles de pistas sin supervisión sería injusto y poco útil.

    Para las empresas la conclusión es poco glamurosa: documentar, declarar y no depender del volumen. Las plataformas están ajustando sus reglas sobre la marcha, y quien tenga ordenado su catálogo se adaptará con menos coste que quien tenga que reconstruir el historial de cada pista cuando se lo pidan. Mientras no haya criterios publicados, la mejor defensa es la trazabilidad.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • La UE apuesta por la IA agéntica como su próxima etapa

    La UE apuesta por la IA agéntica como su próxima etapa

    La IA agéntica en la Unión Europea se perfila como la siguiente etapa de la conversación sobre inteligencia artificial en el bloque, según plantea un artículo titulado «The EU’s next chapter in AI is agentic». La tesis es sencilla: tras los modelos conversacionales, el foco pasa a sistemas capaces de ejecutar tareas de forma autónoma. Hay que decir desde el principio que el texto no aporta cifras, fechas ni medidas concretas. Lo que ofrece es una dirección, y para empresas y desarrolladores europeos esa dirección ya merece atención.

    Qué plantea el artículo sobre la IA agéntica en la Unión Europea

    El dato verificable es limitado y conviene tratarlo como tal: una publicación sostiene que el próximo capítulo de la IA en la UE será agéntico. Es decir, que la atención de las instituciones, de la industria y de los desarrolladores europeos se desplazará de los asistentes que responden preguntas hacia sistemas que planifican, deciden pasos intermedios y actúan sobre otras herramientas sin que una persona supervise cada movimiento. No hay en el material recibido un anuncio legislativo, un calendario ni un programa de financiación asociado a esa tesis.

    Aun así, el planteamiento importa por el cambio de eje que describe. Durante los últimos años, el debate público sobre IA en Europa ha girado en torno a los modelos generativos de texto e imagen: qué datos usan, qué riesgos generan, qué transparencia deben ofrecer. Un agente cambia la pregunta. Ya no se trata solo de qué dice el sistema, sino de qué hace: envía un correo, modifica un registro, lanza un pago o cierra una incidencia. Esa diferencia, de decir a hacer, es la que explica por qué un titular sobre agentes interesa a quien tiene que responder por el cumplimiento normativo.

    Como contexto, la UE ya cuenta con el AI Act, un reglamento basado en niveles de riesgo cuyas obligaciones se aplican de forma escalonada. Esa arquitectura es el marco sobre el que se discutirá cualquier evolución hacia sistemas autónomos. Que el artículo apunte a los agentes como siguiente etapa no cambia por sí solo ese marco, pero sí señala hacia dónde se va a querer aplicar.

    Implicaciones técnicas y de cumplimiento de la IA agéntica en la UE

    Desde el punto de vista técnico, un sistema agéntico combina un modelo de lenguaje con capacidad de llamar a herramientas, encadenar pasos y mantener un objetivo a lo largo de varias acciones. Eso introduce problemas que un chatbot no tiene. Si un agente se equivoca en un paso intermedio, el error puede propagarse a los siguientes antes de que alguien lo vea. Si tiene acceso a sistemas internos, el alcance de un fallo depende de los permisos que se le hayan dado, no de lo bien que conteste. Por eso trazabilidad, registro de acciones y límites de autonomía son decisiones de diseño, no extras opcionales.

    En cumplimiento, la lectura útil es sobria. El AI Act clasifica los sistemas según su uso y su nivel de riesgo, y, hasta donde sabemos, no define una categoría específica llamada «agente». Eso significa que un agente se evaluará por lo que hace y en qué contexto, no por la etiqueta que lleve. Un agente que clasifica correos internos y otro que participa en decisiones sobre personas no están en el mismo punto del mapa de riesgo. A ello se suma el RGPD, que ya regula las decisiones automatizadas con efectos significativos sobre las personas, y que seguirá aplicándose a cualquier sistema que trate datos personales con autonomía.

    La consecuencia práctica para un equipo de producto es clara: antes de preguntarse si el agente es capaz, hay que preguntarse qué puede tocar, con qué datos y con qué supervisión humana. Esas tres respuestas son las que luego pedirá cualquier auditoría, cliente corporativo o autoridad.

    Queda también un punto técnico menos visible: la evaluación. Medir si un chatbot responde bien es relativamente directo. Medir si un agente completa tareas de varios pasos de forma fiable, y qué hace cuando algo falla, exige pruebas más largas y escenarios de error definidos de antemano. Cualquier exigencia futura de documentación o pruebas tendrá que apoyarse en ese tipo de evaluación, y los equipos que ya la practican llegarán con ventaja.

    Qué significa este movimiento para el mercado

    Un cambio de foco en el discurso europeo tiene efectos aunque todavía no haya medidas. Para los proveedores de plataformas de agentes, la señal es que el interés regulatorio y político se acercará a su producto. Quienes ya documentan permisos, registros de actividad y puntos de intervención humana tendrán material listo cuando un cliente europeo lo pida. Quienes venden agentes como cajas negras que «lo resuelven todo» tendrán más difícil justificarlo ante compradores con responsabilidades legales.

    Para los compradores, en particular empresas medianas con equipos legales pequeños, el criterio de selección cambia ligeramente. Además de precio y rendimiento, empieza a pesar si el proveedor puede explicar qué acciones ejecuta el agente, cómo se limitan y cómo se revierten. Esa conversación conviene tenerla ahora, en la fase de prueba, y no después de haber conectado el agente a la facturación o al CRM.

    Para los desarrolladores europeos hay un matiz competitivo. Si la UE termina poniendo el énfasis en agentes fiables y supervisables, quienes construyan con esos principios desde el inicio no tendrán que rehacer su arquitectura más adelante. Es una hipótesis de trabajo razonable, no una certeza: el material disponible no confirma ninguna medida. Lo prudente es diseñar con control y trazabilidad por defecto, porque esa práctica sirve con independencia de lo que se decida en Bruselas.

    Y para los competidores fuera de Europa que venden en el mercado europeo, el mensaje es parecido: el cumplimiento se evaluará por el comportamiento del sistema en su contexto de uso, algo que no se resuelve con un aviso legal en la web.

    Analisis Blixel

    Un titular no es una política, y conviene no confundirlos. El artículo plantea una tesis razonable, pero sin cifras, fechas ni medidas, lo único que podemos afirmar es que la conversación europea se está moviendo hacia los agentes. Cualquier plan de inversión o de cumplimiento basado solo en eso sería construir sobre aire. Mi posición es doble. Primero, no hay motivo para pausar proyectos con agentes a la espera de más claridad: el marco vigente ya permite evaluar con criterio el riesgo de cada uso. Segundo, tampoco hay motivo para desplegarlos con la ligereza con la que se probó un chatbot de preguntas frecuentes. Un agente que actúa exige permisos mínimos, registro de lo que hace y una persona con autoridad real para detenerlo. Esa disciplina cuesta poco al inicio y mucho cuando se añade tarde. Lo que más me interesa de la IA agéntica en la Unión Europea es la oportunidad de que el debate normativo y el técnico coincidan por una vez en el tiempo, en lugar de que uno llegue años después del otro. Para una PYME, el consejo práctico es aburrido pero eficaz: empezar con un agente de alcance pequeño, en un proceso donde el error sea barato, medir resultados y documentar decisiones. Cuando lleguen las medidas concretas, si llegan, esa documentación será un activo, no un trámite. Y si no llegan pronto, habrá servido igualmente para trabajar mejor.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • El CEO de Cerebras pide regulación razonable para la IA

    El CEO de Cerebras pide regulación razonable para la IA

    La regulación razonable de la IA es la propuesta central de Andrew Feldman, CEO y cofundador de Cerebras Systems, que ha criticado el discurso catastrofista sobre la inteligencia artificial en una conferencia tecnológica celebrada en 2026. Feldman llegó a afirmar que algunos líderes del sector «quizá no deberían hablar en público». Su diagnóstico va más allá de la polémica: atribuye parte del rechazo social a que la industria de los centros de datos no trabajó con las comunidades locales y reclama mejoras de eficiencia en hardware y en modelos.

    Qué ha dicho el CEO de Cerebras sobre la regulación razonable de la IA

    Feldman fue directo con quienes alimentan el miedo alrededor de la IA. Su planteamiento es que el discurso apocalíptico, el que presenta esta tecnología como una amenaza de primer orden, no ayuda a nadie y deteriora la conversación pública. De ahí su comentario sobre los líderes del sector que quizá no deberían hablar en público. Es una frase llamativa, pero no es lo más interesante de su intervención. Lo relevante viene después, cuando explica de dónde sale, a su juicio, el rechazo social que hoy encuentra la industria.

    Según Feldman, parte de ese rechazo se debe a que la industria de los centros de datos no trabajó con las comunidades locales, sobre todo en EE. UU. Dicho de otra forma: el problema no sería solo de relato, sino de ejecución. Se levantaron infraestructuras sin explicar ni negociar con las personas que iban a vivir cerca de ellas. Frente a eso, el CEO de Cerebras defiende una regulación razonable de la IA y mejoras de eficiencia tanto en el hardware como en los propios modelos. Son dos frentes distintos que él pone en el mismo paquete: reglas claras por un lado y consumo contenido por otro.

    Conviene situar quién habla. Cerebras Systems es un competidor de Nvidia en chips de IA y, entre sus clientes, figuran OpenAI, Block, Figma, GSK y Lovable. Es una cartera variada: desarrollo de modelos, pagos, diseño, farmacéutica y herramientas de desarrollo de software. Feldman también citó a Brasil, Canadá, Finlandia, Islandia, Noruega, México y Suecia como países que fomentan la construcción de estas instalaciones. Es decir, apuntó a una geografía en la que, según su lectura, el despliegue de centros de datos encuentra mejor acogida institucional que en Estados Unidos.

    Hay un matiz que no se debe obviar. Un fabricante de chips tiene interés directo en que se sigan construyendo centros de datos. Eso no invalida sus argumentos, pero obliga a leerlos con ese filtro: Feldman habla como analista del clima social y también como directivo de una empresa que vende infraestructura de cómputo.

    Eficiencia y centros de datos: el argumento técnico tras la regulación razonable de la IA

    El planteamiento de Feldman descansa en dos palancas técnicas. La primera es la eficiencia del hardware: chips que hagan el mismo trabajo con menos recursos. La segunda es la eficiencia de los modelos: arquitecturas y formas de entrenar y servir que reduzcan el coste de cada tarea. La lógica es sencilla. Si un chip o un modelo resuelve la misma tarea con menos energía, la presión sobre el entorno inmediato de cada centro de datos baja, y con ella una de las fuentes de fricción con los vecinos. Que lo diga el CEO de una empresa de chips no es casual: coloca la eficiencia como parte de la respuesta al problema social y no solo como una cuestión de costes.

    La segunda pieza es el trabajo con las comunidades. Feldman no lo presenta como un gesto de relaciones públicas, sino como algo que la industria dejó de hacer y que ahora paga en forma de rechazo. Esto tiene una consecuencia práctica para cualquier proyecto de infraestructura: la licencia social es un requisito más, igual que la conexión eléctrica o el suelo. Los países que cita, de América y del norte de Europa, sirven como ejemplo de que existen lugares donde la construcción se fomenta de forma activa.

    Sobre la regulación, el CEO de Cerebras defiende que sea razonable, pero en lo que se conoce de su intervención no concreta medidas. Y ahí está el límite del mensaje: «razonable» es un adjetivo que cada actor rellena a su manera. Para un fabricante de chips puede significar reglas estables que permitan planificar inversiones; para un vecino de un municipio con un centro de datos en proyecto, otra cosa muy distinta. Sin contenido concreto, la propuesta funciona más como posicionamiento que como programa.

    También es significativo lo que no dice. No plantea que los riesgos de la IA sean inexistentes, sino que el tono catastrofista bloquea un debate más útil sobre infraestructura, consumo y reglas del juego.

    Qué significa este movimiento para el mercado

    Para los competidores de Cerebras, empezando por Nvidia, el mensaje deja un terreno de disputa nuevo. La eficiencia deja de ser solo una métrica de rendimiento por vatio en una hoja de especificaciones y pasa a ser un argumento frente a reguladores y comunidades. Si un proveedor puede demostrar que su hardware reduce el impacto de un centro de datos, tiene un argumento comercial que hasta ahora se usaba poco fuera de los departamentos técnicos. Quien no lo haga tendrá que explicar por qué su infraestructura exige más a su entorno.

    Para los operadores y promotores de centros de datos, el aviso es claro. Feldman sitúa el origen del rechazo en la falta de trabajo con las comunidades locales, sobre todo en EE. UU. Si ese diagnóstico es correcto, la secuencia habitual de anunciar, construir y comunicar después tiene los días contados en los mercados donde la oposición vecinal ya existe. Y su lista de países que fomentan estas construcciones indica dónde puede resultar más fácil desplegar capacidad.

    Para las empresas que compran capacidad de cómputo, directa o a través de un proveedor cloud, la consecuencia es indirecta pero real. La aceptación social condiciona dónde se construye, cuánto tarda y con qué reglas. Eso acaba afectando a disponibilidad y precio, aunque no de forma inmediata. Una PYME no tiene que cambiar nada hoy por este debate, pero sí conviene que, al elegir proveedor de IA, tenga en cuenta dónde aloja su capacidad y qué compromisos de eficiencia asume. La regulación razonable de la IA, sea cual sea su forma final, se aplicará sobre esa cadena de suministro.

    Analisis Blixel

    El miedo a una tecnología no se desactiva con otro discurso, se desactiva con hechos en el territorio. Ahí Feldman acierta: si hay rechazo a los centros de datos, buena parte de la culpa está en haber construido sin contar con quienes viven al lado. Es la parte valiosa de su intervención y la que más debería escuchar el sector. Es incómoda porque no se arregla con una campaña, sino con tiempo, reuniones y compromisos verificables.

    Donde flojea es en la sugerencia de que algunos líderes quizá no deberían hablar en público. Pedir silencio a quien exagera los riesgos es una respuesta muy cómoda para quien vende infraestructura. Callar a los alarmistas no genera confianza; la genera la transparencia sobre consumo, ubicación y beneficios locales. Y el propio Feldman habla desde una posición con interés comercial evidente: su empresa compite con Nvidia y vende cómputo a OpenAI, Block, Figma, GSK y Lovable.

    Sobre la regulación razonable de la IA, mi posición es que el adjetivo no basta. Todo el sector dice querer reglas razonables, hasta que toca concretarlas. Lo útil sería que fabricantes como Cerebras acompañaran el mensaje con propuestas medibles: qué datos de consumo publicar, qué estándares de eficiencia aceptar, qué consultas hacer antes de construir. Hasta entonces, es una declaración de intenciones que suena bien y compromete a poco.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Apple gana acceso a los registros de contratación de OpenAI

    Apple gana acceso a los registros de contratación de OpenAI

    La demanda de Apple contra OpenAI por secretos comerciales ha entrado en una fase que interesa a cualquier empresa que contrate talento de la competencia. El juez federal Edward Davila ha concedido a Apple acceso acelerado a los materiales de las entrevistas que OpenAI hizo a antiguos empleados de Apple, candidatos a puestos de hardware de consumo y robótica. El tribunal fija plazos cortos y deja claro que los procesos de selección pueden acabar sobre la mesa de un juez.

    Qué ha decidido el juez en la demanda de Apple contra OpenAI

    El juez Davila ha estimado en parte la petición de Apple dentro del procedimiento abierto en julio. Apple tendrá acceso acelerado a los materiales de entrevistas de OpenAI con extrabajadores de Apple que optaron a puestos en hardware de consumo y robótica. El tribunal ha puesto dos plazos: cinco días para que OpenAI entregue lo que ya haya recopilado y 14 días para el resto de la documentación solicitada.

    Además, el tribunal ha aprobado las declaraciones de tres personas: Chang Liu, Alyssa Peng y Tang Yew Tan. Son testimonios que Apple podrá recoger como parte de la fase de prueba. La resolución no entra en el fondo del asunto, es decir, no dice si hubo o no uso indebido de información confidencial. Se limita a ordenar qué material debe circular entre las partes y con qué urgencia.

    La decisión tiene un límite relevante. El juez ha denegado, por ahora, el acceso acelerado a la I+D de OpenAI en áreas como acabados metálicos y gestión de energía. Apple pedía ir más lejos y mirar directamente el trabajo técnico de la compañía, pero el tribunal ha optado por empezar con los registros de contratación. La puerta no queda cerrada del todo, porque la denegación se limita al acceso acelerado y se formula como provisional.

    Para entender el alcance conviene recordar cómo funciona este tipo de litigio en Estados Unidos. En una demanda por secretos comerciales, la parte demandante debe acreditar que información confidencial salió de su casa y se usó en otra. Los datos de contratación son una de las vías más directas para reconstruir ese recorrido: quién fue entrevistado, para qué puesto, qué se le preguntó y qué se documentó. Por eso el juez ha empezado por ahí.

    Implicaciones de la demanda de Apple contra OpenAI para el mercado

    La primera lectura es procesal, pero tiene consecuencias prácticas. Un tribunal ha aceptado que las entrevistas con candidatos procedentes de un competidor son material relevante y que merece un calendario acelerado. Los plazos de cinco y 14 días dejan poco margen para localizar, ordenar y revisar documentos internos. Las empresas que no tengan sus registros de selección organizados se enfrentarían a ese reloj con desventaja.

    La segunda lectura se refiere al hardware. El caso señala puestos en hardware de consumo y robótica, dos áreas en las que OpenAI ha buscado talento con experiencia en productos físicos. Contratar a quien ha trabajado años en un competidor directo es una práctica habitual en tecnología, y es legal. La disputa se centra en si esa contratación fue acompañada de uso de información confidencial. La frontera entre experiencia profesional y secreto comercial es fina, y los registros de entrevistas son una de las pocas pruebas que muestran lo que se habló en el proceso.

    También importa lo que el juez no ha concedido. Negar por ahora el acceso acelerado a áreas de I+D como acabados metálicos y gestión de energía indica que el tribunal prefiere ir por etapas. Primero se examina cómo se contrató y, solo después, si hace falta, se revisa el desarrollo técnico. Esa secuencia protege a OpenAI de una inspección amplia de su trabajo mientras no haya base suficiente.

    Por último, las declaraciones aprobadas añaden un componente humano. Que se haya autorizado a recoger testimonio de Chang Liu, Alyssa Peng y Tang Yew Tan significa que el caso no se resolverá solo con papeles. Las partes tendrán que explicar bajo juramento qué ocurrió en esos procesos de selección.

    Qué significa este movimiento para el mercado

    Para los competidores de ambas compañías, el mensaje es directo: fichar talento de un rival con litigio abierto es una exposición legal real. Cualquier empresa tecnológica que contrate perfiles senior de un competidor puede encontrarse con que sus entrevistas, sus notas y sus comunicaciones internas se piden en un juzgado si el antiguo empleador alega uso de información confidencial. Los equipos de recursos humanos y los departamentos legales tendrán que trabajar más juntos de lo que suelen.

    Para los proveedores de herramientas de selección y gestión documental, el caso refuerza una necesidad que ya existía: trazabilidad. Si una empresa debe entregar en cinco días lo ya recopilado, necesita saber dónde está cada documento y quién tuvo acceso. Las organizaciones con notas de entrevista dispersas en correos, chats y hojas de cálculo lo tendrán más difícil.

    Para quienes compran o evalúan a OpenAI como proveedor, el efecto inmediato es limitado. La resolución es procesal y no cuestiona el funcionamiento de ningún producto. Aun así, un litigio con una compañía del tamaño de Apple, centrado en su expansión hacia el hardware, es un dato a seguir en cualquier análisis de riesgo de proveedor. No hay sentencia, y conviene no tratarlo como si la hubiera.

    Para las empresas más pequeñas, la lección es de higiene. Un contrato de trabajo con cláusulas claras de confidencialidad, entrevistas que no exploren información reservada del empleador anterior y un registro ordenado del proceso son medidas baratas frente al coste de una disputa. No hace falta ser una gran tecnológica para que un exempleador reclame, y la documentación decide quién puede demostrar qué.

    Análisis Blixel

    Lo más interesante de esta resolución no es quién gana, sino qué se considera prueba. Durante años, el debate sobre competencia entre grandes tecnológicas giró alrededor del código, de los modelos y de las patentes. Aquí el juez ha empezado por algo mucho más mundano: las entrevistas de trabajo. Es una señal de que la guerra por el talento ha dejado de ser solo un asunto de nóminas y ha pasado a ser un asunto probatorio.

    En la demanda de Apple contra OpenAI, el tribunal ha sido prudente. Ha concedido lo que parece proporcionado, los registros de contratación, y ha negado por ahora el acceso a la I+D. Es una decisión razonable, porque pedir de entrada el trabajo técnico de un rival sin base previa se parece más a una expedición de pesca que a una investigación. Apple tendrá que demostrar con lo que reciba que hay algo más que contrataciones legítimas.

    Mi posición es que este caso va a servir de aviso, con independencia de cómo termine. Las empresas, también las pequeñas, tratan sus procesos de selección como un trámite interno y no como un archivo que puede pedirse en un juicio. Eso es un error. Cada entrevista, cada nota y cada mensaje a un candidato procedente de la competencia puede leerse algún día en una sala.

    Conviene además evitar la lectura fácil. Que un juez ordene entregar documentos no prueba que se haya cometido ninguna infracción. Es una fase de averiguación, no un veredicto. Quien saque conclusiones antes de ver qué contienen esos materiales está haciendo periodismo de titular. Lo sensato es esperar a los documentos y a las declaraciones.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • Microsoft ve a Reino Unido al frente de la regulación de IA

    Microsoft ve a Reino Unido al frente de la regulación de IA

    La regulación de la IA en Reino Unido ha vuelto a la conversación después de que el presidente de Microsoft afirmara que el país es el mejor situado para impulsarla. Es una declaración con peso por quién la pronuncia, pero el contenido disponible no incluye cifras, fechas, propuestas normativas ni los argumentos que la respaldan. Eso limita lo que se puede contar con rigor. Aquí separamos lo verificable de lo que sigue siendo opinión y explicamos qué deberían vigilar las empresas que venden o despliegan modelos en el mercado británico y europeo.

    Qué ha dicho Microsoft y por qué importa la regulación de la IA en Reino Unido

    El dato verificable es uno solo: el presidente de Microsoft ha declarado que Reino Unido es el país mejor situado para liderar la regulación de la inteligencia artificial. No sabemos en qué foro lo dijo, a qué iniciativa concreta se refiere ni qué ventajas atribuye al país frente a otros. Tampoco hay cifras, calendarios ni referencias a un texto legal en trámite. Con ese material, cualquier detalle adicional sería invención, y no vamos a añadirlo.

    Aun así, la declaración merece atención por el emisor. Microsoft es uno de los grandes proveedores de servicios cloud y de IA para empresas, así que su posición pública indica qué tipo de entorno regulatorio quiere ver un actor de ese tamaño. Es información útil para entender el debate, pero no es una norma ni crea obligaciones para nadie. Los requisitos los fijan parlamentos y reguladores, no los directivos de las compañías tecnológicas.

    Conviene además situarla junto a otros marcos. La Unión Europea ya cuenta con su propio reglamento de IA, y cualquier empresa que opere en ambos mercados tiene que mirar los dos. Por eso una frase sobre quién debería liderar la regulación no es un asunto solo político: afecta a cómo se planifican producto, documentación y contratos con clientes.

    Implicaciones técnicas de la regulación de la IA en Reino Unido para quien despliega modelos

    Sin un texto normativo concreto no hay requisitos nuevos que cumplir a raíz de esta declaración. Lo que sí existe es el trabajo de base que la mayoría de los marcos regulatorios de IA tienden a exigir: saber qué sistemas de IA usa la empresa, para qué los usa, con qué datos trabajan y quién responde de sus resultados. Un inventario actualizado de modelos y casos de uso es la herramienta más barata para estar preparado, sea cual sea el marco que acabe imponiéndose.

    El segundo punto es la posible divergencia entre jurisdicciones. Si Reino Unido y la UE establecen requisitos distintos, una empresa que venda en ambos mercados tendrá que mantener dos conjuntos de obligaciones: documentación, evaluaciones de riesgo, información al usuario. Para un equipo pequeño, duplicar ese trabajo supone un coste real en horas y en asesoría legal. Por eso conviene diseñar los procesos internos de forma modular, de modo que se puedan ajustar sin rehacerlos.

    El tercer punto es la dependencia de terceros. Quien consume modelos a través de una API de un gran proveedor comparte parte de la carga de cumplimiento con él. La documentación técnica, las condiciones de uso y las garantías sobre datos que ofrece el proveedor pasan a ser material de auditoría propio. Pedirlas por escrito y archivarlas es una tarea sencilla que ahorra problemas cuando llega una revisión o una petición de un cliente corporativo.

    Por último, está la parte de producto. Si un equipo de desarrollo toma decisiones sobre supervisión humana, registros de actividad o transparencia hacia el usuario, es más fácil incorporarlas desde el diseño que añadirlas después. Esto no depende de ninguna declaración: es una práctica de ingeniería que reduce riesgo con independencia del marco legal.

    Qué significa este movimiento para el mercado

    Para los competidores de Microsoft, la declaración es una señal de que los grandes proveedores están posicionándose en el debate regulatorio. Quien participa en esa conversación tiene opciones de influir en cómo se redactan las reglas, algo que las empresas medianas rara vez pueden hacer por su cuenta. Las asociaciones sectoriales y los foros de consulta pública son el canal más realista para que las PYMEs tecnológicas hagan oír su postura.

    Para los compradores de servicios de IA, el mensaje es de cautela. Un proveedor que defiende un marco determinado no garantiza que ese marco vaya a adoptarse ni que le favorezca a usted como cliente. Los contratos deberían incluir cláusulas que cubran cambios normativos: quién asume los costes de adaptación, qué plazos se conceden y qué ocurre si el servicio deja de cumplir los requisitos de un mercado.

    Para los proveedores más pequeños y las startups, la incertidumbre tiene un coste directo. Sin reglas claras, la planificación de producto y de inversión se hace con márgenes más amplios. La reacción sensata es documentar bien lo que ya se hace y esperar a que exista texto concreto antes de comprometer recursos en cumplir algo que todavía no está escrito.

    Analisis Blixel

    Las declaraciones de los grandes proveedores sobre regulación merecen la misma lectura que un folleto comercial: informan de una posición, no de una realidad. Que el presidente de Microsoft considere a Reino Unido el mejor candidato para liderar el debate dice mucho de lo que su compañía quiere y poco de lo que las empresas tendrán que cumplir. La regulación de la IA en Reino Unido será lo que escriban su Parlamento y sus reguladores, y hasta que exista ese texto, lo prudente es no mover presupuestos ni equipos en función de una frase.

    También hay que ser honestos con el material disponible. Esta noticia llega sin cifras, sin fechas y sin argumentos, así que cualquier artículo que prometa grandes consecuencias a partir de ella está rellenando huecos. Preferimos decir que hay poco que analizar y centrarnos en lo que sí está al alcance de una empresa: inventariar sus sistemas de IA, ordenar la documentación de sus proveedores y revisar los contratos para que contemplen cambios normativos.

    Mi posición es clara. Las PYMEs no necesitan adivinar quién liderará la regulación, necesitan procesos internos lo bastante ordenados para adaptarse a cualquier marco sin empezar de cero. Esa inversión es modesta y rentable en todos los escenarios. Lo demás, de momento, es ruido de posicionamiento corporativo.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Amazon deja de esconder sus acuerdos de centros de datos

    Amazon deja de esconder sus acuerdos de centros de datos

    Amazon y otras tecnológicas han decidido dejar de mantener en secreto sus acuerdos de centros de datos, un cambio frente a la opacidad que ha marcado este tipo de operaciones durante años. La pregunta que plantea el titular es si esa apertura basta para generar confianza. Conviene decir desde el principio que solo conocemos ese planteamiento: no hay cifras ni detalles concretos de los contratos. Aun así, el movimiento afecta a cualquier empresa que dependa de cloud y de cómputo para IA.

    Qué ha pasado con los acuerdos de centros de datos y por qué importa

    Lo verificable es esto: Amazon y otras empresas tecnológicas han cambiado de criterio y ya no mantienen en reserva los acuerdos relacionados con sus centros de datos. Hasta ahora, lo habitual era la discreción. Los términos de instalación, los compromisos asumidos y las condiciones pactadas quedaban fuera del debate público. Que ese patrón se rompa es relevante por sí mismo, aunque todavía no sepamos qué se publica exactamente, con qué nivel de detalle ni en qué formato.

    La importancia práctica se entiende desde dos lados. Para las comunidades donde se instalan estas infraestructuras, conocer los acuerdos permite valorar qué impacto tienen y qué se ha comprometido a cambio. Para empresas y desarrolladores que consumen capacidad cloud y cómputo para IA, la transparencia ayuda a entender mejor qué hay detrás de los servicios que contratan. No es un dato menor: cada vez más proyectos de IA dependen de infraestructura que otros construyen y financian.

    Es importante no sobreinterpretar. El texto disponible no aporta importes, ubicaciones ni cláusulas. Tampoco confirma si la apertura es voluntaria, si responde a presión externa o si afecta a todos los proyectos o solo a algunos. Cualquier análisis serio debe partir de esa limitación y evitar rellenar los huecos con suposiciones.

    Contexto: la opacidad como norma en la infraestructura cloud

    Los centros de datos son la base física de la IA generativa y del cloud. Cada modelo que se entrena o se sirve a escala necesita capacidad de cómputo alojada en instalaciones concretas, y esas instalaciones se acuerdan con administraciones, suministradores y comunidades locales. Históricamente, buena parte de esas negociaciones se ha llevado con mucha reserva, y los detalles solían conocerse tarde o no conocerse.

    Ese silencio tiene una consecuencia directa: genera desconfianza. Cuando una comunidad no sabe qué se ha pactado, tiende a asumir lo peor, y cuando una empresa cliente no sabe en qué condiciones opera su proveedor, depende de promesas comerciales. Por eso el cambio de criterio tiene sentido como primer paso. Otra cosa es que sea suficiente, y ahí está el verdadero debate del titular.

    Implicaciones: transparencia no es lo mismo que confianza

    Publicar un acuerdo y generar confianza son dos cosas distintas. La transparencia es una condición necesaria, pero la confianza se construye con información útil, comprensible y verificable. Un documento extenso, redactado en lenguaje jurídico y sin indicadores claros, cumple formalmente con la apertura y no ayuda a casi nadie a evaluar nada. La calidad de lo que se divulgue importará más que el hecho de divulgarlo.

    También cuenta quién puede contrastar esa información. Si los acuerdos son públicos pero no existe un mecanismo para comprobar que se cumplen, la apertura queda en declaración de intenciones. Los compromisos con las comunidades solo tienen valor si se pueden medir con el tiempo. Esa es la vara con la que se juzgará este movimiento, más que el anuncio en sí.

    Hay además una dimensión de coherencia. Si solo algunas compañías abren sus contratos y otras mantienen la reserva, el efecto es parcial y puede crear una comparación incómoda entre proveedores. Si la práctica se extiende, se convierte en un estándar de facto. El titular habla de Amazon «y otras tecnológicas», pero sin más detalle no podemos saber qué grado de adopción real hay.

    Por último, está la cuestión de qué información interesa a cada público. Una comunidad local querrá saber qué se ha comprometido en su territorio. Un cliente corporativo querrá entender qué condiciones respaldan la capacidad que contrata. Un regulador querrá poder comparar. Un único formato rara vez sirve para los tres, y ese reto de diseño es tan importante como la decisión política de abrir los documentos.

    Qué significa este movimiento para el mercado

    Para los competidores, el cambio eleva el listón. Una vez que un gran proveedor publica sus acuerdos de centros de datos, mantener el secreto resulta más difícil de justificar ante comunidades, administraciones y clientes. Los que no se sumen quedarán expuestos a la pregunta de qué tienen que ocultar. Esa presión reputacional suele ser más eficaz que muchas normas, aunque no sustituye a la regulación.

    Para los compradores de cloud y cómputo, incluidas las PYMEs que usan estos servicios sin construir infraestructura propia, el efecto es indirecto pero útil. Más información sobre cómo se despliega la capacidad ayuda a evaluar riesgos de dependencia de un proveedor y a incorporar criterios de transparencia al elegir. No hace falta esperar a tener todos los detalles: basta con empezar a preguntar a los proveedores qué publican y qué no.

    Para proveedores y suministradores de la cadena, la apertura puede cambiar cómo se negocia. Cuando los términos pueden salir a la luz, se negocia sabiendo que se pueden comparar. Todo esto depende de la profundidad real de la divulgación, un dato que hoy no tenemos y que conviene seguir con atención en los próximos meses.

    Análisis Blixel

    Abrir los contratos es la parte fácil. Lo difícil es que esa apertura cambie algo para quien vive junto a un centro de datos o para quien depende de él. Una empresa puede publicar mil páginas y seguir sin responder a lo que la gente pregunta: qué se ha prometido, quién lo vigila y qué ocurre si no se cumple. Mientras no haya respuesta clara a esas tres preguntas, la transparencia será un gesto, no una garantía.

    Creo que el movimiento es positivo, y también que es pronto para aplaudir. Con la información disponible, no sabemos si los acuerdos de centros de datos que se publiquen serán completos, comparables o legibles. El sector tecnológico tiene un historial de transparencia selectiva: mucho informe de sostenibilidad, poco dato que permita contrastar. Si esto se queda en eso, habrá sido relaciones públicas bien ejecutadas.

    Para las PYMEs españolas, la lección es práctica y modesta. No controlan dónde se construye un centro de datos, pero sí eligen proveedor. Incorporar preguntas sobre transparencia de infraestructura a las decisiones de compra de cloud es un hábito barato que, sumado al de miles de clientes, empuja al mercado. Y quien presiona con criterio acaba obteniendo mejor información.

    Mi posición: la confianza no se decreta con un cambio de política de comunicación. Se gana cuando lo prometido se puede comprobar y los compromisos se cumplen año tras año. Esa será la prueba real, y todavía no ha empezado.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • El Pentágono deja de usar Claude, pero no de golpe

    El Pentágono deja de usar Claude, pero no de golpe

    El Pentágono deja de usar Claude, el modelo de Anthropic, meses después de que el secretario de Defensa, Pete Hegseth, declarara a la compañía riesgo para la cadena de suministro. El motivo es que Anthropic se negó a retirar las salvaguardas de Claude ante usos de vigilancia masiva y armas autónomas. Pero el cambio no ha sido inmediato: el modelo siguió funcionando dentro de Maven, la plataforma de inteligencia de Palantir, mientras Defensa firmaba contratos con otros proveedores. Es un caso de manual sobre lo difícil que resulta sustituir una IA ya integrada.

    Qué ha pasado: el Pentágono deja de usar Claude tras el veto a Anthropic

    El Departamento de Defensa de Estados Unidos ha dejado de usar las herramientas de IA de Anthropic. La decisión llega meses después de que Pete Hegseth declarara a la empresa riesgo para la cadena de suministro, una etiqueta que en la práctica la coloca en la lista negra de proveedores del Pentágono. La razón es concreta: Anthropic se negó a retirar las salvaguardas de Claude ante usos de vigilancia masiva y armas autónomas. Es decir, el conflicto no gira en torno a la calidad del modelo ni a un fallo técnico, sino a quién fija los límites de uso de una tecnología cuando ya está en manos del cliente.

    El 27 de febrero, Hegseth fijó un plazo de seis meses para completar la retirada. Ese calendario ya dice algo: ni siquiera el Pentágono, con su capacidad de presión y su presupuesto, daba por hecho que se pudiera apagar Claude de un día para otro. Anthropic ha respondido con una demanda contra el Gobierno, en la que considera la designación «sin precedentes e ilegal».

    Conviene separar dos planos. El primero es político: una empresa estadounidense de IA recibe un tratamiento que, según ella misma, no tiene precedentes. El segundo es operativo: qué ocurre dentro de los sistemas que ya dependían de su tecnología. Mientras la disputa avanzaba, el Pentágono firmaba contratos con OpenAI, Google y xAI, tres alternativas que cubren el hueco comercial. Pero firmar con un proveedor nuevo y desmontar al anterior son tareas distintas, y la segunda es la que más tarda. Ese desfase convierte el caso en algo más que una noticia de política tecnológica: es una demostración pública de lo que cuesta cambiar de modelo cuando este forma parte de un flujo de trabajo crítico.

    Maven, Palantir y el coste real de sustituir un modelo de IA

    El dato más revelador es que Claude seguía funcionando dentro de Maven, la plataforma de inteligencia de Palantir, cuando el veto ya estaba en marcha. El modelo no estaba en una herramienta aislada que se pudiera desinstalar, sino incrustado en una plataforma de terceros que a su vez utiliza el Pentágono. Esa cadena, con Defensa, Palantir y Anthropic como eslabones, añade una capa de dependencia que no siempre aparece en el contrato principal. Quien contrata la plataforma hereda el modelo que lleva dentro, y quien quiere retirarlo necesita que el integrador lo sustituya, lo pruebe y lo valide.

    Cualquier equipo técnico reconoce además el problema de fondo: cambiar de LLM no es solo cambiar una clave de API. Los prompts, las evaluaciones, los formatos de salida y el comportamiento ante casos límite están ajustados a un modelo concreto. Con otro, hay que repetir buena parte de ese trabajo. En un entorno de inteligencia, donde la fiabilidad pesa más que la velocidad, el margen para improvisar es menor.

    El plazo de seis meses encaja con esa realidad: una migración así requiere tiempo. También deja un matiz importante. Que el Pentágono deja de usar Claude como decisión política no significa que desaparezca de todos sus sistemas el mismo día. Entre la orden y la ejecución hay una transición en la que conviven el modelo vetado y los nuevos proveedores. Para otros compradores de IA, públicos o privados, la lección técnica es directa: depender de un único modelo, sobre todo cuando llega a través de un tercero, es un riesgo que se mide en meses de trabajo, no en horas.

    Qué significa este movimiento para el mercado

    Para los competidores de Anthropic, el efecto inmediato es comercial. OpenAI, Google y xAI han firmado contratos con el Pentágono mientras el conflicto seguía abierto, lo que las coloca como proveedores de referencia en Defensa. Para Anthropic, el coste es doble: pierde un cliente de enorme peso y carga con una designación que, si se mantiene, puede condicionar cómo la ven otros compradores del sector público.

    Para los compradores, el mensaje es que las políticas de uso de un proveedor de IA ya no son letra pequeña. Las salvaguardas de un modelo pueden chocar con las necesidades de un cliente y acabar en una ruptura contractual. Antes de integrar un LLM en un sistema crítico conviene saber qué usos prohíbe el proveedor, qué pasa si el cliente discrepa y cuánto cuesta salir.

    Para los integradores, como Palantir en este caso, el episodio demuestra que son parte del riesgo. Si un modelo queda vetado, es el integrador quien debe sustituirlo dentro de sus plataformas. La demanda de Anthropic dirá si la designación de riesgo para la cadena de suministro se puede usar contra un proveedor de IA por mantener sus límites de uso. Hasta entonces, el precedente está sobre la mesa y el mercado lo está leyendo.

    Análisis Blixel

    Una política de uso solo vale lo que cuesta defenderla, y Anthropic está pagando el precio de la suya. Se puede discutir si el Pentágono tiene razón al exigir un modelo sin límites o si la empresa hace bien en mantenerlos, y cada lector tendrá su posición. Lo que no admite discusión es el coste: perder a un cliente de este tamaño y acabar en los tribunales no es una decisión menor.

    Lo más interesante, sin embargo, está en la letra pequeña operativa. Que el Pentágono deja de usar Claude y aun así necesite seis meses de plazo, con el modelo todavía dentro de Maven, desmonta la idea de que los modelos son piezas intercambiables. En la práctica, un LLM integrado crea una dependencia tan real como la de cualquier software crítico, y esa dependencia se agrava cuando llega envuelta en la plataforma de un tercero.

    Mi lectura es que el verdadero aviso no va dirigido a Anthropic, sino a cualquier organización que esté construyendo sobre un único proveedor de IA. Si Defensa, con todo su poder de negociación, tarda meses en salir, una empresa mediana tardará proporcionalmente más y con menos margen. La respuesta sensata no es dejar de usar IA, sino diseñar desde el principio la capacidad de cambiar de modelo: evaluaciones propias, capas de abstracción y contratos que digan con claridad qué usos permite cada proveedor. Es más aburrido que una disputa política, pero es lo que evita acabar improvisando una migración bajo presión.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • AWS explica cómo alinear la IA responsable con ISO 42005

    AWS explica cómo alinear la IA responsable con ISO 42005

    La gobernanza de IA responsable ha dejado de ser un apartado de buenas intenciones en la web corporativa y se ha convertido en algo que un cliente grande te pide por escrito. AWS ha publicado un artículo en el que explica cómo plantea a sus clientes la alineación con la norma ISO/IEC 42005:2025. El dato verificable es ese estándar; el texto no detalla servicios ni herramientas concretas. Aun así, la señal es útil para empresas y equipos técnicos que deben documentar riesgos y responder a auditorías.

    Gobernanza de IA responsable: qué ha dicho AWS y por qué importa

    AWS ha elegido un estándar internacional como marco para hablar de IA responsable con sus clientes. En lugar de describir principios propios, remite a ISO/IEC 42005:2025 como referencia para la alineación. Es un movimiento previsible en un proveedor cloud de ese tamaño: cuando una empresa despliega modelos sobre su infraestructura, la pregunta de sus propios clientes ya no es si usa IA, sino cómo demuestra que la controla.

    Conviene ser precisos con lo que sabemos. El material de partida confirma el estándar citado y el enfoque de posicionar a los clientes para alinearse con él. No incluye una lista de servicios, funciones ni plantillas, ni cifras de adopción. Por tanto, cualquier lectura sobre qué herramientas concretas de AWS cubren qué requisito sería inventada, y aquí no vamos a hacerla. Lo que sí podemos analizar es qué significa apoyarse en una norma ISO y qué trabajo queda del lado de cada empresa.

    Como contexto, ISO/IEC 42005 se enmarca en las normas internacionales de IA y trata de la evaluación de impacto de los sistemas de IA. Es decir, no habla de cómo entrenar mejor un modelo, sino de cómo analizar y dejar por escrito qué efectos puede tener un sistema sobre las personas y la organización. Ese enfoque documental es justo lo que piden hoy compradores, proveedores y reguladores cuando revisan un proyecto de IA.

    Implicaciones técnicas de la gobernanza de IA responsable basada en estándares

    Para un equipo técnico, alinearse con una norma de evaluación de impacto se traduce sobre todo en disciplina de documentación. Hay que saber qué sistema de IA se ha desplegado, con qué finalidad, con qué datos, quién responde de él y qué riesgos se identificaron antes de ponerlo en producción. Nada de esto es glamuroso, pero es lo que separa un piloto improvisado de un sistema que puede pasar una revisión externa.

    También implica trazabilidad. Si un cliente pregunta por qué un sistema tomó cierta decisión o cómo se evaluó su impacto, la respuesta debe estar en un registro revisable, no en la memoria de quien lo montó. Los proveedores cloud pueden facilitar parte de esa infraestructura, como registros, controles de acceso o inventario de recursos, pero la evaluación del impacto en sí depende del contexto de uso de cada empresa. Ningún proveedor puede redactar por ti qué consecuencias tiene tu chatbot de atención al cliente sobre tus usuarios.

    Hay además una distinción que se pierde con facilidad: alinearse con una norma no equivale a estar certificado. Alinearse indica que tus procesos siguen las pautas del estándar; certificarse exige una verificación formal. El texto de AWS habla de alineación, y esa palabra importa. Para quien venda a grandes cuentas, conviene saber qué prefiere ver cada cliente: una declaración de alineación con evidencias o un certificado emitido por un tercero. Son compromisos distintos, con costes y plazos distintos.

    Por último, el uso de un estándar ISO como lenguaje común reduce fricción en las compras. Cuando proveedor y cliente comparten referencia, los cuestionarios de seguridad y cumplimiento se vuelven más cortos y más comparables. Esa es la ventaja práctica de la gobernanza de IA responsable apoyada en normas reconocidas: menos negociación sobre qué significa "responsable" en cada contrato.

    Qué significa este movimiento para el mercado

    Que un gran proveedor cloud ancle su mensaje de IA responsable en un estándar ISO empuja al resto a hacer algo parecido. Los competidores directos tendrán que explicar con qué marco trabajan, y los proveedores de software que se apoyan en esas nubes heredarán la pregunta de sus propios clientes. A medio plazo, citar una norma concreta pasa a ser el mínimo esperable en una propuesta comercial que incluya IA.

    Para las empresas compradoras, el efecto es doble. Por un lado, tienen un criterio más objetivo para comparar proveedores: pueden pedir evidencias de alineación con la norma en lugar de aceptar declaraciones genéricas. Por otro, asumen que la responsabilidad no se delega del todo. Un proveedor puede aportar infraestructura y guías, pero el análisis de impacto de cada caso de uso sigue siendo trabajo del cliente.

    Para las PYMEs españolas, la lectura es de calendario y de prioridades, no de pánico. Si trabajan con grandes clientes o con administraciones, es razonable que empiecen a recibir preguntas sobre cómo gestionan sus sistemas de IA. Prepararse no exige un departamento de cumplimiento: basta con un inventario de los sistemas de IA en uso, una evaluación de impacto sencilla por cada caso y un responsable nombrado. Lo que conviene evitar es comprar una promesa de cumplimiento llave en mano, porque el texto de AWS no dice que exista, y ningún proveedor puede certificar tu proceso por ti.

    También cambia la posición de los proveedores pequeños de IA. Quien no pueda documentar su alineación con un estándar reconocido partirá en desventaja en concursos y homologaciones. La ventaja competitiva pasa a estar en la evidencia disponible, no en el discurso.

    Análisis Blixel

    Un estándar sirve de poco si se queda en una cita en un artículo corporativo, y ahí está el riesgo de este tipo de mensajes. Decir que se plantea la alineación con una norma ISO es fácil; lo difícil es que el cliente final salga con un procedimiento aplicable el lunes por la mañana. El texto que ha motivado esta pieza no concreta servicios ni herramientas, y eso limita lo que se puede afirmar con rigor. Nos parece más honesto decirlo que rellenar el hueco con suposiciones.

    Dicho esto, la dirección es correcta. La gobernanza de IA responsable funciona cuando se apoya en referencias que un auditor, un cliente o un regulador reconocen sin que haya que explicárselas. Un marco propio de cada proveedor genera confusión; una norma común reduce discusiones y acorta ciclos de compra. Esa es la parte útil del movimiento.

    Nuestra posición para las PYMEs es pragmática. No esperéis a que un proveedor os diga cómo cumplir: empezad con lo que está en vuestra mano, que es inventariar qué IA usáis, para qué y con qué riesgos. Es un trabajo de unos días, no de meses, y os deja con evidencias reales cuando llegue la primera auditoría de un cliente. Y desconfiad de quien venda cumplimiento como un producto que se instala. La norma ordena el trabajo, pero el trabajo lo sigue haciendo cada empresa, con sus datos y su contexto.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • OpenAI pondrá marca de agua invisible a ChatGPT en la UE

    OpenAI pondrá marca de agua invisible a ChatGPT en la UE

    OpenAI empezará a incluir una marca de agua invisible en el texto que generan ChatGPT y Codex dentro de la Unión Europea. El motivo es cumplir las obligaciones de transparencia del AI Act, vigentes desde el 2 de agosto. El anuncio no afecta solo a los usuarios europeos: cualquier desarrollador que use la API, esté en el país que esté, podrá activarla en modelos seleccionados. Eso sí, viene desactivada por defecto y el detector, de momento, no está al alcance de cualquiera.

    Qué ha anunciado OpenAI y por qué importa la marca de agua invisible

    La compañía aplicará la marca de agua invisible al texto de sus dos productos en territorio comunitario. Se trata de una señal incrustada en el propio contenido generado que no se ve al leerlo, pensada para que, con la herramienta adecuada, se pueda saber si un texto salió de un modelo de OpenAI. El detonante es regulatorio: el AI Act exige transparencia sobre el contenido generado por sistemas de IA, y esas normas se aplican desde el 2 de agosto. OpenAI responde así a esa obligación en el mercado europeo.

    Hay dos detalles que importan más de lo que parece. El primero es que la API permite activar la marca de agua en modelos seleccionados a usuarios de cualquier país, no solo de la UE. El segundo es que la opción llega desactivada por defecto, de modo que quien no haga nada seguirá generando texto sin ella en la API. Es decir, la decisión pasa a ser del equipo técnico que integra el modelo, no de OpenAI.

    Conviene recordar el contexto: durante años la detección de texto generado por IA se ha apoyado en clasificadores externos con resultados muy irregulares. Una marca de agua incorporada por el propio proveedor es un enfoque distinto, porque la señal nace en el momento de la generación y no se infiere a posteriori. Que ahora lo imponga una norma europea convierte lo que era una línea de investigación en una función de producto.

    Lo que la marca de agua invisible no consigue: límites y acceso al detector

    OpenAI ha publicado cifras sobre la robustez de su sistema, y son más honestas que triunfalistas. En sus pruebas, el detector identifica el texto marcado en torno al 92% de los casos. Pero si se sustituye el 10% de las palabras por sinónimos, la detección baja al 66%. Un cambio menor, que cualquiera puede hacer a mano o con otra herramienta, recorta casi un tercio de la capacidad de detección. Quien quiera borrar el rastro no necesita grandes conocimientos técnicos.

    Hay además tres tipos de contenido donde la detección resulta más difícil: los textos cortos, las respuestas matemáticas y los textos traducidos. Tiene lógica práctica: un mensaje de dos líneas ofrece poco margen para que la señal se acumule, una solución matemática deja poca libertad de redacción y una traducción reescribe el texto casi por completo. Para un negocio que genera descripciones breves, respuestas de soporte o contenido multilingüe, justo esos son los casos habituales.

    Queda la cuestión del acceso. El detector se limita por ahora a investigadores y organizaciones expertas aprobados. Una empresa que active la marca de agua en su API no podrá comprobar por sí misma si un texto la lleva. La señal existe, pero la verificación queda en manos de terceros autorizados. Para la transparencia pública tiene sentido evitar que cualquiera pruebe cómo esquivarla, pero también significa que la utilidad inmediata para una PYME es limitada.

    En resumen, esta marca de agua invisible es una medida de cumplimiento y trazabilidad parcial, no un detector universal de texto de IA. Las propias cifras de OpenAI lo dejan claro.

    Como pueden aplicar esto las empresas hoy

    Lo primero es averiguar si tu producto genera texto con modelos de OpenAI para usuarios en la UE. Si es así, conviene que el responsable técnico y el asesor legal revisen qué exige el AI Act a tu caso concreto, porque una cosa es la obligación de OpenAI como proveedor y otra la tuya como quien despliega el servicio. No des por hecho que la marca de agua lo resuelve todo.

    Segundo paso: si usas la API, decide si activas la marca de agua invisible en los modelos que la soporten. Como viene desactivada, no ocurrirá nada por sí solo. Antes de activarla en producción, prueba su efecto sobre el tipo de texto que generas y valora si te interesa dejar constancia del origen del contenido.

    Tercero: no prometas a clientes o a tu dirección que podréis detectar textos de IA con esta herramienta. Con el detector restringido a investigadores y organizaciones aprobados, y con una caída del 92% al 66% tras cambiar el 10% de las palabras, esa promesa no se sostiene. Tampoco construyas procesos disciplinarios o de verificación de proveedores sobre ella.

    Y cuarto, documenta. Anota qué modelos usas, en qué flujos y con qué configuración de marca de agua. Si mañana te piden explicar cómo gestionas la transparencia del contenido generado, tener ese registro ahorra tiempo y discusiones. Es una tarea aburrida, pero barata y útil.

    Analisis Blixel

    La transparencia que exige Europa se va a construir con medidas imperfectas, y conviene aceptarlo cuanto antes. Una señal que pierde 26 puntos de detección con solo cambiar una de cada diez palabras no es un sello de autenticidad; es un indicio. Y OpenAI, a su favor, no lo esconde: publica sus propias cifras flojas en lugar de vender blindaje.

    Lo que me parece más relevante es el reparto de papeles. La marca de agua invisible la genera el proveedor, pero la decisión de activarla en la API recae en quien desarrolla. Con la opción desactivada por defecto, el cumplimiento real dependerá de que miles de equipos pequeños lean la letra pequeña. Y sin acceso al detector, esos equipos ni siquiera podrán verificar que su configuración funciona. Es una asimetría incómoda: la responsabilidad se reparte hacia abajo, las herramientas de comprobación se quedan arriba.

    Dicho esto, restringir el detector a investigadores y organizaciones expertas aprobados tiene una lógica defendible mientras el sistema sea tan fácil de debilitar. Abrirlo del todo sería regalar el manual para esquivarlo. Lo que no es defendible es que las empresas lo vendan como garantía.

    Mi recomendación para una PYME es pragmática: trata esta función como un elemento más de tu documentación de cumplimiento, no como una estrategia de detección. Actívala si tu caso lo justifica, anota que lo has hecho y sigue combinando criterio humano, políticas internas de uso y etiquetado claro cuando publiques contenido generado. La marca de agua ayuda, pero no sustituye a la responsabilidad editorial de quien firma el texto.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.