
Categoría: Hardware y Cómputo

  • Cerebras habla de los límites del escalado de la IA

    Cerebras habla de los límites del escalado de la IA

    Los límites del escalado de la IA han sido uno de los temas del escenario de TechCrunch Disrupt 2026, donde Andrew Feldman, CEO de Cerebras Systems, participó en una charla sobre hasta dónde puede llegar la estrategia de entrenar modelos cada vez más grandes con cada vez más cómputo. Feldman habla desde una posición concreta: su empresa fabrica chips especializados para entrenar redes neuronales. Para quien planifica inversión en infraestructura o trabaja con modelos de gran tamaño, conviene entender qué se discute y qué no se puede concluir todavía.

    Feldman lleva al escenario los límites del escalado de la IA

    Andrew Feldman, CEO de Cerebras Systems, participó en TechCrunch Disrupt 2026 para discutir los límites del escalado en inteligencia artificial. El evento reunió a ejecutivos tecnológicos con el objetivo de analizar las tendencias futuras del sector, y su intervención se enmarca en ese programa. Conviene ser precisos con lo que sabemos: el tema de la charla está claro, pero no disponemos de cifras, citas literales ni anuncios de producto asociados a ella, así que este artículo no los inventa. Lo verificable es el contexto. Por escalado se entiende la práctica de mejorar el rendimiento de un modelo aumentando su tamaño, la cantidad de datos de entrenamiento y la potencia de cálculo dedicada. Que el CEO de una empresa de hardware hable de sus límites es relevante porque Cerebras fabrica chips especializados para el entrenamiento de redes neuronales. Es decir, opera justo en la capa donde ese escalado se convierte en facturas, centros de datos y plazos de entrega.

    Para entender por qué el tema pesa tanto, hay que mirar cómo ha evolucionado el sector. Durante los últimos años, la estrategia dominante para obtener modelos más capaces ha consistido en entrenarlos más grandes y con más cómputo. Esa lógica ha convertido el acceso a aceleradores en un factor competitivo y ha llevado a las empresas a tratar la capacidad de cálculo como un activo estratégico. Cuando alguien con la posición de Feldman habla de límites, el debate deja de ser académico y entra en el terreno de las decisiones de inversión. Hay además un matiz que un lector crítico debe tener presente: un fabricante de chips tiene interés directo en cómo se interpreta la demanda de cómputo. Eso no invalida su opinión, pero obliga a leerla como la de un actor del mercado y no como la de un observador neutral. Para una PYME o un equipo de desarrollo, la utilidad de esta charla está menos en las conclusiones concretas y más en la pregunta que plantea sobre los límites del escalado de la IA: cuánta mejora adicional compra realmente cada unidad adicional de cómputo.

    Implicaciones técnicas de los límites del escalado de la IA

    Cuando se habla de límites del escalado, el debate técnico suele repartirse en varios frentes. El primero es el coste del cómputo: cada salto de tamaño exige más chips y más tiempo de entrenamiento. El segundo es la comunicación entre chips: al repartir un modelo grande entre muchos aceleradores, parte del esfuerzo se pierde en mover datos en lugar de calcular. El tercero es la energía y la capacidad física de los centros de datos. El cuarto es la disponibilidad de datos de calidad con los que alimentar modelos mayores. Estos frentes son categorías generales del sector, no un resumen de lo que dijo Feldman en el escenario, y conviene mantener esa distinción. Lo que sí es verificable es que su empresa trabaja en hardware específico para entrenamiento, un enfoque distinto al de reutilizar procesadores generalistas. Cada diseño de chip implica compromisos entre velocidad, memoria, coste y facilidad de programación.

    Para los desarrolladores, la consecuencia práctica es separar dos actividades que a menudo se mezclan: entrenar y usar modelos. Entrenar un modelo de gran escala desde cero está al alcance de muy pocas organizaciones, y es precisamente el terreno donde operan los chips de Cerebras. La mayoría de equipos trabaja en otra capa: consume modelos por API, los ajusta con fine-tuning o monta sistemas con RAG sobre sus propios documentos. En esa capa, que el escalado tenga límites o no afecta de forma indirecta: influye en los precios, en la velocidad con la que mejoran los modelos disponibles y en la oferta de hardware. Seguir estos debates sirve para entender el entorno, no para cambiar la arquitectura de un proyecto de la noche a la mañana. Las predicciones sobre techos tecnológicos conviene tratarlas como hipótesis de trabajo y no como hechos consumados.

    Qué significa este movimiento para el mercado

    La presencia de Feldman en Disrupt refleja que los fabricantes de hardware especializado quieren participar en la conversación pública sobre el rumbo de la IA. Para los competidores en chips, cada intervención de este tipo funciona también como escaparate: se compite por el relato además de por el rendimiento. Para los compradores de infraestructura, la consecuencia es de método. Antes de comprometer presupuesto, conviene pedir a cualquier proveedor datos comparables: rendimiento medido con cargas similares a las propias, coste total incluyendo energía y personal, plazos de entrega y esfuerzo de migración del software.

    Para los proveedores cloud y de servicios, un debate abierto sobre los límites del escalado de la IA introduce incertidumbre en la planificación de capacidad. La respuesta prudente es preferir contratos flexibles frente a compromisos largos basados en una única hipótesis sobre cuánto cómputo hará falta. Para las PYMES que no compran chips, el efecto es más sutil pero real: sus costes de IA dependen de lo que ocurra en esta capa, y eso aconseja medir el gasto actual en modelos, identificar qué casos de uso generan valor y evitar atarse a un solo proveedor. No hay que reaccionar a una charla, pero sí tener un criterio propio cuando llegue la próxima ronda de precios o de cambios en la oferta de hardware.

    Analisis Blixel

    Toda opinión sobre cuánto cómputo necesita la IA debería leerse sabiendo quién la emite. Feldman dirige una empresa que vende chips para entrenar modelos, y tanto si defiende que el escalado seguirá dando resultados como si apunta a sus límites, su empresa tiene un relato que contar. No lo decimos como reproche, sino como método de lectura. Nuestra posición es que el valor de estas charlas para una empresa española está en la pregunta, no en la respuesta del ponente. Los límites del escalado de la IA existen como debate real, pero ninguna conferencia los fija, y menos aún una de la que solo conocemos el tema y no el contenido literal. Esa es también una advertencia sobre la cobertura de este tipo de eventos: conviene desconfiar de los titulares que atribuyen cifras o predicciones sin citarlas. Para una PYME, la recomendación es poco vistosa pero sólida. Casi nunca tiene sentido comprar infraestructura propia de entrenamiento; lo razonable es alquilar capacidad, medir cuánto cuesta cada caso de uso y revisar esa cifra cada trimestre. Si el escalado se encarece, lo notará en el precio de las APIs. Si se abarata, también. En ambos escenarios gana quien tiene sus costes medidos y sus proveedores intercambiables. Y quien decide con una nota de prensa en la mano, pierde.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Crusoe cancela un pedido de 1.250 millones a Boom

    Crusoe cancela un pedido de 1.250 millones a Boom

    La cancelacion de un acuerdo de turbinas para centros de datos de IA por valor de 1.250 millones de dolares entre Crusoe y Boom Supersonic pone el foco en la fragilidad de la cadena de suministro energetica que sostiene el auge de la inteligencia artificial. Crusoe, una startup de infraestructura que ha levantado 3.900 millones de dolares, ha dado marcha atras en la compra de 29 turbinas Superpower de 42 megavatios. El movimiento golpea los planes de financiacion de Boom y expone una tension creciente: quien paga y quien asume el riesgo de alimentar la nueva ola de computo.

    Que ha pasado y por que importa

    Crusoe ha cancelado su acuerdo con Boom Supersonic para adquirir 29 turbinas Superpower de 42 megavatios cada una, una operacion valorada en 1.250 millones de dolares. Estas turbinas estacionarias estaban destinadas a suministrar energia a centros de datos de IA, un segmento donde Crusoe se ha posicionado tras recaudar 3.900 millones de dolares en financiacion. La decision deja a Boom sin uno de sus clientes de referencia para su nueva linea de negocio energetico.

    El contexto explica el peso de la noticia. Boom es conocida por su ambicion de fabricar el jet supersonico Overture, un proyecto de altisimo coste. La compania habia disenado una estrategia por la cual las ganancias de las turbinas estacionarias servirian para financiar ese desarrollo aeronautico. El ano pasado levanto 300 millones de dolares precisamente para comercializar el negocio de turbinas. La cancelacion de Crusoe corta una de las vias de ingresos previstas y obliga a Boom a apoyarse en otros compradores para sostener su hoja de ruta financiera.

    Implicaciones tecnicas y de mercado

    El episodio ilustra un cuello de botella real en el despliegue de centros de datos de IA: la generacion electrica. La demanda de computo crece mas rapido que la capacidad de la red, y operadores como Crusoe exploran generacion propia in situ mediante turbinas de gas. Comprometer 1.250 millones en 29 unidades de 42 megavatios equivale a asegurar mas de 1,2 gigavatios de capacidad, una cifra que revela hasta que punto la energia se ha convertido en el factor limitante del sector.

    Para Boom, la retirada de Crusoe no significa el fin del negocio de turbinas para centros de datos de IA, pero si un reves de calendario. La compania mantiene que entregara 250 megavatios de turbinas a otros clientes en 2027 y apunta a 1 gigavatio en 2028. Cumplir esos hitos sin el ancla financiera que representaba Crusoe sera mas exigente. Al mismo tiempo, la noticia muestra la volatilidad de unos acuerdos multimillonarios firmados en un mercado donde las prioridades de infraestructura cambian con rapidez y los compromisos de compra pueden revisarse.

    Que significa este movimiento para el mercado

    Para los operadores de centros de datos de IA, la cancelacion confirma que la generacion electrica propia sigue siendo una apuesta con riesgo de ejecucion. Un compromiso de 1.250 millones que se deshace envia una senal a proveedores de turbinas: los contratos de suministro energetico no son garantias hasta que el hardware esta instalado y funcionando. Los fabricantes de equipos de generacion, desde grandes industriales hasta entrantes como Boom, deberan diversificar su cartera de clientes para no depender de un solo comprador de gran tamano.

    Para los compradores de capacidad de computo, el mensaje es que la escasez de energia sigue definiendo el ritmo de expansion del sector. Quien controla la generacion controla el calendario de despliegue. Para competidores de Crusoe, la operacion abre una ventana: las 29 turbinas que Boom tenia comprometidas podrian redirigirse a otros clientes que buscan asegurar suministro de cara a 2027 y 2028. En un mercado donde cada megavatio cuenta, un pedido cancelado por un actor se convierte en oportunidad para otro.

    Analisis Blixel

    Firmar contratos de infraestructura por miles de millones y luego cancelarlos se esta normalizando en el sector, y eso deberia preocupar mas que entusiasmar. El caso demuestra que los grandes numeros de la IA descansan sobre una realidad fisica muy poco glamurosa: hace falta electricidad, mucha, y no basta con anunciarla. Crusoe ha levantado 3.900 millones y aun asi reajusta compromisos de suministro; Boom ata su ambicion aeronautica a la venta de turbinas y ve como uno de sus clientes clave se retira. Ninguna de las dos empresas es pequena, y aun asi el acuerdo se ha caido.

    La leccion para cualquiera que evalue proveedores de infraestructura es de prudencia. Un compromiso de compra no equivale a capacidad garantizada, y depender de un unico cliente ancla, como hacia Boom, es una fragilidad estructural. El sector de la IA vive un momento de anuncios grandilocuentes sobre gigavatios y miles de millones, pero la ejecucion real es lenta, cara y sujeta a cambios de prioridad. Boom mantiene sus objetivos de 250 megavatios en 2027 y 1 gigavatio en 2028, y sera revelador comprobar si los cumple sin el respaldo financiero que Crusoe representaba. Mientras tanto, conviene leer estos titulos con escepticismo: la energia es el verdadero limite del boom de la IA, y los contratos que hoy se firman con bombo pueden deshacerse manana sin apenas explicacion. La solidez de un proyecto se mide en megavatios instalados, no en cartas de intencion.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Anthropic pagara 11.600 millones a Akamai por la nube

    Anthropic pagara 11.600 millones a Akamai por la nube

    El contrato cloud de Anthropic con Akamai asciende a 11.600 millones de dolares repartidos en siete anos, seis veces mas que el acuerdo previo de 1.800 millones reportado en mayo. La cifra confirma que la carrera por la capacidad de computo ya no es solo cosa de las tres grandes nubes. Y llama la atencion por un detalle poco habitual: buena parte de esa apuesta se dirige a CPU, no a GPU. En un momento en que casi todo el gasto en IA se concentra en aceleradores grafi
    cos, Anthropic esta diversificando hacia procesadores de proposito general para sostener sus agentes.

    Que ha pasado y por que importa

    Anthropic ha acordado gastar 11.600 millones de dolares durante siete anos en la infraestructura cloud de Akamai. La magnitud del salto es lo relevante: el acuerdo original, filtrado en mayo, era de 1.800 millones. Multiplicar por seis un compromiso en pocos meses indica que las necesidades de computo de la compania han crecido a un ritmo dificil de anticipar incluso para sus propios equipos. Este contrato cloud de Anthropic con Akamai coloca al proveedor de CDN y edge computing en una liga en la que no se le solia asociar.

    El punto tecnico central es la apuesta por CPU en lugar de GPU para determinadas cargas de trabajo de IA. Los agentes de IA, a diferencia del entrenamiento de modelos, requieren mucha capacidad de procesamiento general: orquestacion de tareas, llamadas a herramientas, gestion de contexto y ejecucion de flujos largos. Ahi el CPU tiene sentido economico. Para Akamai, cuyo negocio historico es la entrega de contenido y la seguridad en el edge, este contrato cloud abre una via de ingresos completamente distinta.

    La compania espera generar entre 150 y 300 millones de dolares en ingresos durante 2027 y alcanzar un ritmo anual de 1.700 millones hacia finales de 2028. Son cifras que, para el tamano actual de Akamai, representan un cambio de escala en su perfil de negocio.

    Implicaciones tecnicas y de mercado

    La lectura tecnica es clara: los agentes de IA no consumen recursos igual que el entrenamiento. Mientras entrenar un modelo exige clusteres masivos de GPU, ejecutar agentes en produccion implica millones de operaciones de logica, coordinacion y E/S que un CPU maneja con mejor relacion coste-rendimiento. Que un laboratorio como Anthropic firme un contrato cloud de esta envergadura orientado a CPU es una senal de que el peso del gasto en IA empieza a desplazarse del entrenamiento hacia la inferencia agentica a gran escala.

    Para el mercado, el movimiento rompe la idea de que solo AWS, Azure y Google Cloud pueden absorber cargas de IA de este calibre. Anthropic ya trabaja con AWS y Google, y sumar a Akamai confirma una estrategia multiproveedor deliberada para no depender de una unica infraestructura. La diversificacion reduce riesgo de suministro y da poder de negociacion.

    El contexto ayuda a entenderlo. Akamai lleva anos reposicionandose desde el CDN clasico hacia computo distribuido y seguridad. Un compromiso plurianual de 11.600 millones valida esa transicion mejor que cualquier campana comercial. Y para Anthropic, repartir su computo entre varios socios es una forma de asegurar capacidad en un mercado donde la escasez de recursos condiciona la hoja de ruta de producto.

    Que significa este movimiento para el mercado

    El primer efecto recae sobre los hyperscalers. Un contrato cloud de Anthropic con Akamai de esta escala demuestra que los grandes clientes de IA estan dispuestos a repartir cargas fuera del triangulo AWS-Azure-Google si un proveedor ofrece la relacion coste-rendimiento adecuada, sobre todo en CPU. Eso presiona precios y abre hueco a proveedores de segundo nivel con infraestructura distribuida.

    Para los competidores de Anthropic, la senal es que el gasto en inferencia agentica va a escalar tanto como en su dia lo hizo el de entrenamiento. Quien no asegure capacidad de computo general a precio competitivo tendra margenes peores al operar agentes en produccion. Los proveedores de hardware y nube que sepan optimizar CPU para estas cargas ganan una ventana de mercado que hace un ano parecia copada por las GPU.

    Para los compradores empresariales, el mensaje indirecto es util: la infraestructura detras de los agentes de IA no siempre necesita aceleradores caros. Al evaluar proveedores de agentes, conviene preguntar como distribuyen sus cargas y que impacto tiene eso en el coste por operacion que acabaran repercutiendo. La eficiencia en CPU puede traducirse en precios de API mas sostenibles a medio plazo.

    Analisis Blixel

    Durante dos anos el relato dominante ha sido que la IA se reduce a acumular GPU, y quien mas compre, gana. Este acuerdo mete un matiz importante en esa historia. Cuando un laboratorio de primera linea decide comprometer once mil millones en infraestructura orientada en buena parte a CPU, esta admitiendo que la fase de producto real, la de agentes ejecutandose sin parar, tiene una economia distinta a la del entrenamiento. Ahi el cuello de botella no es el aceleador grafico, sino el coste de sostener millones de tareas de logica y coordinacion.

    Nos parece un movimiento maduro y poco glamuroso, que es justo lo que suele funcionar. Diversificar proveedores reduce dependencia, y elegir CPU donde tiene sentido economico es sentido comun aplicado a la factura. La incognita es la ejecucion de Akamai: pasar de CDN a proveedor de computo para IA a esta escala no es trivial, y las cifras de ingresos que maneja son proyecciones, no hechos consumados. Si cumple, habra demostrado que hay vida rentable fuera de los tres grandes.

    Para las empresas espanolas la leccion es indirecta pero clara: el coste de operar IA en produccion depende de decisiones de infraestructura que casi nunca se ven. Antes de firmar con un proveedor de agentes, merece la pena entender que hay debajo, porque ese diseno acabara en vuestra factura.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • IA que disena su propio hardware: cuando llegara

    IA que disena su propio hardware: cuando llegara

    La IA que disena su propio hardware dejo de ser ciencia ficcion para convertirse en tema de debate serio. Anna Goldie y Azalia Mirhoseini, de Recursive Intelligence, subieron al escenario de TechCrunch Disrupt 2026 para discutir cuando los sistemas de inteligencia artificial empezaran a proyectar chips de forma autonoma, sin depender por completo de ingenieros humanos. Es una pregunta que interesa a cualquier empresa que dependa del computo, porque el cuello de botella del hardware condiciona cada avance en modelos y aplicaciones. Aqui separamos lo que se afirmo de lo que aun queda por demostrar.

    Que se dijo en Disrupt 2026 y por que importa

    Goldie y Mirhoseini centraron su intervencion en un horizonte concreto: el momento en que la IA que disena su propio hardware pase de asistir a decidir. Ambas provienen de un entorno donde el aprendizaje automatico ya se aplica al diseno de chips, y su mensaje fue de expectativa medida, no de anuncio de producto. No presentaron una fecha cerrada ni un sistema comercial listo para usar, sino una discusion sobre las condiciones que harian viable esa autonomia.

    El diseno de semiconductores es uno de los procesos mas costosos y lentos de la industria tecnologica. El floorplanning, la colocacion de bloques y el enrutado consumen meses de trabajo de equipos especializados. La idea de que un sistema aprenda a optimizar esas fases, y eventualmente a proponer arquitecturas completas, apunta directamente a ese cuello de botella. El interes que genero el panel refleja algo real: quien acelere el diseno de hardware acelera todo lo que viene despues, incluido el entrenamiento de los propios modelos de IA.

    Implicaciones tecnicas de la IA que disena su propio hardware

    La promesa de la IA que disena su propio hardware descansa sobre tecnicas que ya existen en forma parcial. El aprendizaje por refuerzo se ha usado para optimizar la colocacion de componentes en un chip, tratando el problema como un juego con recompensas asociadas a metricas de area, latencia y consumo. Lo que se debate ahora es hasta donde puede escalar esa aproximacion y si puede abarcar el diseno de extremo a extremo en lugar de fases aisladas.

    El salto de fondo no es trivial. Un sistema autonomo tendria que integrar restricciones fisicas, reglas de fabricacion de cada foundry, verificacion funcional y validacion termica, ademas de coordinar decisiones que hoy se reparten entre varios equipos. La autonomia real exige que la IA que disena su propio hardware genere disenos fabricables y verificables, no solo optimizados sobre el papel. Por eso el discurso de Recursive Intelligence fue prudente: la pregunta no es si es posible, sino cuando sera fiable y economicamente sensato delegar decisiones criticas a un sistema que aun necesita supervision humana en las etapas de mayor riesgo.

    Cuando y para quien sera relevante esto

    Conviene ordenar el horizonte. A corto plazo, la IA que disena su propio hardware seguira siendo una herramienta de asistencia dentro de flujos de diseno controlados por humanos, util para acelerar fases concretas como la colocacion o la exploracion de configuraciones. Quien lo notara primero son las grandes fabricantes de chips y los hiperescalares que disenan silicio propio para sus centros de datos, porque tienen el volumen, los datos y el presupuesto para financiar esa automatizacion.

    Para el resto del mercado, incluidas las PYMEs, el impacto sera indirecto y llegara mas tarde: en forma de hardware mas barato o mas eficiente, no como una herramienta que puedan usar directamente. No hay accion inmediata que tomar a raiz de este panel. Lo sensato es seguir la evolucion de estas tecnicas como un indicador del ritmo al que caera el coste del computo, sin tomar decisiones de infraestructura basadas en una capacidad que todavia no esta demostrada a escala comercial. El anuncio de Disrupt 2026 marca direccion, no disponibilidad.

    Analisis Blixel

    Automatizar el diseno de chips tiene una logica casi poetica: usar modelos de IA para construir el hardware que hara posibles modelos mejores. Ese bucle es tentador y explica el interes que despierta cualquier panel sobre el tema. Pero conviene distinguir el escenario de la fabrica. Un debate en un evento sirve para fijar direccion y atraer talento e inversion, no para confirmar que una tecnologia esta lista. Recursive Intelligence hizo bien en hablar de horizontes y no de fechas cerradas, y esa prudencia dice mas que cualquier titular.

    El diseno de semiconductores es un dominio donde un error no se corrige con un parche: se paga en silicio fabricado y descartado. Por eso la supervision humana no desaparecera pronto de las decisiones criticas, aunque la maquina asuma cada vez mas trabajo repetitivo. Lo interesante para quien observa el mercado no es la promesa de autonomia total, sino el efecto acumulado de automatizar fases concretas: menos meses de diseno, menos coste por iteracion, mas capacidad de experimentar. Ese es el impacto medible. Nuestra recomendacion es leer estos anuncios como termometros del ritmo de la industria, no como productos. Cuando la IA que disena hardware pase de los escenarios a las lineas de produccion con resultados verificables, sera el momento de prestar atencion practica. Hasta entonces, es una senal de hacia donde va el coste del computo.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • El Tamagotchi con IA de Meta se llama Muse Charm

    El Tamagotchi con IA de Meta se llama Muse Charm

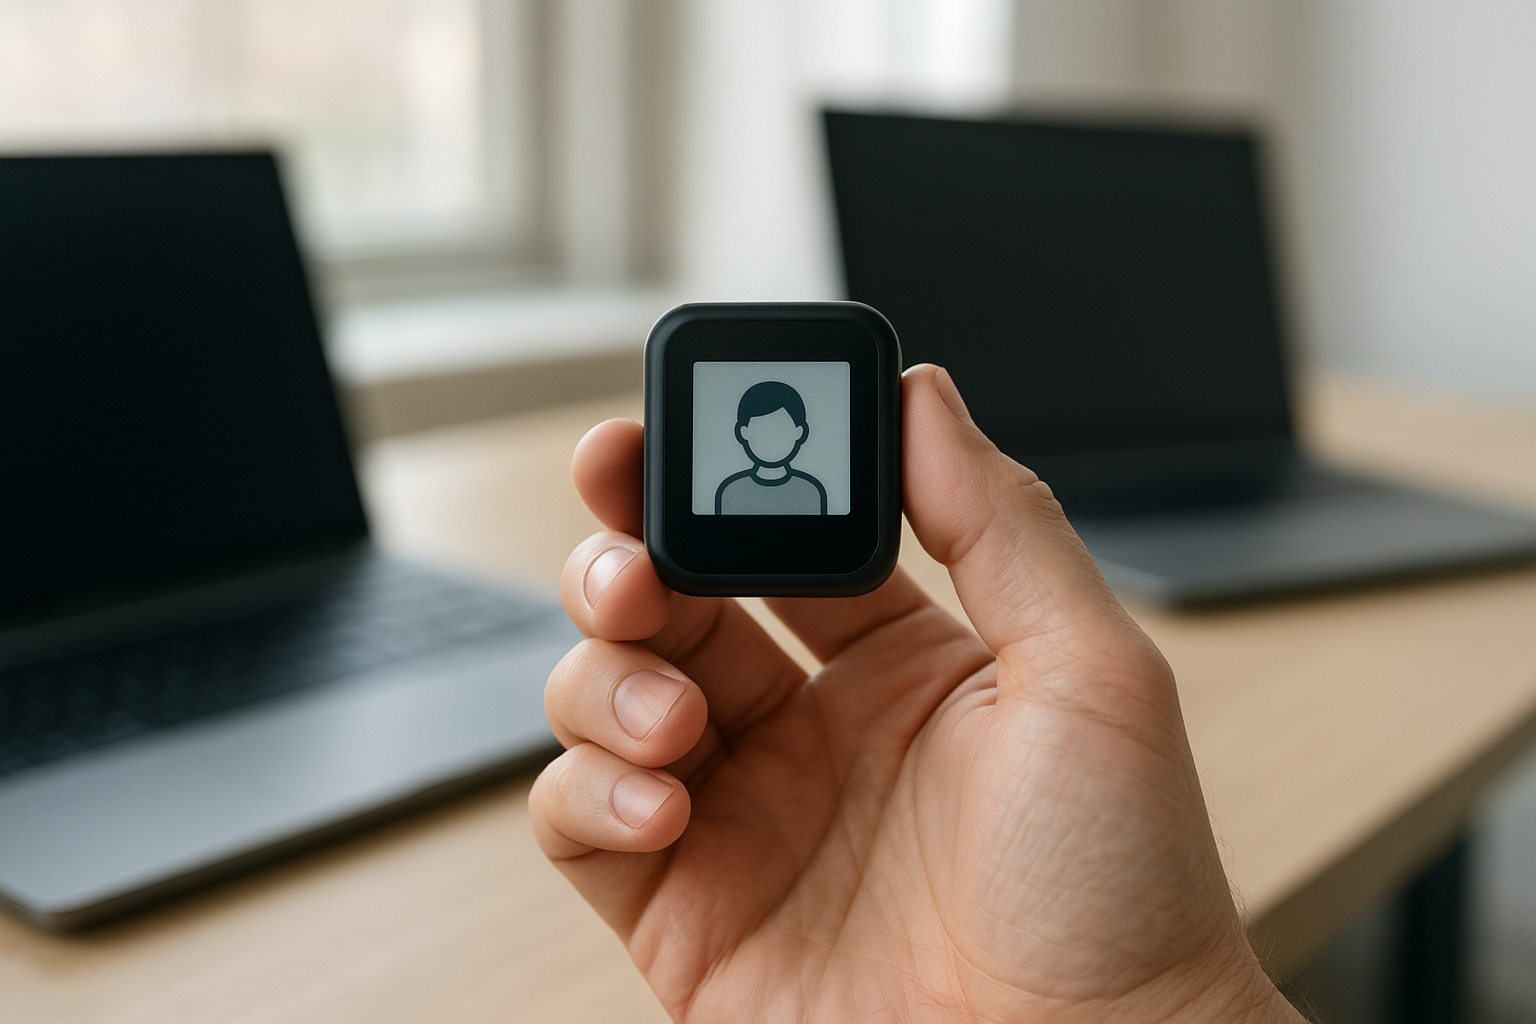
    Meta ha presentado el dispositivo con IA de Meta llamado Muse Charm, un aparato fisico que evoca de forma deliberada al Tamagotchi de los anos 90 pero que se apoya en tecnologia de inteligencia artificial mucho mas reciente. La jugada mezcla nostalgia y capacidades modernas en un formato de bolsillo, y encaja en una tendencia clara del sector: llevar la IA fuera de la pantalla del movil hacia objetos fisicos con los que interactuar. No es un juguete cualquiera, sino una senal de por donde exploran las grandes tecnologicas la relacion cotidiana con la IA.

    Que ha presentado Meta y por que importa

    El dispositivo con IA de Meta, Muse Charm, es un aparato fisico pensado como sucesor conceptual de la mascota virtual clasica. Donde el Tamagotchi original se limitaba a rutinas programadas y botones, Muse Charm incorpora las capacidades de IA que se han popularizado en los ultimos anos, aprovechando tendencias mucho mas recientes que el concepto de los 90 en el que se inspira estéticamente.

    La relevancia no esta tanto en el gadget en si como en lo que representa. Meta reconoce con este lanzamiento que hay apetito por interfaces fisicas de IA, mas alla de asistentes en el movil o el navegador. Es un movimiento coherente con la apuesta general de la compania por el hardware, desde las gafas hasta la realidad mixta.

    El Tamagotchi vendio decenas de millones de unidades a finales de los 90 basandose en un vinculo emocional simple. Meta reinterpreta esa formula con IA generativa, en un momento en que varias empresas experimentan con pines, colgantes y objetos de sobremesa que sustituyen o complementan la pantalla como punto de contacto con la inteligencia artificial.

    Implicaciones tecnicas y de mercado

    El dispositivo con IA de Meta abre una via interesante para fabricantes de hardware y desarrolladores. Un objeto fisico con IA plantea retos distintos a una app: autonomia de bateria, conectividad, latencia en las respuestas del modelo, y una experiencia de interaccion que no depende de tocar una pantalla constantemente. Resolver eso bien es dificil, y ahi es donde se juega la diferencia entre un capricho y un producto util.

    El formato tambien redefine expectativas. La nostalgia funciona como gancho de entrada, pero la retencion dependera de que la IA aporte algo real y no solo un envoltorio simpatico. Los intentos previos del sector de crear «el nuevo dispositivo de IA» han tenido resultados desiguales, precisamente porque el hardware llamativo no compensa una experiencia pobre.

    Para el ecosistema de hardware, Muse Charm confirma que las grandes tecnologicas buscan nuevos puntos de contacto con el usuario que no pasen por el smartphone. Eso genera oportunidades de negocio en componentes, accesorios y software, pero tambien eleva el liston: competir con la escala de fabricacion y distribucion de una empresa como Meta no esta al alcance de cualquiera.

    Analisis Blixel

    Un objeto fisico solo justifica su existencia si hace algo que el movil no hace mejor. Esa es la vara con la que hay que medir Muse Charm y a todos sus parientes. La nostalgia del Tamagotchi es un truco de marketing eficaz para abrir la conversacion, pero no sostiene un producto por si sola: quien lo compre volvera a olvidarlo en un cajon si la IA que lleva dentro no aporta valor tangible en el uso diario.

    Meta tiene musculo para intentarlo y datos suficientes para afinar la experiencia, algo que las startups del sector no tienen. Aun asi, la categoria de dispositivos de IA de bolsillo lleva un historial de promesas incumplidas. El patron se repite: hardware bonito, demo brillante, realidad decepcionante cuando el modelo tarda en responder o falla lo basico.

    Para una empresa que observa estas tendencias, la leccion no es correr a fabricar gadgets, sino entender que la IA se esta desprendiendo de la pantalla poco a poco. Todavia es pronto para saber si el formato fisico cuaja o queda como curiosidad. Lo sensato es mirar con atencion, medir la adopcion real y no confundir el ruido de un lanzamiento vistoso con una demanda demostrada. Si Meta consigue que la gente vuelva a cuidar de algo digital, habra encontrado un vinculo emocional que el resto llevaba anos persiguiendo.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Oracle activa fuerza mayor en su centro Stargate

    Oracle activa fuerza mayor en su centro Stargate

    El centro de datos Stargate en Nuevo Mexico se ha convertido en el primer sintoma serio de que la carrera por construir infraestructura de IA choca con la realidad fisica. Oracle ha enviado un aviso de fuerza mayor al desarrollador del Proyecto Jupiter, el campus que forma parte de la iniciativa Stargate, un mecanismo legal que le permitiria retrasar pagos si la instalacion no arranca operaciones en 2028. Detras del movimiento hay un problema muy concreto: el suministro de gas se ha retrasado casi seis meses. La noticia importa porque marca precedente para todo el sector.

    Que ha pasado y por que importa

    Oracle ha notificado formalmente una situacion de fuerza mayor al desarrollador del Proyecto Jupiter, el campus de centros de datos vinculado a Stargate en Nuevo Mexico. La clausula de fuerza mayor es un instrumento contractual habitual en grandes proyectos de infraestructura: permite a una de las partes suspender o retrasar sus obligaciones, en este caso los pagos, cuando circunstancias fuera de su control impiden cumplir los plazos acordados. El objetivo era tener la instalacion operativa en 2028.

    La causa directa esta en el suministro energetico. El campus esta disenado para manejar 2,45 gigavatios de potencia, una cifra que exige infraestructura de generacion y transporte a medida. El pipeline de gas de Energy Transfer, clave para alimentar la instalacion, se ha retrasado casi seis meses, hasta febrero de 2027. Ese desfase pone en riesgo toda la planificacion posterior y activa el mecanismo contractual que ahora invoca Oracle.

    El contexto es el de una fiebre inversora sin precedentes en infraestructura para IA. Stargate se anuncio como uno de los proyectos mas ambiciosos del sector, con campus de enorme consumo electrico repartidos por Estados Unidos. Nuevo Mexico, con suelo disponible y clima favorable para refrigeracion, encajaba sobre el papel. La realidad de conectar gigavatios de demanda a la red es otra historia.

    Implicaciones tecnicas y de mercado

    Un campus de 2,45 gigavatios no es un centro de datos convencional. Esa cifra equivale al consumo de una ciudad mediana y obliga a resolver simultaneamente generacion, transporte de energia, refrigeracion y permisos. El retraso del pipeline de gas de Energy Transfer expone el eslabon mas fragil de toda la cadena: la energia no se instala tan rapido como se despliegan GPUs. Mientras los fabricantes de chips aceleran, la infraestructura fisica avanza al ritmo de obras civiles y regulacion.

    El aviso de fuerza mayor tambien es una senal financiera. Oracle protege su flujo de caja ante un activo que no generara ingresos en el plazo previsto, y traslada parte del riesgo al desarrollador. Para los operadores de infraestructura, promotores energeticos y fondos que financian estos campus, el mensaje es que los plazos de 2028 anunciados con confianza estan sujetos a cuellos de botella muy tangibles.

    El caso del centro de datos Stargate en Nuevo Mexico refleja un patron que se repetira: la demanda de computo para IA crece mas rapido que la capacidad de la red electrica para absorberla. Los proyectos que dependan de nueva generacion de gas o de ampliaciones de red heredan esos plazos, con el consiguiente riesgo de sobrecostes y penalizaciones contractuales.

    Que significa este movimiento para el mercado

    Para los competidores de Oracle en la construccion de infraestructura de IA, el aviso de fuerza mayor por el centro de datos Stargate es una advertencia util: los cronogramas de estos macrocampus dependen menos de la disponibilidad de chips y mas de la energia. Quien haya cerrado contratos de suministro electrico firme, con generacion ya conectada, tiene ventaja competitiva real frente a quien dependa de infraestructura energetica aun por construir. Los proveedores de gas y las electricas pasan a ser cuello de botella estrategico, no un mero servicio.

    Para los desarrolladores y promotores, el precedente contractual es relevante. Que un cliente del tamano de Oracle active fuerza mayor por retrasos ajenos redistribuye el riesgo hacia quien construye. Es previsible que futuros contratos incorporen clausulas mas estrictas sobre plazos energeticos y garantias de suministro. Para los buyers de capacidad de computo, la leccion es de gestion de expectativas: las promesas de disponibilidad para 2028 deben leerse con cautela, verificando el estado real de la conexion electrica antes de comprometer cargas de trabajo criticas a un proveedor concreto.

    Analisis Blixel

    Durante meses hemos escuchado que el limite de la IA eran los chips. La realidad es mas prosaica: el limite es un gasoducto que llega seis meses tarde. Este episodio desmonta el relato de que basta con firmar contratos multimillonarios y encargar GPUs para tener capacidad de computo lista en un par de anos. La energia no se acelera con capital riesgo; se acelera con obra civil, permisos y redes que tardan lo que tardan.

    La activacion de fuerza mayor es una decision financiera sensata por parte de Oracle, pero tambien un reconocimiento implicito de que la planificacion original era optimista. Los 2,45 gigavatios sobre el papel son faciles de anunciar y dificiles de enchufar. Para cualquier empresa que este evaluando dependencia de estos macrocampus, la conclusion practica es clara: no confies en fechas de disponibilidad hasta que la infraestructura energetica este conectada y probada. Pregunta por el suministro electrico firme, no por el numero de aceleradores.

    El sector vive una fase en la que el marketing corre mas rapido que el hormigon. Los proyectos que sobrevivan a esta ola no seran los mas ambiciosos en el anuncio, sino los que hayan resuelto la ecuacion energetica antes de prometer plazos. Y eso, para quien contrata computo, deberia pesar mas que cualquier cifra de gigavatios en una presentacion.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Meta quita la camara a sus Ray-Ban por 349 dolares

    Meta quita la camara a sus Ray-Ban por 349 dolares

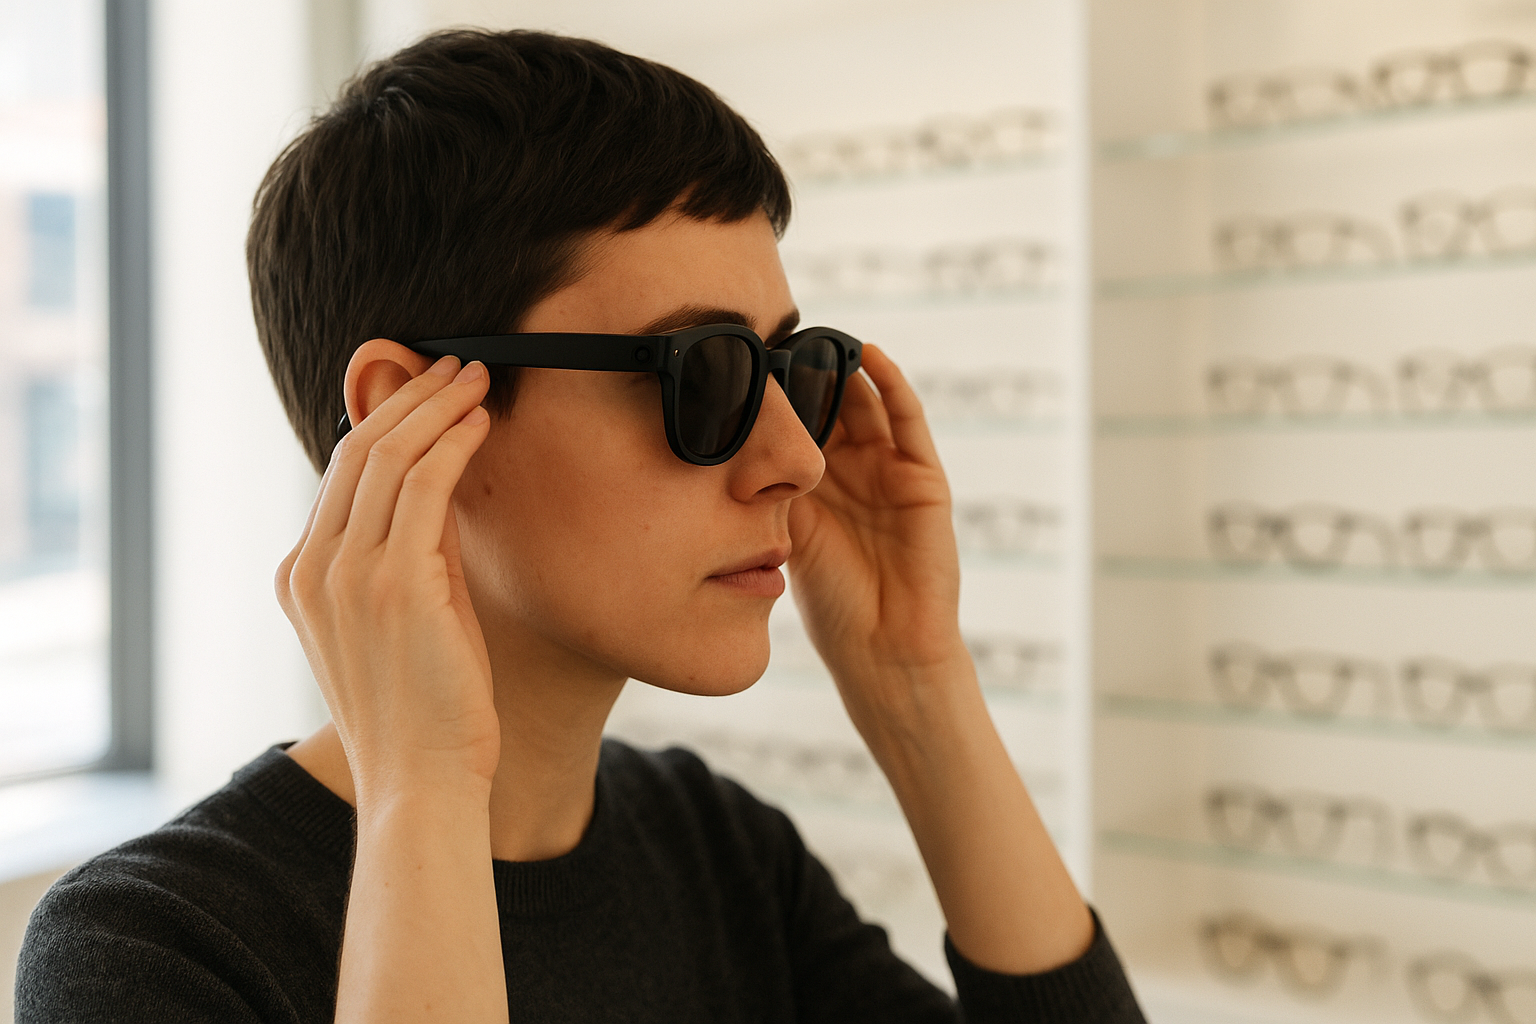
    Meta acaba de mover ficha con las gafas Ray-Ban Meta sin camara, un modelo que renuncia deliberadamente a grabar imagen y se centra solo en el audio. Cuestan 349 dolares, pesan 43 gramos y ofrecen hasta 12 horas de bateria. La decision no es tecnica sino reputacional: los modelos con camara se ganaron el apodo de gafas pervertidas por el uso para grabar a personas sin consentimiento. La preventa arranca el 13 de octubre con 23 combinaciones de colores y lentes, incluidos dos estilos nuevos, Clubmaster y Burbank. Un giro que dice mucho sobre el estado del mercado wearable.

    Que ha pasado y por que importa

    Las gafas Ray-Ban Meta sin camara son las primeras de la compania que eliminan el sensor de imagen por completo. En lugar de captura visual, el dispositivo se apoya en microfonos y altavoces integrados para llamadas, reproduccion de audio y asistente por voz. Con 43 gramos de peso y hasta 12 horas de autonomia, el planteamiento es el de unas gafas de uso diario que pasan desapercibidas, sin el foco de sospecha que arrastran las camaras montadas en la montura.

    El contexto explica el movimiento. Los modelos anteriores con camara generaron rechazo publico por la facilidad de grabar en entornos privados sin que nadie lo notara. Ese apodo despectivo se convirtio en un problema de percepcion que ninguna campana de marketing borra. Al lanzar unas gafas de audio, Meta ofrece una version del producto que reduce la friccion social. La preventa del 13 de octubre y las 23 combinaciones de colores y lentes, con los nuevos Clubmaster y Burbank, apuntan a un producto pensado para volumen y para el comprador que quiere el diseno Ray-Ban sin la carga de la camara.

    Implicaciones tecnicas y de mercado

    La ausencia de camara cambia la ecuacion del producto. Sin sensor de imagen ni el procesamiento asociado, el consumo energetico baja y eso justifica las 12 horas de bateria frente a la autonomia mas ajustada de los modelos con captura visual. Tambien simplifica el hardware y probablemente el coste de fabricacion, lo que encaja con un precio de 349 dolares que busca competir en el segmento de auriculares premium mas que en el de camaras ponibles.

    El mensaje de fondo es que la gafas Ray-Ban Meta sin camara reconoce que la privacidad es una barrera de adopcion real, no un detalle secundario. Meta esta segmentando: quien quiera grabar tendra su modelo con camara, y quien solo quiera audio y asistente por voz tendra una alternativa mas discreta. Es una estrategia de cartera clasica aplicada a un producto joven. Para el resto del sector wearable, la lectura es clara: el diseno social del dispositivo pesa tanto como sus especificaciones. Un producto puede ser tecnicamente solido y aun asi fracasar si genera incomodidad en el entorno donde se usa. La apuesta de audio es, en el fondo, un experimento sobre que estan dispuestos a aceptar los usuarios y quienes les rodean.

    Que lecciones deja esto a las empresas

    Aunque es un producto de consumo, la gafas Ray-Ban Meta sin camara deja una leccion aplicable a cualquier empresa que despliegue hardware o IA con sensores: la aceptacion social del producto es un requisito de diseno, no una consecuencia. Meta no retiro la camara por un fallo tecnico, sino porque el rechazo de terceros no usuarios lastraba la adopcion. Para una PYME que valore camaras inteligentes, sensores de audio o herramientas de captura en espacios compartidos, la conclusion es directa: antes de invertir, evalua como reaccionaran clientes, empleados y visitantes que no eligieron estar ante el dispositivo. Un despliegue de reconocimiento o grabacion mal comunicado genera friccion legal y reputacional que supera el ahorro operativo. La via razonable es ofrecer la version minima que resuelve el problema real, dejar la captura visual solo donde aporte valor claro y con consentimiento explicito, y comunicar de forma transparente que se recoge y por que. Meta acaba de pagar esa leccion en publico. Aprovechala tu sin repetir el coste.

    Analisis Blixel

    Renunciar a una funcion estrella para ganar aceptacion es una decision valiente y poco habitual en la industria del hardware, donde la tendencia es sumar sensores hasta que el dispositivo pesa mas que su utilidad. Meta ha entendido algo que muchos fabricantes ignoran: el enemigo de un producto ponible no siempre es la bateria o el precio, sino la mirada de quien esta al otro lado. Un apodo despectivo hizo mas dano a la imagen del producto que cualquier limitacion tecnica, y la respuesta ha sido quirurgica en lugar de defensiva. Nos parece acertado que la compania segmente en vez de imponer una unica version cargada de funciones. El comprador que quiere audio discreto por 349 dolares ahora tiene una opcion honesta, y el que quiere grabar sigue teniendo la suya. La duda es si el mercado percibira estas gafas como un producto de pleno derecho o como una version recortada del anterior. El precio no es bajo para lo que ofrece frente a unos auriculares convencionales, y ahi esta el riesgo real: convencer de que el formato gafas aporta suficiente valor sin la camara que lo hacia distinto. Si Meta logra que el asistente de voz y la comodidad justifiquen el desembolso, habra encontrado un nicho sostenible. Si no, sera un experimento caro sobre los limites sociales de la tecnologia ponible.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Muse Charm: el wearable de IA de Meta llega en 2026

    Muse Charm: el wearable de IA de Meta llega en 2026

    El wearable de IA de Meta tiene nombre y forma: Muse Charm, un dispositivo del tamano de la palma que la compania presento durante su evento Connect. Lleva integrado su agente Muse, con un avatar digital llamado Jolly en una pantalla pequena, y apuesta por un uso sin pantallas grandes ni aplicaciones. La idea es hablar con la IA por voz de forma inmediata, sin desbloquear el telefono. Meta situa el envio en diciembre de 2026, cuando termine de cerrar el diseno de los componentes. Aqui esta lo relevante para empresas y desarrolladores.

    Que ha presentado Meta y por que importa

    Muse Charm es un dispositivo portatil que cabe en la palma de la mano e incorpora el agente de IA Muse. En su pantalla aparece un avatar digital, Jolly, que actua como cara visible del asistente. El planteamiento del wearable de IA de Meta es directo: interactuar con la IA mediante voz sin tener que desbloquear el movil ni abrir una app. Un sensor de huellas ofrece acceso inmediato al dispositivo. Meta anuncio que empezara a enviar las unidades en diciembre de 2026, una vez finalizado el diseno de componentes.

    El formato recuerda deliberadamente a un Tamagotchi por su tamano y su avatar en miniatura, un guino que aleja al producto del lenguaje frio del hardware corporativo. La comparacion no es solo estetica: describe un objeto de bolsillo, siempre a mano, pensado para consultas rapidas por voz mas que para tareas complejas de escritorio. La ventana temporal, mas de un ano vista, indica que el producto sigue en fase de definicion de hardware y que el ecosistema de software alrededor de Muse tendra tiempo de madurar antes del lanzamiento.

    Implicaciones tecnicas del dispositivo

    La propuesta tecnica del wearable de IA de Meta gira en torno a reducir la friccion de acceso. Eliminar el paso de desbloquear el telefono y abrir una aplicacion cambia el patron de interaccion: la IA pasa de ser un destino dentro del movil a un objeto dedicado siempre disponible. El sensor de huellas como via de acceso apunta a un equilibrio entre inmediatez y control de identidad en el propio dispositivo.

    El avatar Jolly cumple una funcion que va mas alla de lo decorativo. Dar cara a un agente por voz ayuda a que el usuario entienda el estado del sistema (escuchando, procesando, respondiendo) sin depender solo del audio. Esa capa visual en una pantalla pequena es una decision de diseno de interaccion, no un adorno. El reto real del dispositivo estara en la latencia, la calidad del reconocimiento de voz en entornos ruidosos y en como se reparte el computo entre el propio aparato y la nube. Meta no ha detallado esos aspectos, y la fecha de envio tan lejana sugiere que buena parte de esas decisiones sigue abierta. Para desarrolladores, la incognita clave es si Muse admitira integraciones de terceros o quedara como un jardin cerrado.

    Como pueden aplicar esto las empresas hoy

    Con envio previsto para diciembre de 2026, la recomendacion para las empresas es no planificar despliegues sobre Muse Charm todavia, sino usar el anuncio como senal de tendencia. El movimiento confirma que el acceso a agentes de IA por voz mediante hardware dedicado va en serio, y eso justifica empezar a estandarizar ahora los flujos de trabajo que un dispositivo asi podria acelerar: consultas rapidas a bases de conocimiento, dictado, notas de campo o atencion en movilidad.

    El paso practico util a corto plazo es evaluar si los procesos internos de tu organizacion ganan realmente con interaccion por voz sin pantalla. En logistica, mantenimiento o comercio, donde las manos estan ocupadas, el retorno puede ser tangible; en trabajo de oficina sentado, probablemente no aporte frente a un asistente en el propio ordenador. Antes de comprometer presupuesto, conviene pilotar la interaccion por voz con las herramientas ya disponibles y medir errores de reconocimiento y tiempo ahorrado. Lo que hay que evitar es reservar dispositivos por moda: un producto a mas de un ano vista puede cambiar de especificaciones, precio o incluso cancelarse.

    Analisis Blixel

    Un dispositivo dedicado solo se justifica si resuelve algo que el movil no resuelve bien, y ahi es donde la mayoria de estos experimentos han tropezado. El historial reciente del hardware de IA de bolsillo es incomodo: varios intentos de crear el objeto que sustituye a la app terminaron devueltos por usuarios que no encontraban una razon para llevar un aparato mas. Meta parte con dos ventajas frente a esos casos: escala industrial y un agente propio ya integrado en su ecosistema. Pero la fecha de envio en diciembre de 2026 dice mucho. Anunciar hoy algo que llega dentro de mas de un ano es tanto una declaracion de intenciones como una forma de reservar terreno en la conversacion sobre el hardware de IA. El riesgo es que el producto nazca desfasado si los asistentes por voz en el telefono y en las gafas inteligentes avanzan mas rapido. La comparacion con un Tamagotchi es simpatica, pero tambien un recordatorio: aquel objeto triunfo por afecto, no por productividad. Para que un aparato asi funcione en entornos profesionales necesita fiabilidad, integracion real con sistemas de la empresa y un caso de uso claro donde tener las manos libres marque la diferencia. Hasta que Meta no publique especificaciones concretas de latencia, privacidad del audio y apertura a terceros, lo sensato es tratarlo como una apuesta a vigilar, no como una herramienta en la que basar decisiones de compra.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Qualcomm mete un modelo de 30.000M en el movil

    Qualcomm mete un modelo de 30.000M en el movil

    Qualcomm ha presentado los Snapdragon 8 Elite Gen 6 y su version Extreme, dos procesadores que empujan la IA local en el movil a un terreno que hasta ahora exigia servidores. La novedad no es solo mas potencia bruta: son nuevos hubs de sensores capaces de correr modelos de hasta 200 millones de parametros de forma continua, y una version Extreme que ejecuta un modelo MoE de 30.000 millones de parametros directamente en el dispositivo. Para quien desarrolla aplicaciones, esto cambia el calculo entre lo que se procesa en el telefono y lo que se envia a la nube.

    Que ha presentado Qualcomm y por que importa

    Los dos chips anunciados son el Snapdragon 8 Elite Gen 6 y el Snapdragon 8 Elite Extreme Gen 6. Ambos comparten el foco en la IA local en el movil, pero se diferencian en el techo de lo que pueden ejecutar sin conexion. La familia estandar incorpora hubs de sensores que corren modelos de hasta 200 millones de parametros de forma persistente, pensados para tareas siempre activas como deteccion de contexto, personalizacion o agentes de voz que responden sin latencia de red.

    La version Extreme sube el listado de forma notable: ejecuta un modelo MoE (Mixture of Experts) de 30.000 millones de parametros localmente. Como referencia comparativa, Apple presento en su WWDC de junio un modelo de 20.000 millones, de modo que el chip de Qualcomm supera esa cifra en el propio hardware del telefono. Esta capacidad abre la puerta a agentes de voz completos, asistentes personalizados y funciones que hasta ahora dependian de servidores externos, con las implicaciones de privacidad y coste que eso conlleva.

    Implicaciones tecnicas de la IA local en el movil

    El salto relevante no es la cifra de parametros por si sola, sino donde se ejecuta. Correr un modelo MoE de 30.000 millones sin pasar por la nube significa eliminar la latencia de red, funcionar sin cobertura y no enviar datos sensibles a servidores de terceros. Los hubs de sensores dedicados permiten mantener modelos activos de forma continua con un consumo controlado, algo clave en un dispositivo con bateria. La arquitectura MoE ayuda aqui: activa solo una parte de los expertos del modelo en cada inferencia, reduciendo el coste computacional frente a un modelo denso equivalente.

    Para los equipos de desarrollo, esto redefine la frontera entre procesamiento en dispositivo y en servidor. Tareas que antes se delegaban a APIs de pago ahora pueden ejecutarse en el terminal del usuario, lo que reduce el gasto recurrente de inferencia en la nube y elimina un punto de friccion de privacidad. La IA local en el movil tambien cambia el diseno de producto: un agente de voz que funciona sin conexion es una propuesta distinta a uno que se cae cuando falla la red. El coste se traslada del OPEX de la nube al hardware que ya paga el usuario.

    Como pueden aplicar esto las empresas hoy

    Si desarrollas una app movil con funciones de IA, el primer paso practico es identificar que cargas pueden bajar al dispositivo. La IA local en el movil es idonea para transcripcion, resumen, asistentes de voz y personalizacion que hoy pagas por API. Migrar esas tareas al terminal reduce el coste de inferencia por usuario, que en volumen es donde mas duele. Evita, sin embargo, prometer la funcion a toda tu base: estos modelos de 30.000 millones solo corren en la gama alta con la version Extreme, asi que necesitaras una estrategia de degradacion elegante para dispositivos mas modestos. Antes de invertir, mide el ROI real: cuanto gastas hoy en inferencia en la nube frente al esfuerzo de portar los modelos y mantener dos rutas de ejecucion. Para PYMEs sin equipo de ML propio, lo sensato es empezar con las funciones que Qualcomm y los fabricantes expongan via SDK, no construir tu propio pipeline de cuantizacion desde cero. Y no ignores el soporte: apostar solo por hardware de gama alta limita tu mercado potencial, sobre todo fuera de mercados premium.

    Analisis Blixel

    Durante anos la promesa de correr modelos grandes en el telefono choco con la realidad de la bateria y el calor. Que un chip ejecute 30.000 millones de parametros de forma local es un hito tecnico real, pero conviene separar el titular del uso cotidiano. La mayoria de aplicaciones no necesitan un modelo de ese tamano corriendo en el bolsillo; necesitan que la funcion concreta responda rapido y sin fugas de datos, y para eso los modelos de 200 millones en los hubs de sensores probablemente aporten mas valor practico que la version Extreme. La comparacion con Apple es marketing legitimo, pero el numero de parametros dice poco sobre la experiencia final: importa mas la calidad del modelo, la cuantizacion y como se integra en el sistema operativo. El riesgo para quien desarrolla es dejarse arrastrar por la carrera de cifras y disenar para hardware que solo tiene una fraccion de sus usuarios. La lectura sensata es que el edge se vuelve una opcion viable para cargas concretas, no un sustituto total de la nube. Quien sepa repartir el trabajo entre dispositivo y servidor, y medir el ahorro real, sacara partido. Quien busque un titular para su web, se quedara con un chip caro infrautilizado.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • El 60% de EE UU rechaza los data centers de IA

    El 60% de EE UU rechaza los data centers de IA

    La oposicion a los data centers de IA ha dejado de ser una preocupacion marginal para convertirse en un obstaculo real. Segun datos recientes, mas del 60% de los estadounidenses se muestra en contra de la construccion de nuevos centros de datos dedicados a inteligencia artificial. Un estudio etnografico de 18 meses en Pensilvania documenta que ese rechazo no viene de un solo grupo, sino de sectores muy distintos: ambientalistas, vecinos preocupados por sus facturas electricas y propietarios que temen por el valor de sus casas. Y ya tiene consecuencias medibles sobre las inversiones.

    Que ha pasado y por que importa

    La resistencia a los data centers de IA se ha materializado en cifras concretas. Durante el segundo trimestre de 2026, proyectos de centros de datos valorados en 68.000 millones de dolares quedaron interrumpidos por la oposicion local, segun Data Center Watch. No hablamos de protestas simbolicas, sino de bloqueos que afectan directamente a los planes de expansion de infraestructura computacional que las grandes empresas de IA consideran imprescindibles.

    El estudio etnografico realizado en Pensilvania a lo largo de 18 meses aporta el detalle que suele faltar en este debate: quien se opone y por que. Los ambientalistas apuntan al consumo energetico y al agua necesaria para refrigeracion. Los residentes se centran en algo mucho mas inmediato: el temor a que sus facturas electricas suban y a que el valor de sus viviendas caiga por la cercania de estas instalaciones. Esa mezcla de motivaciones convierte la oposicion en un frente dificil de desarticular con un unico mensaje corporativo.

    El contexto es una carrera sin precedentes por la capacidad de computo. Entrenar y servir modelos de IA exige una infraestructura que consume energia a una escala industrial, y esa demanda choca de lleno con comunidades que no ven un beneficio proporcional al impacto que asumen.

    Implicaciones de mercado

    La oposicion a los data centers de IA introduce una variable que muchas hojas de ruta corporativas no habian ponderado bien: el riesgo social y regulatorio local. Cuando 68.000 millones en proyectos se frenan en un solo trimestre, el mensaje para los inversores es claro. La disponibilidad de terreno, energia y agua ya no basta; hace falta tambien licencia social para operar. Esa fase, que antes se daba por descontada, se ha vuelto un cuello de botella tan critico como la escasez de GPU o de suministro electrico.

    Para las empresas de IA con planes de inversion billonarios, esto encarece y ralentiza el despliegue. Los tiempos de aprobacion se alargan, los costes legales aumentan y la incertidumbre sobre que proyectos saldran adelante complica la planificacion de capacidad. La diversidad de la oposicion agrava el problema: no basta con negociar con un grupo ambientalista, porque el vecino preocupado por su factura tiene motivaciones distintas y a menudo mas emocionales.

    El resultado probable es una redistribucion geografica. Las regiones que ofrezcan energia abundante, marcos claros y comunidades dispuestas a acoger estas instalaciones ganaran peso frente a las que se conviertan en focos de conflicto. La oposicion a los data centers de IA esta, de hecho, redibujando el mapa de la infraestructura.

    Que significa este movimiento para el mercado

    Para los operadores de infraestructura, la leccion es que la fase de relaciones con la comunidad debe adelantarse al inicio del proyecto, no gestionarse como una crisis reactiva. Los competidores que integren transparencia sobre consumo energetico, compromisos de compensacion a residentes y acuerdos verificables sobre precios electricos partiran con ventaja frente a quienes lleguen con el proyecto ya cerrado. Los proveedores de energia renovable y de sistemas de refrigeracion eficientes ganan protagonismo, porque reducir el impacto ambiental es ahora un argumento de viabilidad, no de marketing. Para los buyers de servicios cloud e IA, el efecto llega por otra via: si la oposicion a los data centers de IA encarece o retrasa la capacidad, los precios de computo pueden tensionarse y los plazos de aprovisionamiento alargarse. Conviene diversificar proveedores y regiones. Y para las administraciones locales, el conflicto abre una oportunidad de negociacion: exigir contrapartidas reales antes de conceder permisos.

    Analisis Blixel

    Durante anos, el discurso dominante presento la infraestructura como un problema puramente tecnico: mas chips, mas megavatios, mas terreno. Lo que este caso demuestra es que el limite no siempre esta en la ingenieria, sino en la aceptacion de quienes viven al lado de las instalaciones. Y ahi la industria ha sido notablemente torpe. Prometer empleo abstracto y progreso genoerico no convence a alguien que teme abrir su factura de la luz o vender su casa por menos de lo que vale.

    La cifra de 68.000 millones frenados en un trimestre no es una anecdota, es una senal de que el modelo de crecimiento a cualquier coste ya encuentra fricion tangible. Las empresas que lo entiendan dejaran de tratar a las comunidades como un tramite administrativo y empezaran a negociar de verdad: tarifas electricas protegidas, transparencia sobre el consumo de agua, compensaciones medibles. Las que no lo hagan seguiran acumulando proyectos bloqueados.

    Para las empresas espanolas que dependen de estos servicios, el aviso es indirecto pero real. La capacidad de computo no es infinita ni barata, y los cuellos de botella sociales al otro lado del Atlantico acaban notandose en los precios y los plazos. Planificar con margen y no atarse a un unico proveedor deja de ser prudencia para convertirse en necesidad.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Googlebook: el portatil con Gemini que reta a Microsoft

    Googlebook: el portatil con Gemini que reta a Microsoft

    Google ha presentado el portatil con Gemini integrado llamado Googlebook, un equipo de 899 dolares que lleva su modelo de IA directamente al sistema operativo. La jugada no es solo vender hardware: es empujar a las empresas a procesar tareas de IA en local en lugar de depender siempre de la nube. Con esta apuesta, Google entra de lleno en el terreno que Microsoft abrio con sus Copilot+ PCs y plantea una pregunta incomoda para cualquier equipo de TI que ya paga por servicios de IA en cloud: cuando compensa tener la potencia en la propia maquina.

    Que ha presentado Google y por que importa

    El Googlebook es un portatil de 899 dolares que integra Gemini de forma nativa en el sistema operativo, no como una aplicacion adicional ni una extension. Segun ha comunicado Google, el objetivo es que las tareas de IA se ejecuten localmente en el dispositivo, reduciendo la latencia y disminuyendo la dependencia de servicios en la nube. El movimiento situa a la compania en competencia directa con los Copilot+ PCs de Microsoft, la categoria de portatiles optimizados para IA que Microsoft impulsa desde hace meses.

    El contexto ayuda a entender la decision. Hasta ahora, la mayoria de funciones de IA generativa dependian de enviar datos a servidores remotos, procesarlos y devolver el resultado. Ese modelo funciona, pero acumula costes de suscripcion, introduce latencia y obliga a mover informacion fuera de la organizacion. El portatil con Gemini integrado plantea un camino distinto: parte del trabajo ocurre en el propio equipo. Es la misma logica que persigue Microsoft con su hardware, y confirma que los grandes fabricantes ven el dispositivo del usuario como el proximo frente de batalla de la IA.

    Implicaciones tecnicas de mover la IA al dispositivo

    Llevar un modelo como Gemini al sistema operativo tiene consecuencias concretas. La primera es la latencia: si el procesamiento ocurre en local, las respuestas no dependen de la calidad de la conexion ni de la carga de los servidores. La segunda es el control del dato: ejecutar tareas en el equipo reduce la necesidad de enviar informacion sensible a la nube, un punto relevante para sectores con requisitos estrictos de privacidad. El portatil con Gemini integrado se apoya precisamente en estos dos argumentos para justificar su precio de 899 dolares.

    Ahora bien, el procesamiento local no elimina la nube, la complementa. Los modelos que caben y funcionan con fluidez en un portatil son mas limitados que los que corren en centros de datos, asi que lo previsible es un reparto: tareas ligeras y sensibles en local, cargas pesadas en remoto. Para los equipos tecnicos, esto abre una decision de arquitectura que antes no existia en el escritorio. El portatil con Gemini integrado no sustituye una estrategia de IA en cloud; anade una capa que hay que dimensionar bien. Y frente a los Copilot+ PCs, la ventaja de Google esta en tener su propio modelo y su ecosistema de servicios detras.

    Como pueden aplicar esto las empresas hoy

    Antes de comprar flotas de un portatil con Gemini integrado, conviene medir. La primera pregunta es cuantas de las tareas de IA que ya usa la plantilla se beneficiarian realmente del procesamiento local: transcripciones, resumenes de documentos internos o asistencia ofimatica son buenos candidatos por su sensibilidad y frecuencia. Si el uso de IA es esporadico, el sobrecoste del hardware frente a un portatil convencional mas una suscripcion cloud puede no compensar.

    El segundo paso es un piloto acotado: un grupo reducido de usuarios, tareas concretas y metricas claras de latencia, ahorro en llamadas a la nube y satisfaccion real. Conviene evitar el error de asumir que «IA en local» equivale a «gratis»: el modelo se actualiza, el hardware se amortiza y la formacion cuesta. Para una PYME, el escenario mas sensato es no renovar todo el parque de golpe, sino incorporar estos equipos en los perfiles que mas dependen de IA a diario. Y ojo con el bloqueo de proveedor: atar el hardware a un unico modelo condiciona decisiones futuras.

    Analisis Blixel

    Durante dos anos la industria nos ha vendido que el futuro de la IA estaba exclusivamente en la nube. Ahora los mismos actores empujan hacia el dispositivo. No es contradiccion, es negocio: vender hardware con margen y fidelizar al usuario dentro de un ecosistema propio es mas rentable que competir solo en suscripciones. Por eso conviene leer el lanzamiento del Googlebook con distancia critica. El procesamiento local tiene ventajas reales en latencia y privacidad, pero el argumento se infla facilmente. Un portatil con Gemini integrado no elimina la nube ni convierte a cualquier empresa en autonoma en materia de IA. Para la mayoria de PYMEs espanolas, la pregunta no es si el hardware con IA es el futuro, sino si resuelve un problema que hoy tienen y cuanto cuesta frente a la alternativa que ya usan. La competencia con Microsoft es buena noticia porque presiona precios y acelera mejoras, pero tambien fragmenta el mercado: elegir bando ahora tiene coste de salida. Nuestra recomendacion es pragmatica. Ignore el ruido del anuncio y haga numeros con sus casos de uso reales. Si sus equipos manejan datos sensibles a diario y la latencia les frena, un piloto merece la pena. Si no, espere: la primera generacion de cualquier categoria de hardware suele ser la mas cara y la menos madura, y la segunda casi siempre lo hace mejor.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • AWS reduce hasta un 82% la latencia de inferencia GPU

    AWS reduce hasta un 82% la latencia de inferencia GPU

    El enrutamiento de inferencia LLM en GPU acaba de recibir una pieza que faltaba en muchos despliegues reales. Amazon Web Services ha presentado SageMaker HyperPod Inference Gateway, un sistema de enrutamiento nativo de Kubernetes que reparte las peticiones de inferencia entre clusters de GPU segun el estado real de cada nodo. El objetivo es concreto: dejar de desperdiciar GPU caras porque unas peticiones se amontonan en pods ocupados mientras otros estan parados. AWS afirma que reduce la latencia del primer token hasta un 82% y se instala como addon de EKS sin tocar las aplicaciones existentes.

    Que ha pasado y por que importa

    SageMaker HyperPod Inference Gateway es un componente de enrutamiento que se coloca delante de los pods que sirven modelos en un cluster de GPU. En lugar de repartir peticiones de forma ciega, como haria un balanceador de carga clasico por round-robin, decide a que pod enviar cada peticion en funcion del estado real de las GPU: carga, disponibilidad y ocupacion en ese momento. El resultado directo, segun AWS, es una reduccion de la latencia del primer token de hasta el 82% en escenarios donde el desequilibrio de carga era el cuello de botella.

    El detalle relevante para equipos tecnicos es que se instala como un addon de Amazon EKS y no exige cambios en las aplicaciones ya desplegadas. Esto baja mucho la barrera de adopcion: no hay que reescribir el codigo de servicio ni cambiar la logica de la aplicacion cliente. El enrutamiento de inferencia LLM en GPU pasa a gestionarse en la capa de infraestructura, donde tiene mas sentido, y no dispersado por cada servicio. Para quien ya opera modelos sobre Kubernetes en AWS, es un anadido que encaja en el stack actual.

    Implicaciones tecnicas del enrutamiento de inferencia

    El problema que ataca es viejo y caro. Servir modelos grandes no se parece a servir peticiones web ligeras: cada inferencia consume memoria y tiempo de GPU de forma desigual, y un balanceador que ignore ese estado acaba saturando unos pods mientras otros quedan ociosos. Ese desperdicio se paga en dinero, porque las instancias GPU estan entre las mas caras del catalogo cloud, y en experiencia de usuario, porque la latencia del primer token se dispara cuando la peticion aterriza en un pod colapsado.

    Al ser nativo de Kubernetes, el gateway lee el estado real del cluster y dirige cada peticion al pod mas adecuado. Esto convierte el enrutamiento de inferencia LLM en GPU en una decision informada, no en una loteria. La cifra del 82% es un techo, no una media garantizada: depende de cuanto desequilibrio hubiera antes. Un cluster ya bien balanceado vera mejoras menores; uno con picos irregulares y colas mal repartidas es donde mas se nota. La instalacion como addon de EKS tambien significa que el ciclo de vida del componente se gestiona con las herramientas estandar de Kubernetes, sin un plano de control paralelo que mantener.

    Como pueden aplicar esto las empresas hoy

    Si ya sirves modelos propios o open source sobre EKS con GPU, la evaluacion es directa: mide tu latencia de primer token y la ocupacion de GPU por pod antes de instalar nada. Sin esa linea base no sabras si el 82% aplica a tu caso o si tu problema es otro. El enrutamiento de inferencia LLM en GPU solo compensa cuando el cuello de botella es el reparto de carga; si tu latencia viene del tamano del modelo o de GPU insuficientes, este gateway no lo arregla.

    El ROI aqui es medible en horas de GPU ahorradas. Si el enrutamiento mejora la ocupacion, puedes servir el mismo trafico con menos instancias o absorber picos sin escalar. Que evitar: instalarlo por defecto sin medir, o esperar que resuelva un dimensionamiento mal planteado. Para PYMEs que consumen modelos via API de terceros esto no aplica; es para quien opera su propia infraestructura de inferencia. Empieza por un entorno de staging, compara metricas reales y decide con datos, no con la cifra del anuncio.

    Analisis Blixel

    Hay una tendencia clara en el cloud que este lanzamiento confirma: la ventaja competitiva en IA ya no esta solo en el modelo, sino en la eficiencia con la que lo sirves. Servir inferencia es donde se quema el presupuesto mes a mes, y cada punto de ocupacion de GPU que recuperas se traduce en factura mas baja. AWS lo sabe y por eso mueve la optimizacion a la capa de infraestructura, donde el cliente no tiene que pensar en ella.

    Lo que nos gusta es el enfoque honesto de «addon sin cambios en la aplicacion»: reduce friccion y respeta el stack que ya tienes. Lo que pedimos con calma es escepticismo ante el 82%. Es un numero de laboratorio en el peor escenario posible, no una promesa universal. Cualquier equipo serio debe medir su propia linea base antes y despues, porque la mejora real depende de lo desequilibrado que estuviera tu cluster de partida. Tambien conviene recordar que esto ata mas a EKS y al ecosistema AWS; es comodo, pero es dependencia. Para quien ya vive en ese ecosistema y opera modelos propios, es un anadido sensato que ataca un problema real y caro. Para quien consume IA via API, es ruido. La pregunta correcta no es si funciona, sino si tu cuello de botella es el que este componente resuelve.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.