
Categoría: Hardware y Cómputo

  • Huawei prepara su chip de IA para 2027 frente a Nvidia

    Huawei prepara su chip de IA para 2027 frente a Nvidia

    El nuevo chip de IA de Huawei tiene fecha: el primer trimestre de 2027. La compania china ha confirmado que desarrolla un procesador especializado para inteligencia artificial con la intencion de plantar cara a Nvidia en un mercado donde la demanda supera con creces la oferta. El anuncio no es un lanzamiento, sino una declaracion de intenciones a dos anos vista. Y ahi esta el matiz importante: hablamos de estrategia de mercado, no de un producto que puedas comprar hoy. Conviene entender que se juega Huawei, que se juega Nvidia y que cambia para quien compra hardware de computo.

    Que ha anunciado Huawei y por que importa

    Huawei ha comunicado el desarrollo de un chip de IA cuyo lanzamiento esta previsto para el primer trimestre de 2027. El objetivo declarado es competir de forma directa con las GPU de Nvidia en el segmento de hardware especializado para inteligencia artificial. La compania enmarca el movimiento dentro de una estrategia mas amplia: consolidarse como proveedor independiente de semiconductores para IA, sin depender de terceros. El anuncio del nuevo chip de IA de Huawei llega en un momento de tension: la demanda de aceleradores para entrenar e inferir modelos es altisima y las restricciones comerciales limitan el acceso a determinada tecnologia segun la geografia del comprador.

    El contexto explica el calendario. Nvidia domina el mercado de aceleradores para IA con una cuota abrumadora, lo que ha generado listas de espera, precios elevados y una dependencia incomoda para muchos operadores. Cualquier alternativa creible atrae atencion, y mas si procede de un fabricante con capacidad industrial contrastada. El nuevo chip de IA de Huawei apunta precisamente a ese hueco: ofrecer una via distinta a compradores que hoy tienen pocas opciones reales fuera de un unico proveedor dominante.

    Implicaciones de mercado del nuevo chip de IA de Huawei

    Anunciar un chip con dos anos de antelacion cumple una funcion clara: senalizar al mercado. Huawei comunica a clientes, inversores y competidores que va en serio con el hardware para IA, y lo hace antes de tener producto para fijar expectativas y captar interes temprano. En un sector donde las decisiones de compra de infraestructura se planifican con mucha anticipacion, avisar pronto tiene sentido comercial. Tambien es una manera de recordar que la dependencia de un solo proveedor de aceleradores no tiene por que ser permanente.

    Para el ecosistema, el nuevo chip de IA de Huawei introduce una variable de presion competitiva. La cuestion no es solo el rendimiento bruto del silicio, sino el software que lo rodea: el valor de Nvidia reside tanto en sus GPU como en CUDA y en un ecosistema de herramientas maduro. Un chip competitivo en 2027 tendra que ofrecer una ruta de migracion razonable, compatibilidad con los frameworks habituales y soporte real. Sin ese andamiaje, la potencia por si sola no basta. El anuncio marca la ambicion; la ejecucion tecnica y de ecosistema decidira si el movimiento tiene recorrido.

    Que significa este movimiento para el mercado

    Para los competidores, la senal es que el segmento de aceleradores para IA seguira atrayendo entrantes con musculo industrial, lo que a medio plazo puede aliviar la escasez y presionar precios. Para Nvidia, no es una amenaza inmediata (2027 esta lejos y su ventaja de ecosistema es profunda), pero si un recordatorio de que su cuota dominante genera incentivos fuertes para que otros inviertan en alternativas. Para los compradores de hardware, la lectura util es de planificacion: cualquier decision de infraestructura tomada hoy debe asumir que el mapa de proveedores en 2027 sera mas amplio que el actual. Eso aconseja evitar dependencias contractuales rigidas a muy largo plazo y disenar arquitecturas que no queden atadas de forma irreversible a un unico stack. Para los proveedores de servicios cloud y datacenters, un segundo actor con capacidad real de suministro es una palanca de negociacion y una forma de reducir riesgo de concentracion. La cautela obligada: es un anuncio a dos anos, sin especificaciones publicas ni rendimiento verificable, y en hardware los calendarios se deslizan con facilidad.

    Analisis Blixel

    Anunciar silicio con dos anos de margen es, sobre todo, un ejercicio de posicionamiento. Funciona para captar titulares y tranquilizar a clientes que temen depender de un solo proveedor, pero conviene no confundir una hoja de ruta con un producto en el rack. En hardware, la distancia entre el anuncio y el chip que rinde en produccion esta llena de retrasos, revisiones y sorpresas de fabricacion. La historia del sector lo demuestra una y otra vez. Dicho esto, la direccion es sana: el mercado de aceleradores necesita mas de un actor con capacidad industrial real, y la competencia beneficia a quien compra. El verdadero campo de batalla no sera la cifra de teraflops, sino el software. Nvidia no domina solo por sus GPU, sino por CUDA y por una decada de herramientas que los equipos ya conocen. Cualquier alternativa que quiera cuota tendra que resolver la migracion sin obligar a reescribir medio pipeline. Para una empresa espanola que hoy planifica infraestructura, la recomendacion es pragmatica: no cambies de planes por un anuncio a 2027, pero disena con la vista puesta en la portabilidad. No te ates a contratos rigidos ni a arquitecturas que solo funcionen con un unico proveedor. La opcionalidad es el activo mas valioso en un mercado que, por fin, empieza a moverse.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Snap vende sus gafas de AR a 2.200 dolares

    Snap vende sus gafas de AR a 2.200 dolares

    Snap vuelve a la carga con un argumento difícil de sostener: convencer al mercado de que unas gafas inteligentes Spectacles de 2.200 dólares valen lo que cuestan. La compañía insiste en que el precio se justifica por las capacidades avanzadas de realidad aumentada del dispositivo, orientado sobre todo a desarrolladores que quieran construir aplicaciones inmersivas. No es un producto de consumo masivo ni pretende serlo. Es una apuesta de nicho, cara, en un segmento donde nadie ha demostrado todavía que exista demanda real más allá de la experimentación técnica.

    Que ha pasado y por que importa

    Snap ha reactivado la promoción de sus gafas inteligentes Spectacles con un precio de 2.200 dólares, posicionándolas como un producto premium dentro del segmento de wearables de realidad aumentada. El público objetivo no es el usuario final, sino los desarrolladores de AR: personas y equipos que quieran crear experiencias inmersivas sobre el hardware de Snap. La compañía argumenta que ese coste elevado responde a las capacidades técnicas del dispositivo, pensado para prototipar y ejecutar aplicaciones de realidad aumentada de forma avanzada.

    El movimiento importa porque expone la tensión de fondo del mercado de gafas inteligentes: hardware potente sin un caso de uso claro que empuje su adopción. Snap lleva años iterando sobre las Spectacles, y cada nueva versión llega con la misma promesa de que ahora sí la AR está madura. Mantener el foco en desarrolladores es un reconocimiento implícito de que el gran público todavía no está preparado para pagar estas cifras por unas gafas que compiten con el smartphone que ya lleva en el bolsillo.

    Implicaciones tecnicas y de mercado

    Vender unas gafas inteligentes Spectacles de 2.200 dólares a desarrolladores es una estrategia deliberada de sembrado de ecosistema. La idea es que, si suficientes creadores construyen aplicaciones útiles, el hardware futuro tendrá contenido que justifique una versión más asequible para consumo. Es el mismo camino que otros fabricantes de dispositivos de realidad aumentada han intentado: primero el kit de desarrollo caro, después el producto de masas. El problema es que ese salto casi nunca llega, o llega tarde y con márgenes que no cierran.

    Para el mercado de realidad aumentada, el precio funciona como filtro. A 2.200 dólares, solo entran equipos con presupuesto de I+D o estudios que ya facturan por proyectos de AR. Eso limita el tamaño de la comunidad de desarrolladores y ralentiza la aparición de la aplicación estrella que dispare la categoría. La competencia en wearables premium tampoco ayuda: hay actores con más músculo en distribución y software. Snap juega con la ventaja de su base creativa y sus filtros, pero eso no se traduce automáticamente en herramientas profesionales de realidad aumentada que alguien quiera pagar a este precio.

    Que lecciones deja para las empresas

    Aquí hay una lección concreta y no obvia para cualquier empresa que evalúe hardware emergente: el precio de las gafas inteligentes Spectacles es una señal de madurez, no de calidad. Cuando un fabricante restringe un dispositivo a desarrolladores y lo tarifica en miles de dólares, está diciendo que la tecnología aún está en fase de experimentación. Para una PYME, eso significa que invertir ahora en construir sobre esa plataforma es apostar por un ecosistema sin garantías de continuidad ni de base de usuarios.

    La recomendación práctica es tratar estos dispositivos como lo que son: un banco de pruebas, no una inversión productiva. Si tu negocio explora la realidad aumentada, tiene más sentido validar el caso de uso con soluciones ya extendidas (AR en móvil, WebAR) antes de comprometer presupuesto en hardware de nicho. Reserva la compra de un kit premium solo si tienes un proyecto concreto, un cliente que lo paga y un plazo corto. Comprar por FOMO tecnológico, esperando que el mercado madure a tu alrededor, es la forma más rápida de amortizar un cajón lleno de gadgets caros.

    Analisis Blixel

    Hay un patrón que se repite en el hardware de realidad aumentada y conviene nombrarlo: se lanza el dispositivo antes de que exista una razón para usarlo. La potencia técnica va por delante de la utilidad, y el discurso comercial rellena el hueco prometiendo que la demanda llegará. En la práctica, quien compra estas gafas suele hacerlo para probar, no para trabajar todos los días con ellas. Ese es el termómetro real de una tecnología: no cuánta gente la compra, sino cuánta la sigue usando al mes siguiente.

    El enfoque en desarrolladores es honesto por parte de Snap, y eso es lo mejor que se puede decir. No están fingiendo que esto es para el gran público. El riesgo es que un kit de 2.200 dólares crea una comunidad demasiado pequeña para generar la masa crítica de aplicaciones que justificaría un producto de consumo. Sin ese contenido, el hardware se queda solo, por muy bueno que sea. Nuestra posición para empresas es sencilla: la realidad aumentada tiene aplicaciones legítimas hoy en formación, mantenimiento industrial o visualización de producto, pero casi siempre se resuelven mejor con soluciones ya desplegadas que con gafas premium experimentales. Antes de comprar hardware que promete el futuro, exige que demuestre valor en el presente. Y si nadie puede enseñarte un caso de uso rentable con él, la respuesta no es comprarlo por si acaso, sino esperar.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • NVRx en Amazon EKS: adios a los fallos de entreno

    NVRx en Amazon EKS: adios a los fallos de entreno

    AWS ha documentado como montar entrenamiento distribuido tolerante a fallos en Amazon EKS combinando NVIDIA Resiliency Extension (NVRx) con PyTorch FSDP. El objetivo es directo: que un fallo de hardware en un cluster de GPUs no tire abajo horas de computo ni obligue a reiniciar el trabajo desde el ultimo checkpoint manual. La guia describe checkpointing asincrono, reinicio en proceso y reactivacion automatica de workers, todo pensado para clusters grandes donde una sola caida de nodo cuesta dinero real. Para equipos que entrenan modelos propios sobre H100, es una pieza que faltaba en el flujo de trabajo sobre Kubernetes.

    Que ha pasado y por que importa

    El entrenamiento distribuido tolerante a fallos en Amazon EKS aborda un problema conocido por cualquiera que haya lanzado trabajos de varios dias sobre decenas de GPUs: cuanto mas grande es el cluster, mas probable es que algo falle. Un nodo que se cuelga, una GPU con error de memoria o un problema de red pueden invalidar el trabajo entero. La propuesta de AWS integra NVRx con PyTorch FSDP para introducir tres mecanismos concretos. El checkpointing asincrono superpone la escritura de estado en disco con el propio entrenamiento, de modo que guardar el progreso deja de ser una pausa. El reinicio en proceso recupera fallos en segundos sin destruir ni recrear los contenedores. Y el reinicio automatico de workers, gestionado por ft_launcher, vuelve a levantar los procesos caidos sin intervencion manual.

    El contexto es relevante porque los benchmarks publicados muestran que el checkpointing sincrono tradicional puede consumir hasta el 40% del tiempo total en clusters grandes. Es decir, casi la mitad del computo pagado se va en salvar estado o en recuperarse de caidas. Reducir ese desperdicio cambia la ecuacion economica de entrenar modelos propios.

    Implicaciones tecnicas de la integracion

    La clave del entrenamiento distribuido tolerante a fallos en Amazon EKS esta en como se reparten las responsabilidades. NVRx aporta la deteccion de fallos y la logica de resiliencia a nivel de proceso, mientras Kubernetes sobre EKS se ocupa de la orquestacion de contenedores. Al usar reinicio en proceso, se evita el ciclo lento de matar un pod, reprogramarlo y reinicializar la comunicacion colectiva entre GPUs. Ese ciclo, en clusters grandes, puede tardar minutos; NVRx lo reduce a segundos porque no toca los contenedores.

    El checkpointing asincrono es la otra mitad del asunto. En lugar de bloquear el paso de entrenamiento mientras se vuelca el estado del modelo y del optimizador a almacenamiento, la escritura ocurre en segundo plano solapada con el computo siguiente. Los benchmarks se centran en GPUs H100 en configuraciones de 2 a 8 nodos, un rango realista para equipos que no operan a escala hyperscaler pero si entrenan o ajustan modelos serios. ft_launcher cierra el circulo automatizando la reactivacion de workers, lo que reduce la carga operativa del equipo de MLOps y minimiza el tiempo en que el cluster queda inactivo tras un incidente.

    Como pueden aplicar esto las empresas hoy

    Si tu equipo ya entrena o hace fine-tuning sobre GPUs en la nube, el primer paso es medir cuanto tiempo pierdes hoy en checkpointing y recuperaciones. Sin ese dato, el ROI del entrenamiento distribuido tolerante a fallos en Amazon EKS es teorico. Si estas cerca de ese 40% de overhead que citan los benchmarks, la migracion se paga sola en horas de GPU ahorradas. Para trabajos cortos en un solo nodo, en cambio, la complejidad anadida no compensa: NVRx brilla en configuraciones multinodo largas.

    Que evitar: no adoptes esto sin un equipo comodo con Kubernetes y PyTorch FSDP, porque anade capas que hay que saber depurar. Tampoco asumas que resuelve fallos logicos de tu codigo; solo cubre resiliencia de infraestructura. Una PYME sin plataforma de entrenamiento propia probablemente hara mejor usando servicios gestionados antes que montar este stack. Pero para quien ya invierte en clusters H100 y sufre caidas recurrentes, es una mejora concreta y medible que reduce coste por experimento y libera al equipo de vigilar trabajos de madrugada.

    Analisis Blixel

    Nadie habla del coste oculto de entrenar a escala hasta que ve la factura: buena parte del gasto en GPUs no produce modelo, produce tiempo muerto salvando estado o levantando nodos caidos. Que AWS y NVIDIA pongan el foco en la resiliencia en lugar de en el enesimo record de rendimiento nos parece la conversacion correcta. El rendimiento bruto de una H100 ya no es el cuello de botella para la mayoria de equipos; el cuello de botella es la fiabilidad operativa cuando juntas muchas de ellas.

    Dicho esto, conviene no confundir una guia tecnica con una solucion llave en mano. Esto exige madurez en Kubernetes, en PyTorch FSDP y en observabilidad. Los equipos que se beneficiaran de verdad son los que ya tienen ese musculo y llevan meses peleando con caidas. Para el resto, el mensaje util es distinto: antes de montar infraestructura propia, mide si realmente entrenas lo suficiente como para justificarla. Muchas empresas espanolas que creen necesitar entrenar desde cero se dan cuenta, al hacer numeros, de que el fine-tuning gestionado o incluso la API pura les sale mas barato y les evita todo este trabajo. La resiliencia importa cuando ya has decidido que el entrenamiento propio es tu ventaja. Si no lo tienes claro, esa decision es la que hay que revisar primero, no la tolerancia a fallos.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Vecinos frenan centros de datos de IA en EE.UU.

    Vecinos frenan centros de datos de IA en EE.UU.

    La resistencia a los centros de datos de IA ha dejado de ser un asunto tecnico para convertirse en un conflicto social. En Filadelfia y otras ciudades estadounidenses, vecinos de comunidades ya golpeadas por refinerias e industria pesada se estan organizando contra la construccion de nuevas instalaciones. Su argumento es directo: mas contaminacion, ruido y consumo de recursos a cambio de muy pocos empleos locales. El telon de fondo es una cifra que asusta: para 2035, los centros de datos de EE.UU. podrian consumir mas gas natural que Alemania y Japon juntos.

    Que ha pasado y por que importa

    Residentes de Filadelfia y de otras ciudades estadounidenses estan plantando cara a la expansion de centros de datos de IA. La oposicion se concentra en zonas que ya arrastran un historial de contaminacion, como areas proximas a refinerias petroliferas, donde la carga ambiental acumulada pesa sobre la salud de la poblacion. Los activistas temen que estas nuevas instalaciones anadan mas contaminacion, ruido y un consumo intensivo de agua y energia sin generar a cambio empleo significativo para la comunidad local.

    El dato que ordena todo el debate lo aporta BloombergNEF: proyecta que en 2035 los centros de datos estadounidenses consumiran mas gas natural que Alemania y Japon combinados. Esa estimacion casi duplica la que la propia firma manejaba hace apenas nueve meses. Es decir, no solo crece la demanda energetica de la IA, sino que las previsiones se estan revisando al alza a una velocidad inesperada. Cuando las proyecciones se doblan en menos de un ano, la infraestructura energetica y las comunidades que la alojan quedan atrapadas en el centro de la ecuacion.

    Implicaciones tecnicas y de mercado

    La resistencia a los centros de datos de IA revela una tension estructural del sector: la potencia de computo necesaria para entrenar y servir modelos crece mas rapido que la capacidad de la red electrica para absorberla de forma limpia. Recurrir al gas natural para cubrir ese hueco tiene sentido operativo a corto plazo (disponibilidad y estabilidad de suministro), pero contradice los compromisos de neutralidad de carbono que muchos operadores han anunciado. La factura no es solo economica, es reputacional y regulatoria.

    Para el mercado, el cuello de botella ya no es tanto la GPU como el acceso a energia y suelo con licencia social para operar. Ubicar instalaciones en comunidades industriales facilita la conexion a infraestructura existente, pero multiplica el riesgo de bloqueo vecinal, litigios y retrasos en permisos. Ese riesgo se traduce en plazos mas largos, costes de capital mas altos y una prima creciente sobre los emplazamientos que combinan energia abundante y baja friccion social. La geografia de la IA, en la practica, la estan empezando a dibujar los mapas energeticos y las juntas municipales, no solo los planes de expansion de los hiperescaladores.

    Que significa este movimiento para el mercado

    Para los operadores de centros de datos y los grandes proveedores cloud, la senal es clara: la licencia social se ha convertido en un factor de coste tan real como el precio del kilovatio. Los proyectos que ignoren a las comunidades de acogida se enfrentaran a retrasos, sobrecostes y cancelaciones. Ganaran ventaja quienes negocien contrapartidas creibles (empleo, inversion local, compromisos de agua y emisiones verificables) antes de mover la primera excavadora. Para las empresas compradoras de capacidad, esto anticipa presion sobre precios y plazos de disponibilidad, sobre todo en regiones con red saturada.

    Los proveedores de energia y las utilities tambien salen tocados: la demanda de gas natural asociada a la IA reordena sus planes de inversion y expone la brecha entre discurso renovable y realidad operativa. Y los reguladores, especialmente a nivel municipal y estatal, ganan poder de veto de facto. Cualquier estrategia de despliegue de IA a gran escala en EE.UU. tendra que incorporar el riesgo de oposicion vecinal como variable central, no como nota al pie.

    Analisis Blixel

    Durante meses el debate energetico de la IA se ha contado como un problema de ingenieria: mas GPUs, mas megavatios, mas refrigeracion. Filadelfia recuerda que detras de cada nave hay un barrio, un aire que se respira y una historia previa de agravios industriales que la gente no ha olvidado. Que las proyecciones de consumo de gas natural se hayan duplicado en nueve meses no es un detalle: es la prueba de que el sector avanza mas rapido de lo que nadie sabe planificar, y que las previsiones que se manejan hoy caducan enseguida.

    La lectura honesta es incomoda. La narrativa de la IA como progreso limpio choca con instalaciones que, en la practica, se estan apoyando en combustibles fosiles y se ubican donde hay menos capacidad de resistencia, no donde hay menos dano. Eso es trasladar el coste ambiental a quien menos puede negarlo. A medio plazo, las empresas que traten la sostenibilidad y la relacion con la comunidad como un tramite de comunicacion pagaran caro esa miopia en forma de litigios y proyectos parados. Las que lo integren de verdad en el diseno del proyecto tendran una ventaja competitiva tangible. La IA necesita computo, si; pero tambien necesita que las ciudades que la alojan quieran alojarla. Ignorar esa condicion no acelera nada: la retrasa.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Los data centers de IA devoran mas gas que Alemania

    Los data centers de IA devoran mas gas que Alemania

    El consumo de gas natural en data centers de Estados Unidos podria superar la demanda combinada de Alemania y Japon para 2035, segun un informe de BloombergNEF. Las instalaciones que sostienen la carrera de la inteligencia artificial quemarian 18.000 millones de pies cubicos diarios, casi el doble de lo previsto hace apenas nueve meses. La cifra reordena las cuentas energeticas del pais y abre un frente incomodo: quien paga la factura y quien asume las emisiones de una expansion que hasta ahora se vendia como limpia y digital.

    Que ha pasado y por que importa

    BloombergNEF ha revisado al alza sus proyecciones sobre el consumo de gas natural en data centers estadounidenses. La estimacion para 2035 asciende a 18.000 millones de pies cubicos diarios, casi el doble de lo calculado nueve meses antes. Ese ritmo de correccion revela hasta que punto la demanda de computo para IA esta desbordando las previsiones. No es un ajuste marginal: es un cambio de escala que situa a las salas de servidores como un consumidor energetico de primer orden dentro del mix nacional.

    El detonante es conocido: entrenar y servir modelos de IA exige GPU funcionando de forma continua, y eso se traduce en un apetito electrico sostenido las veinticuatro horas. Ante la incapacidad de la red para absorber esa demanda con rapidez, las grandes tecnologicas han optado por asegurarse el suministro por su cuenta. Meta, Microsoft, Google y Amazon figuran entre las empresas que planean construir plantas de gas natural propias, un movimiento que pocos anticipaban en compania que hasta hace poco presumian de compromisos de neutralidad de carbono.

    Implicaciones de mercado y ambientales

    El impacto no se queda en los balances corporativos. Un incremento de esta magnitud en el consumo de gas natural en data centers presiona los precios del combustible al alza, y esa presion se traslada a los usuarios de servicios publicos que comparten la misma red de suministro. Dicho de otro modo: hogares y pequenas empresas podrian acabar pagando parte del coste de la expansion de la IA sin haber tomado ninguna decision al respecto. Es una externalidad que hasta ahora ha pasado casi inadvertida en el debate sobre inteligencia artificial.

    La factura ambiental es igual de contundente. El consumo adicional generaria un millon de toneladas metricas de gases de efecto invernadero al dia, equivalente al 12% de las emisiones totales actuales de Estados Unidos. Ese dato choca frontalmente con la narrativa de sostenibilidad de las grandes tecnologicas y complica sus objetivos climaticos. El aumento del consumo de gas natural en data centers convierte la eficiencia energetica de los modelos, antes un tema de nicho, en una variable estrategica y reputacional de primer nivel.

    Que significa este movimiento para el mercado

    Para los competidores del sector cloud, la carrera ya no se gana solo con chips: se gana con acceso a energia. Quien controle generacion propia y contratos de suministro estables tendra ventaja sobre quien dependa de una red saturada. Eso favorece a los hiperescaladores con capital para levantar plantas de gas y penaliza a operadores medianos. Para los proveedores energeticos, el mensaje es una oportunidad de demanda garantizada a largo plazo, pero tambien un riesgo regulatorio si los reguladores deciden que el consumo de gas natural en data centers no puede repercutirse sobre el usuario domestico. Para los buyers de servicios cloud, sobre todo empresas europeas sujetas a reporting de emisiones, aparece un factor nuevo: la huella de carbono del proveedor puede contaminar la suya propia. Conviene exigir transparencia sobre el origen energetico y contemplar clausulas contractuales al respecto. El equilibrio entre coste, disponibilidad y sostenibilidad se convierte en el verdadero campo de batalla de la infraestructura de IA en los proximos anos.

    Analisis Blixel

    Durante anos nos vendieron que lo digital era intrinsecamente limpio, que mover bits no tenia el coste de mover atomos. Este informe rompe esa ilusion sin contemplaciones. La inteligencia artificial es fisica: son turbinas, tuberias y toneladas de CO2 muy reales. Que las mismas empresas que firmaban compromisos de cero neto esten ahora planificando plantas de combustible fosil dice mucho sobre la distancia entre el marketing corporativo y la realidad operativa cuando aprieta la demanda. No es hipocresia sin mas, es una decision racional ante una red electrica que no da abasto, pero conviene llamarla por su nombre. Para las empresas espanolas que evaluan adoptar IA, el titular no debe generar paralisis ni culpa. El grueso de este consumo procede del entrenamiento de modelos gigantes, no del uso cotidiano de una API. Usar un modelo ya entrenado tiene un coste energetico modesto comparado con crearlo. La leccion practica es otra: elegir proveedores que publiquen datos de emisiones, priorizar modelos eficientes frente a los mas grandes por defecto y evitar sobredimensionar. La IA util no siempre es la mas voraz. Y si el regulador acaba imponiendo transparencia energetica, quien ya la practique llegara con ventaja. La sostenibilidad va a dejar de ser un adorno para convertirse en un criterio de compra.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Huang proyecta un 70% mas de ingresos para Nvidia

    Huang proyecta un 70% mas de ingresos para Nvidia

    La proyeccion de crecimiento de Nvidia vuelve a marcar el ritmo del sector: su CEO, Jensen Huang, ha adelantado que la compania espera crecer un 70% el proximo ano. La cifra, poco habitual en una empresa de este tamano, se apoya en la demanda sostenida de chips de inteligencia artificial y en la posicion de Nvidia como proveedor de referencia para centros de datos de IA. Mas alla del titular, conviene entender de donde sale el numero, que lo sostiene y por que un dato asi condiciona a competidores, clientes y a toda la cadena de suministro de semiconductores.

    Que ha dicho Huang y por que importa

    Jensen Huang, CEO de Nvidia, ha situado en un 70% el crecimiento esperado de la compania para el proximo ano. Es una prevision que el propio directivo vincula a un factor concreto: la demanda continua de chips de inteligencia artificial por parte de los grandes operadores de centros de datos. La proyeccion de crecimiento de Nvidia no es un gesto aislado, sino la confirmacion de que el gasto en infraestructura de IA sigue en fase de expansion y no de meseta.

    El contexto ayuda a dimensionar la cifra. Nvidia paso de ser un fabricante conocido por sus tarjetas graficas de videojuegos a convertirse en el proveedor dominante de aceleradores para entrenar y ejecutar modelos de IA. Sus GPU se han vuelto el componente critico de casi cualquier despliegue serio de LLM, y esa posicion le ha dado una ventaja de mercado que pocos fabricantes de hardware han tenido. Que su maximo responsable hable de un 70% mas indica que, desde dentro, no ven senales de que ese ciclo de inversion se este agotando a corto plazo.

    Implicaciones de mercado de la proyeccion

    Una prevision de este calibre tiene lecturas que van mas alla de la cuenta de resultados de Nvidia. Si la proyeccion de crecimiento de Nvidia se cumple, confirma que los grandes compradores de infraestructura de IA siguen dispuestos a destinar presupuestos enormes a GPU, un dato que sirve de termometro para todo el sector. Cuando el proveedor dominante anticipa mas demanda, el resto de la cadena de semiconductores toma nota.

    Para los competidores directos, el mensaje es doble. Por un lado, hay mercado de sobra para crecer; por otro, Nvidia parte con una ventaja de escala y de ecosistema de software que complica arrebatarle cuota. Los fabricantes que intentan ofrecer alternativas de aceleracion para IA se enfrentan a un rival que no solo vende chips, sino toda una plataforma. La proyeccion de crecimiento de Nvidia tambien tensiona a los proveedores: mas demanda de GPU presiona la capacidad de fabricacion, la memoria de alto ancho de banda y el suministro energetico de los centros de datos.

    Que significa este movimiento para el mercado

    Para los compradores de infraestructura de IA, una demanda tan fuerte tiene una consecuencia practica: los plazos de entrega y el poder de negociacion siguen del lado del vendedor. Quien planifique despliegues de IA debe contar con que el hardware de gama alta seguira siendo un recurso disputado y caro, lo que refuerza el atractivo de opciones como el consumo de computo en la nube frente a la compra de equipos propios. Para los competidores, la proyeccion de crecimiento de Nvidia deja claro que el hueco de mercado existe, pero que competir exige algo mas que un chip rapido: hace falta software, herramientas y compatibilidad. Y para los inversores y proveedores de la cadena, una cifra del 70% concentra expectativas muy altas sobre una sola compania, lo que introduce un riesgo evidente si el ritmo de gasto en IA se moderase antes de lo previsto.

    Analisis Blixel

    Cuando una empresa del tamano de Nvidia anticipa crecer a doble digito alto, lo primero que conviene hacer es separar la senal del ruido. La demanda de aceleradores para IA es real y esta documentada por el gasto de los grandes operadores de centros de datos, asi que la prevision no es humo. Pero una cifra del 70% tambien concentra enormes expectativas en un unico actor, y eso es precisamente lo que deberia poner en alerta a cualquier responsable tecnico. Depender de un proveedor con esa posicion de mercado significa aceptar sus precios, sus plazos y sus prioridades de suministro. Para una empresa espanola que evalua adoptar IA, la leccion util no es cuanto crecera el fabricante, sino que el hardware de gama alta seguira siendo escaso y caro. Eso hace que el modelo de pago por uso en la nube tenga mas sentido que comprar equipos propios para la mayoria de casos, salvo necesidades muy especificas de volumen o privacidad. Tambien conviene vigilar a los competidores: cuando un mercado crece tanto, aparecen alternativas, y en dos o tres anos el panorama de proveedores podria ser mas variado. La recomendacion sensata es disenar arquitecturas que no aten el negocio a un unico fabricante y revisar periodicamente si las opciones emergentes ofrecen mejor relacion coste-rendimiento. Un 70% de crecimiento habla del vendedor, no de tu retorno.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • SageMaker ya enruta por prefijos para bajar la latencia

    SageMaker ya enruta por prefijos para bajar la latencia

    El enrutamiento prefix-aware en SageMaker Inference es la nueva jugada de AWS para atacar uno de los costes silenciosos de servir modelos de lenguaje: recalcular una y otra vez los mismos prefijos de contexto. La tecnica dirige cada consulta hacia la instancia que ya tiene en cache el prefijo comun, en lugar de repartir el trafico a ciegas. En cargas conversacionales o de procesamiento de texto con patrones repetitivos, eso se traduce en respuestas mas rapidas sin tocar el modelo ni comprar mas GPU. No es magia: es aprovechar lo que ya estabas pagando.

    Que ha pasado y por que importa

    Amazon Web Services ha incorporado a SageMaker Inference una capa de enrutamiento consciente de los prefijos de las consultas. En lugar de balancear peticiones de forma uniforme entre las instancias de un endpoint, el sistema identifica prefijos comunes (por ejemplo, un system prompt compartido o un contexto recurrente) y envia cada peticion a la instancia que ya tiene ese prefijo cacheado. Asi se evita recalcular tokens que el modelo ya proceso antes.

    El enrutamiento prefix-aware en SageMaker aprovecha caches de prefijos compartidos entre multiples instancias de un mismo modelo. En escenarios de alta concurrencia, donde muchas peticiones comparten el arranque de la conversacion, esto reduce el trabajo redundante de la fase de prefill y baja los tiempos de respuesta. La reutilizacion del KV cache es una tecnica conocida en el mundo de la inferencia de LLM, pero llevarla al enrutamiento de un servicio gestionado la pone al alcance de equipos que no quieren montar su propia infraestructura de serving desde cero.

    Implicaciones tecnicas de la funcionalidad

    La ganancia del enrutamiento prefix-aware en SageMaker depende de cuanto contexto compartan tus peticiones. Aplicaciones con un system prompt largo y estable, agentes con instrucciones fijas o pipelines RAG que reutilizan la misma plantilla son los casos donde el cache de prefijos brilla: la fase de prefill se acorta porque los tokens iniciales ya estan calculados. En cambio, si cada peticion es completamente distinta y sin prefijo comun, el beneficio se diluye.

    Hay un detalle importante de arquitectura: el enrutamiento tradicional prioriza el reparto uniforme de carga, mientras que el prefix-aware prioriza la afinidad de cache. Eso introduce una tension de diseno. Concentrar peticiones con el mismo prefijo en una instancia mejora el hit ratio del cache, pero puede desequilibrar la carga si no se gestiona bien. AWS resuelve ese equilibrio dentro del servicio, lo que evita que tengas que afinar manualmente la logica de balanceo. Para equipos que ya operan endpoints de SageMaker, activar esta capacidad es un cambio de configuracion, no una reescritura de la aplicacion.

    Como pueden aplicar esto las empresas hoy

    Si ya sirves un LLM en SageMaker con trafico conversacional, el primer paso es medir cuanto contexto comparten tus peticiones reales antes de activar nada. Revisa tus logs: si el system prompt o el contexto inicial se repite en la mayoria de llamadas, el enrutamiento prefix-aware en SageMaker tiene sentido y conviene probarlo en un entorno de staging comparando latencia p50 y p99 con y sin la funcionalidad. Para calcular el ROI, traduce la mejora de latencia en dos cosas: experiencia de usuario (respuestas mas rapidas en chat) y capacidad (mas peticiones por instancia, menos GPU para el mismo trafico). Lo que hay que evitar es asumir mejoras sin datos: en cargas con prefijos poco repetitivos apenas notaras diferencia y podrias estar optimizando el problema equivocado. Empieza con un endpoint acotado, mide, y solo entonces generaliza. Si tu volumen es bajo o esporadico, esta optimizacion no es tu prioridad.

    Analisis Blixel

    Buena parte del gasto en inferencia se va en recalcular lo que ya sabes. Cada vez que un modelo reprocesa el mismo system prompt de 800 tokens para cada usuario, estas pagando GPU por trabajo repetido. Que AWS lleve la reutilizacion de caches al propio enrutamiento del servicio gestionado es un movimiento sensato porque democratiza una tecnica que hasta ahora exigia montar tu propio stack de serving con vLLM o similar. La honestidad obliga a matizar: esto no es un truco universal. El enrutamiento prefix-aware en SageMaker rinde en funcion de tu patron de trafico, y hay muchas aplicaciones donde el ahorro sera marginal. El riesgo real es que se venda como una palanca de rendimiento generica cuando en realidad es una optimizacion especifica para cargas con prefijos compartidos. Nuestra recomendacion para una PYME o un equipo de producto es pragmatica: no lo actives por moda, actividalo por datos. Mide primero el porcentaje de contexto compartido, prueba en staging y compara latencia y coste por peticion. Si los numeros salen, es dinero que dejas de tirar cada dia. Si no salen, tu cuello de botella esta en otro sitio y esta funcionalidad solo te dara la falsa sensacion de haber optimizado. La ingenieria util no es la que aplica todas las tecnicas disponibles, sino la que sabe cual mueve la aguja en su caso concreto.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Nscale busca 3.500 millones antes de salir a bolsa

    Nscale busca 3.500 millones antes de salir a bolsa

    La financiacion previa a la IPO de Nscale vuelve a poner el foco en el negocio que sostiene toda la ola de inteligencia artificial: el computo. La empresa britanica, fundada hace apenas dos anos, negocia captar 3.500 millones de dolares antes de su salida a bolsa prevista para este mismo mes. La cifra combina 1.500 millones en notas convertibles y 2.000 millones adicionales aportados por Nvidia. Detras hay contratos firmados por valor de 103.000 millones en ingresos proyectados, con un acuerdo con Anthropic que por si solo alcanza los 45.000 millones. Los numeros son enormes para una compania tan joven.

    Que ha pasado y por que importa

    Nscale es una empresa britanica de infraestructura de IA que opera capacidad de computo para clientes que entrenan y sirven modelos. Segun la informacion disponible, esta en conversaciones para recaudar 3.500 millones de dolares justo antes de su IPO, con dos componentes claros: 1.500 millones en notas convertibles y una inyeccion de 2.000 millones procedente de Nvidia. Esa financiacion serviria para ampliar su capacidad de computo, el cuello de botella real del sector ahora mismo.

    El dato que sostiene la operacion es su cartera de contratos: 103.000 millones de dolares en ingresos proyectados ya firmados, incluyendo un compromiso con Anthropic valorado en 45.000 millones. La financiacion previa a la IPO de Nscale no es un ejercicio especulativo aislado, sino el reflejo de que la demanda de GPU y capacidad supera con mucho a la oferta.

    El contexto ayuda a entenderlo. La escasez de GPU y de centros de datos ha convertido la infraestructura de IA en el activo mas disputado del sector. Empresas que hace dos anos no existian negocian ahora cifras que antes se reservaban a gigantes consolidados. Que Nvidia participe directamente como inversor, y no solo como proveedor de chips, marca una tendencia: el fabricante quiere asegurar destino para su silicio y clientes con capacidad de pago garantizada.

    Implicaciones tecnicas y de mercado

    La estructura de la ronda dice mucho. Las notas convertibles permiten captar capital rapido sin fijar valoracion hasta la IPO, algo habitual cuando una empresa crece a un ritmo que hace dificil ponerle precio. La aportacion de 2.000 millones de Nvidia refuerza un patron que se repite en la financiacion previa a la IPO de Nscale y en operaciones similares: el proveedor de hardware invierte en sus propios compradores, cerrando un circulo donde el capital y la demanda se retroalimentan.

    Para el mercado, la senal es doble. Por un lado confirma que la infraestructura de IA sigue siendo el negocio con mayor traccion inversora, incluso por encima de muchas empresas de modelos. Por otro, expone un riesgo de concentracion: cuando un proveedor financia a sus clientes, la salud del sector depende de que esos contratos proyectados se conviertan en ingresos reales.

    La cifra de 103.000 millones en contratos firmados es la palanca de credibilidad de cara a la IPO, pero tambien la mayor incognita. Contratos plurianuales dependen de que la demanda de computo se mantenga y de que Nscale despliegue capacidad a tiempo. En un mercado donde la entrega de GPU y la construccion de centros de datos marcan los plazos, ejecutar es tan importante como firmar.

    Que significa este movimiento para el mercado

    Para los competidores directos, hyperscalers y neoclouds especializados, la operacion sube el liston de capital necesario para competir. Quien no tenga acceso a rondas de miles de millones ni a acuerdos preferentes con Nvidia partira en desventaja para captar los grandes contratos de entrenamiento. Para los proveedores de chips, la jugada de Nvidia sienta precedente: invertir en clientes se consolida como via para asegurar demanda y fidelizar capacidad.

    Para los buyers, es decir, las empresas que desarrollan modelos, el mensaje es mixto. Contratos como el de Anthropic garantizan capacidad reservada, pero refuerzan la dependencia de un puñado de proveedores de infraestructura de IA con financiacion cruzada. Para inversores en la IPO, la cartera de 103.000 millones es atractiva a la vez que el reto sera valorar el riesgo de ejecucion y la exposicion a un solo gran cliente. En resumen: la financiacion previa a la IPO de Nscale confirma que el poder del sector se esta concentrando en quien controla el computo, y que el capital fluye hacia esa capa antes que hacia ninguna otra.

    Analisis Blixel

    Cuando el fabricante de chips invierte en las empresas que compran esos chips, conviene mirar la letra pequena. La operacion tiene logica industrial impecable: Nvidia asegura salida para su hardware y clientes solventes, mientras la compania britanica obtiene capital y validacion de peso antes de cotizar. Pero es tambien un sistema donde la demanda se financia a si misma, y eso merece prudencia. Los 103.000 millones en contratos firmados son impresionantes sobre el papel; el matiz es que son proyecciones plurianuales sujetas a que la capacidad se despliegue y a que los clientes mantengan su ritmo de gasto. La dependencia de un acuerdo de 45.000 millones con un unico cliente concentra buena parte del riesgo en una sola relacion comercial. Nada de esto invalida la tesis, solo la matiza. Para el sector, la lectura util es que la capa de infraestructura sigue siendo donde se acumula el valor y el poder de negociacion, por encima incluso de muchas empresas de modelos. Para cualquier empresa que dependa de proveedores de computo, la conclusion practica es vigilar la concentracion: cuando pocos actores controlan la capacidad y ademas comparten inversores, la capacidad de negociar precios y condiciones se reduce. La IPO dira si el mercado compra la narrativa. Nosotros la miramos con interes y con la calculadora encendida, que es como conviene mirar toda cifra con nueve ceros.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Crusoe capta 3.000 millones y vale ya 30.000

    Crusoe capta 3.000 millones y vale ya 30.000

    La nueva ronda de financiacion de Crusoe deja una cifra dificil de ignorar: 3.000 millones de dolares captados y una valoracion que alcanza los 30.000 millones. La empresa, dedicada al desarrollo de centros de datos y con Meta, Microsoft y OpenAI entre sus clientes, se consolida como uno de los proveedores de infraestructura de IA mas codiciados del momento. El dato llega acompanado de un contrato reciente de 13.000 millones a cinco anos para suministrar GPU a la firma de trading cuantitativo Jane Street. La foto es clara: el dinero sigue yendo a quien construye la base fisica de la IA.

    Que ha pasado y por que importa

    Crusoe ha cerrado una ronda de financiacion de 3.000 millones de dolares con una valoracion de 30.000 millones. La compania desarrolla y opera centros de datos orientados a cargas de inteligencia artificial, y ya trabaja con tres de los nombres mas grandes del sector: Meta, Microsoft y OpenAI. A esa cartera se suma un acuerdo firmado recientemente con Jane Street, una firma de trading cuantitativo, por 13.000 millones de dolares a lo largo de cinco anos para suministrar GPU e infraestructura de IA. La operacion refuerza la posicion de Crusoe en un mercado donde la demanda de capacidad de computo supera con holgura a la oferta disponible.

    El contexto ayuda a entender la magnitud. El auge de los modelos de lenguaje y de las aplicaciones de IA ha disparado la necesidad de infraestructura de IA escalable, y las empresas que la proveen se han convertido en piezas estrategicas. Que un cliente ajeno a las grandes tecnologicas, como una firma de trading, comprometa 13.000 millones para asegurar GPU indica que la carrera por el computo ya no se limita a los laboratorios de modelos. Cualquier organizacion con cargas intensivas de calculo entra en la puja.

    Implicaciones tecnicas y de mercado

    El dato relevante de esta ronda de financiacion no es solo la cantidad, sino a que responde. La infraestructura de IA se ha convertido en un cuello de botella real: entrenar y servir modelos exige GPU, energia y espacio en centros de datos, y esos tres recursos escasean. Crusoe se coloca como intermediario entre quien tiene chips y energia disponible y quien necesita ejecutar cargas de trabajo pesadas. La valoracion de 30.000 millones refleja la apuesta de los inversores por que esa escasez se mantendra durante anos.

    El contrato con Jane Street aporta una senal de mercado interesante. Hasta ahora, buena parte de la demanda de infraestructura de IA venia de proveedores de modelos y grandes nubes. Ver a una firma cuantitativa comprometer capital a cinco anos sugiere que sectores como finanzas, con necesidades de calculo masivo y baja latencia, estan asegurandose capacidad por adelantado ante el temor a quedarse sin GPU. Para el ecosistema de infraestructura de IA, esto significa contratos mas largos, mayor previsibilidad de ingresos y una competencia creciente por acceder a hardware y energia. Tambien tensiona los precios: quien no reserva capacidad hoy corre el riesgo de pagarla mas cara manana.

    Que significa este movimiento para el mercado

    Para los competidores directos, esta ronda de financiacion eleva el liston. Crusoe llega con 3.000 millones frescos para ampliar centros de datos y comprar GPU justo cuando esos recursos definen quien gana contratos. Otros proveedores de infraestructura de IA tendran que acelerar sus propias captaciones o buscar nichos donde diferenciarse, ya sea por eficiencia energetica, ubicacion o modelos de precio. Para los grandes hyperscalers, la aparicion de players especializados como Crusoe representa tanto un proveedor complementario como un posible rival por el mismo hardware.

    Para los compradores de computo, el mensaje es incomodo pero util: la capacidad se esta reservando a plazos largos y quien planifica con antelacion asegura mejores condiciones. El acuerdo de Jane Street marca el camino. Fabricantes de chips y operadores energeticos, por su parte, ganan un cliente con mucho capital y contratos plurianuales. En conjunto, el movimiento confirma que el valor en la cadena de la IA se esta desplazando hacia quien controla la infraestructura fisica, no solo hacia quien entrena los modelos.

    Analisis Blixel

    Cuando el dinero deja de perseguir a los que hacen modelos y empieza a perseguir a los que ponen los cables, conviene prestar atencion. Estamos en la fase en la que el margen ya no esta tanto en el algoritmo como en el metal: GPU, megavatios y metros cuadrados de centro de datos. Crusoe encarna ese giro. Su valoracion no se explica por una tecnologia disruptiva propia, sino por su posicion en un cuello de botella que nadie sabe cuando se aliviara. Y ahi esta el riesgo: valoraciones de 30.000 millones asumen que la escasez de computo dura anos. Si la eficiencia de los modelos mejora, si aparece hardware mas barato o si la demanda se enfria, esa apuesta se resiente. Para una PYME espanola esto rara vez es una oportunidad directa, pero si una lectura estrategica. El coste del computo no va a bajar de forma inmediata, y depender de un unico proveedor para cargas criticas de IA es un riesgo de negocio, no solo tecnico. Antes de comprometerse con contratos largos de infraestructura, conviene medir el consumo real, cuestionar si se necesita entrenar o basta con inferencia, y negociar flexibilidad. El sector premia hoy a quien reserva capacidad, pero premiara manana a quien no sobredimensiono. La prudencia sigue siendo la mejor arquitectura.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Nvidia invierte en energia para asegurar su negocio

    Nvidia invierte en energia para asegurar su negocio

    La inversion de Nvidia en centros de datos da un giro relevante con su alianza con Cloverleaf Infrastructure, una empresa fundada en 2024 que hace de intermediario entre compañias electricas y operadores de centros de datos. Nvidia inyectara varios cientos de millones de dolares, segun el Wall Street Journal, a cambio de una participacion minoritaria. El movimiento no es filantropico: encaja en una estrategia clara de financiar la infraestructura que despues comprara sus propios sistemas de IA. Es un circulo que mantiene la demanda de sus chips y, de paso, ataca el cuello de botella real del sector: la energia.

    Que ha pasado y por que importa

    Nvidia ha anunciado una alianza con Cloverleaf Infrastructure, una compañia joven cuyo negocio consiste en actuar como puente entre las utilities electricas y los promotores de centros de datos. En la practica, Cloverleaf gestiona el acceso a suministro energetico y la infraestructura necesaria para levantar instalaciones intensivas en computo. Segun el Wall Street Journal, la inversion de Nvidia alcanzara varios cientos de millones de dolares y le dara una participacion minoritaria en la empresa.

    La operacion importa porque revela donde esta hoy el verdadero limite del crecimiento de la IA. No es la escasez de GPUs en abstracto, sino la capacidad de conectar esos equipos a la red electrica. La inversion de Nvidia en centros de datos a traves de un especialista energetico apunta directamente a ese problema. Al financiar la infraestructura previa, Nvidia se asegura de que los proyectos que consumen su hardware puedan siquiera encenderse.

    El contexto es una carrera global por capacidad de computo en la que los plazos de conexion electrica se han vuelto el factor critico. Las utilities tardan anos en ampliar subestaciones y lineas de transporte, mientras la demanda de entrenamiento e inferencia crece cada trimestre. Cloverleaf nacio precisamente para desatascar esos cuellos de botella, y Nvidia ha decidido comprar una silla en esa mesa.

    Implicaciones de mercado

    Esta operacion consolida un patron que Nvidia lleva meses tejiendo: invertir en las empresas que despues seran clientas de sus sistemas de IA. La logica es sencilla y a la vez arriesgada. Cada dolar destinado a financiar infraestructura energetica ayuda a que se construyan mas centros de datos, y cada centro de datos nuevo es un comprador potencial de aceleradores Nvidia. La compañia se convierte asi en proveedor e inversor al mismo tiempo, reforzando su propia demanda desde varios frentes.

    El movimiento tambien confirma que la inversion de Nvidia en centros de datos ya no se limita al silicio. Al entrar en la capa energetica, la firma se posiciona en la parte de la cadena de valor que hoy determina que proyectos salen adelante y cuales quedan en el papel. Quien controla el acceso a la energia controla el ritmo de despliegue.

    Para los competidores en hardware, la senal es incomoda: Nvidia no solo domina el mercado de chips, sino que empieza a asegurar los canales que garantizan su venta. Para las utilities, aparece un nuevo actor dispuesto a poner capital para acelerar conexiones. Y para los operadores de centros de datos, tener a Nvidia como inversor puede significar acceso preferente tanto a energia como a suministro de GPUs.

    Que significa este movimiento para el mercado

    Para los rivales de Nvidia en aceleradores, la inversion en Cloverleaf eleva el coste de competir: ya no basta con fabricar un chip competitivo, hay que disputar tambien el acceso a infraestructura y energia que Nvidia esta ayudando a financiar. Los proveedores de energia y las utilities ganan un socio con bolsillos profundos interesado en acelerar conexiones, lo que puede reordenar prioridades en la cola de proyectos. Para los operadores y buyers de capacidad de computo, la lectura es doble: quienes se alineen con el ecosistema Nvidia pueden obtener ventajas de suministro, pero tambien crece la dependencia de un unico actor que ahora esta presente en varias capas de la cadena. Conviene vigilar el riesgo de concentracion: cuando el mayor vendedor de chips financia a sus futuros clientes, las senales de demanda del mercado se vuelven menos fiables como termometro independiente. Las empresas que planifican inversiones en IA deberian evaluar la solidez real de la demanda final, mas alla de los acuerdos cruzados, antes de comprometer presupuestos a largo plazo en capacidad de computo.

    Analisis Blixel

    Financiar a tus propios clientes es una jugada tan vieja como el capitalismo industrial, pero rara vez se habia visto con esta intensidad en tecnologia. Nvidia esta usando parte de su enorme caja para engrasar la maquina que consume sus productos, y el argumento a favor es solido: si el limite real es la energia y los plazos de conexion, adelantar capital para desatascarlos acelera ventas que de otro modo llegarian anos despues. El problema aparece cuando ese mismo mecanismo distorsiona la lectura del mercado. Si el crecimiento de la demanda se sostiene en parte porque el propio proveedor lo esta financiando, cuesta distinguir cuanta demanda es organica y cuanta es inducida. No decimos que haya nada ilegitimo aqui, pero si que los numeros de crecimiento del sector merecen leerse con lupa. Para una PYME o un directivo que evalua invertir en IA, la conclusion practica es de sentido comun: no confundir el ruido de estos movimientos multimillonarios con una senal de que hay que correr. La capacidad de computo seguira creciendo con o sin tu prisa. Lo inteligente es dimensionar tu proyecto por el valor concreto que genera, no por la fiebre inversora de los gigantes. Cuando los actores mas grandes empiezan a financiar la demanda de sus propios chips, es buen momento para preguntarse quien esta comprando por necesidad y quien por inercia.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Starcloud capta 250 millones para IA en orbita

    Starcloud capta 250 millones para IA en orbita

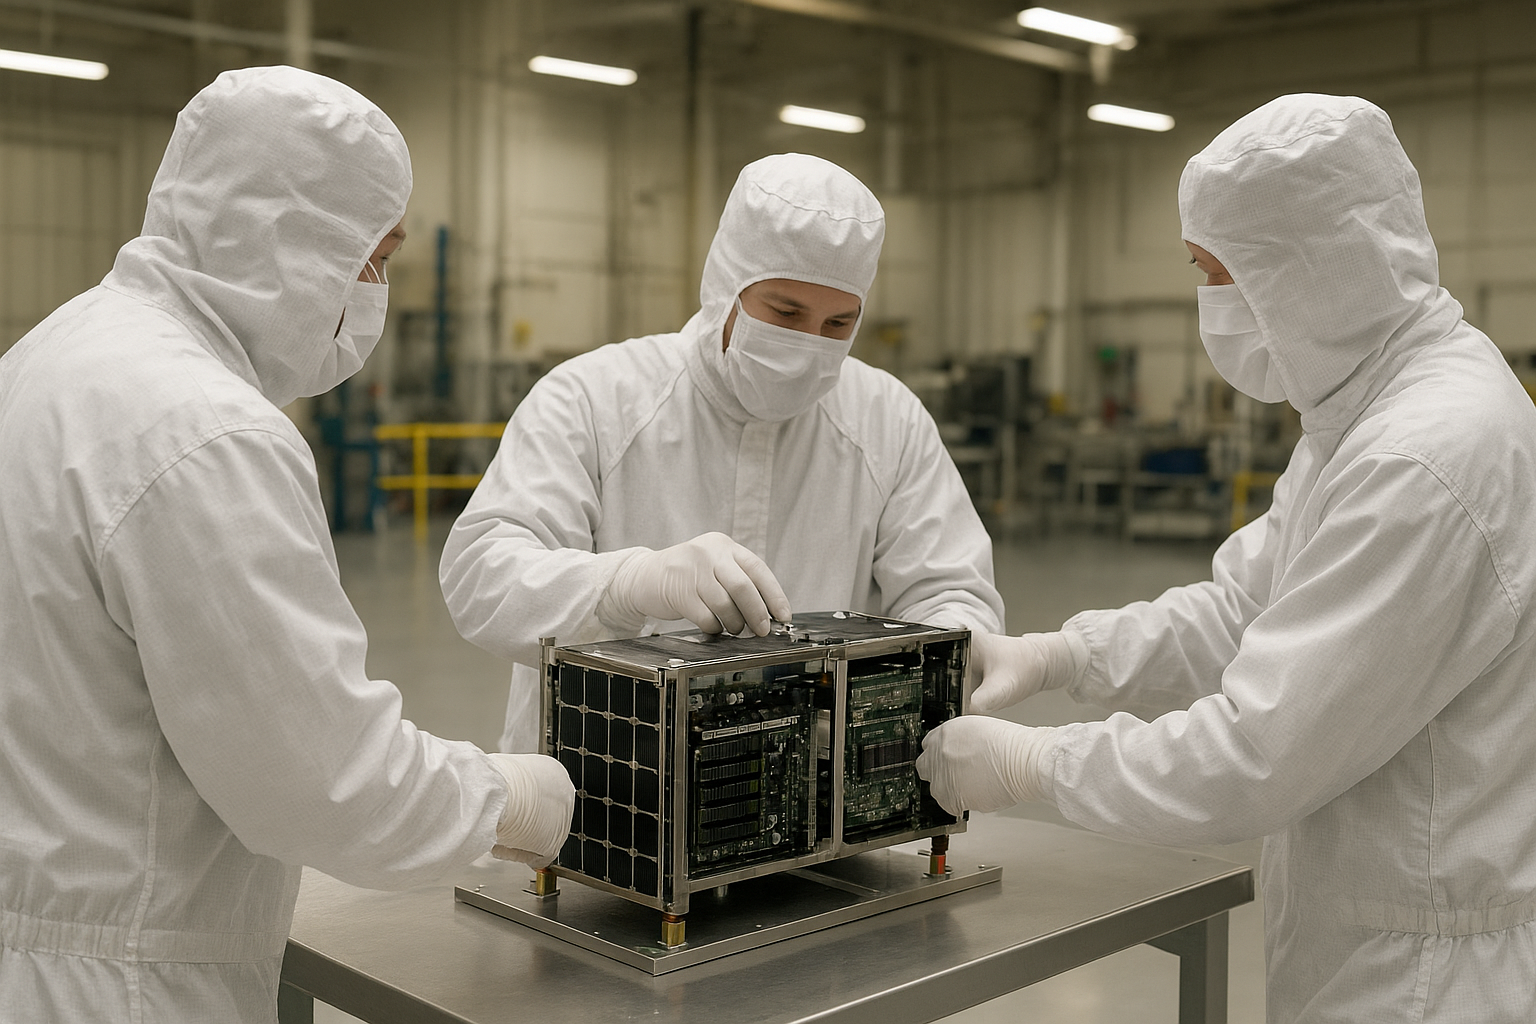
    Los centros de datos orbitales de Starcloud acaban de recibir un espaldarazo de 250 millones de dolares que eleva la valoracion de la compania a 2.300 millones. La empresa quiere poner satelites capaces de ejecutar inferencia de IA directamente en el espacio, y ya opera el unico GPU Nvidia H100 en orbita. Pero el dinero es solo la mitad de la ecuacion: el verdadero cuello de botella no es la financiacion, sino conseguir cohetes que suban ese hardware. Y ahi el mercado se esta cerrando justo cuando Starcloud mas lo necesita.

    Que ha pasado y por que importa

    Starcloud ha ampliado su ronda Serie A con 250 millones de dolares adicionales, alcanzando una valoracion de 2.300 millones. El objetivo declarado es desarrollar una constelacion de satelites que realicen inferencia de IA en orbita, aprovechando la energia solar constante y la refrigeracion pasiva del espacio como argumentos frente a la creciente demanda energetica de los centros de datos terrestres.

    La compania opera actualmente el unico GPU Nvidia H100 en orbita, un hito simbolico mas que operativo, pero que sirve como prueba de concepto para inversores. Ademas, ha solicitado a la FCC permisos para nada menos que 88.000 naves espaciales, una cifra que da la medida de sus ambiciones a largo plazo. El problema aparece en el otro lado de la cadena: la capacidad de lanzamiento. Con el fin programado del programa Falcon 9 de SpaceX previsto para 2028 y la transicion hacia Starship, el acceso al espacio se vuelve mas incierto justo en el momento en que los proyectos de centros de datos orbitales empiezan a necesitar volumen real de despliegue.

    Implicaciones tecnicas y de mercado

    La tesis de los centros de datos orbitales no es nueva, pero la financiacion masiva le da credibilidad. El razonamiento es claro: la IA consume cantidades ingentes de energia y agua para refrigeracion, y en orbita hay sol permanente y frio de sobra. Trasladar la inferencia al espacio evitaria la presion sobre las redes electricas terrestres. Sin embargo, la ejecucion de esta idea depende por completo de un recurso escaso y caro: los cohetes.

    Aqui esta la contradiccion que define esta ronda. Starcloud tiene capital para construir hardware espacial, pero necesita asegurar capacidad de lanzamiento en un mercado que se estrecha. El retiro de Falcon 9 y la transicion a Starship crean una ventana de incertidumbre. Si Starship se retrasa o su cadencia inicial es baja, los planes de despliegue masivo de centros de datos orbitales quedan expuestos. Solicitar permisos para 88.000 naves no significa nada si no hay forma economica y fiable de ponerlas alli arriba. La financiacion valida la vision, pero el mercado de lanzamiento decidira si es viable.

    Que significa este movimiento para el mercado

    Para los proveedores de lanzamiento, la existencia de compradores dispuestos a desplegar decenas de miles de satelites de computo es una oportunidad enorme, pero tambien un test de capacidad. SpaceX, Rocket Lab, Blue Origin y cualquier operador con cadencia real ganan poder de negociacion en un escenario de demanda creciente y oferta ajustada. La escasez de lanzamiento convierte el acceso al espacio en el activo verdaderamente estrategico, por encima incluso del hardware.

    Para los operadores de centros de datos terrestres, este movimiento no supone una amenaza inmediata. La inferencia orbital tiene latencia, coste de despliegue y mantenimiento en condiciones que ningun rack en tierra necesita afrontar. Pero senala que la presion energetica del computo de IA es lo bastante seria como para justificar apuestas radicales de 2.300 millones de valoracion. Para inversores y competidores, la lectura es doble: hay apetito por soluciones alternativas al problema energetico de la IA, y quien controle la logistica de lanzamiento tendra la sarten por el mango en la proxima decada de infraestructura espacial.

    Analisis Blixel

    Construir el satelite es la parte facil cuando tienes 250 millones en el banco. Lo dificil, y lo que esta ronda no resuelve del todo, es subirlo. Toda la propuesta descansa sobre un supuesto fragil: que habra cohetes suficientes, baratos y fiables cuando llegue el momento de desplegar a escala. El retiro de Falcon 9 y la incognita de Starship convierten ese supuesto en el mayor riesgo del proyecto, y ningun capital lo compensa por si solo.

    Nos parece una apuesta honesta a un problema real. La factura energetica de la IA es insostenible en su trayectoria actual y explorar el espacio como entorno de computo no es ciencia ficcion barata: la energia solar constante y la refrigeracion pasiva son ventajas fisicas genuinas. Dicho esto, pedir permisos para 88.000 naves cuando operas un unico GPU en orbita es marketing tanto como estrategia. La distancia entre uno y 88.000 es abismal y esta pavimentada de lanzamientos que hoy no estan garantizados. Para cualquier empresa que siga este sector, la leccion es no confundir valoracion con viabilidad operativa. El dinero valida la vision, pero la logistica valida el negocio. Seguiremos de cerca si Starcloud firma acuerdos de lanzamiento concretos, porque ahi, y no en la siguiente ronda, se juega su futuro real.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • El agua reciclada ya enfria muchos centros de datos

    El agua reciclada ya enfria muchos centros de datos

    El agua reciclada para refrigeracion de centros de datos no es una ocurrencia de marketing: es una practica que ya funciona en instalaciones reales. La chispa saltó con una campaña publicitaria de Liquid Death, protagonizada por Jason Kelce, que proponía medio en broma enfriar servidores con orina. Detrás del gag hay un hecho verificable: muchos operadores usan aguas residuales tratadas, que incluyen orina depurada, para disipar el calor de sus racks. La idea reduce la presion sobre el agua potable, pero no es aplicable en cualquier sitio. Aquí separamos el ruido publicitario del dato tecnico.

    Que ha pasado y por que importa

    La campaña de Liquid Death con Jason Kelce lanzó una premisa provocadora: aprovechar la orina para enfriar centros de datos. Aunque el tono es publicitario, los expertos consultados confirman que el fondo tiene base real. El uso de agua reciclada para refrigeracion de centros de datos ya está implantado, y ese agua reciclada procede de plantas de tratamiento de aguas residuales que, efectivamente, incluyen orina depurada dentro del flujo urbano que procesan.

    El caso mas citado es el condado de Loudoun, en Virginia, uno de los mayores hubs de centros de datos del mundo. Allí las instalaciones consumen 200 millones de galones diarios de agua reciclada. Es una cifra enorme, pero conviene ponerla en contexto: ese volumen representa solo el 43% del consumo total de agua de esos centros. El resto sigue dependiendo de otras fuentes. El dato desmonta dos extremos: ni el agua reciclada es marginal ni resuelve por sí sola la huella hidrica del sector.

    La refrigeracion es uno de los mayores costes ambientales de la computacion masiva. Cada servidor genera calor que hay que evacuar, y el agua sigue siendo uno de los metodos mas eficientes para hacerlo. Con la demanda disparada por las cargas de IA, cualquier via que reduzca el uso de agua potable gana relevancia inmediata.

    Implicaciones tecnicas y limites reales

    El atractivo del agua reciclada para refrigeracion de centros de datos es directo: en lugar de competir con el suministro de agua potable de la poblacion, el operador usa un recurso que de otro modo se descargaría tratado. En zonas con estrés hidrico, esa diferencia es politica y operativamente decisiva a la hora de conseguir permisos de construccion.

    Pero hay un cuello de botella que la publicidad omite: la infraestructura. Para usar agua reciclada hace falta una planta de tratamiento de aguas residuales cercana y una red de conduccion dedicada hasta el centro de datos. Eso existe en areas urbanas y periurbanas densas como Loudoun, pero no en muchas zonas rurales, que son precisamente donde el suelo barato y la energia disponible empujan a construir nuevos campus. Sin planta cercana, transportar agua reciclada deja de tener sentido economico y ambiental.

    El caso de Loudoun tambien matiza las expectativas. Que el agua reciclada cubra el 43% del consumo no es un fracaso, pero recuerda que el resto sigue procediendo de fuentes convencionales. El agua reciclada es una palanca de mitigacion, no una solucion total. La refrigeracion de centros de datos seguira necesitando una combinacion de fuentes, y el peso de cada una dependerá de la geografia y de la infraestructura local disponible.

    Cuando y para quien sera relevante esto

    El uso de agua reciclada para refrigeracion de centros de datos ya es relevante hoy, pero solo para un perfil concreto de proyecto: grandes campus situados cerca de nucleos urbanos con plantas de tratamiento operativas y capacidad de suministro. Para esos operadores, negociar acceso a agua reciclada es una via para reducir la fricción con administraciones y comunidades locales preocupadas por el consumo de agua potable.

    Para el resto del sector, el horizonte es mas lento. Los centros de datos en zonas rurales o aisladas dependerán de que se construya infraestructura de tratamiento y conduccion, algo que exige inversion publica o acuerdos privados a varios años vista. En esos casos, otras estrategias como la refrigeracion por aire, los sistemas de circuito cerrado o la refrigeracion liquida directa al chip competiran con el agua reciclada. No es una tecnologia experimental: es una practica madura cuyo despliegue está limitado por la geografia y la infraestructura, no por la viabilidad tecnica. Quien planifique un centro de datos en los proximos años deberia evaluar la disponibilidad de agua reciclada desde la fase de eleccion del emplazamiento, no como parche posterior.

    Analisis Blixel

    Que haga falta una campaña sobre orina para que se hable de la huella hidrica de la computacion dice bastante sobre lo poco que se discute este tema fuera de los circulos tecnicos. La broma de Liquid Death funciona porque exagera algo que ya es cierto, y eso es justo lo interesante: la parte real es mucho menos llamativa que el titular, pero mucho mas importante. El dato de Loudoun es el que hay que retener. El 43% no es un logro que celebrar sin matices ni un fracaso que denunciar: es un recordatorio de que la sostenibilidad de la infraestructura digital se juega en porcentajes parciales, en acuerdos locales y en tuberias, no en anuncios ni en promesas redondas. El sector tiende a comunicar sus avances ambientales en absolutos, y eso genera desconfianza justificada. Lo honesto es reconocer que reutilizar aguas residuales reduce presion sobre el agua potable, que es una buena noticia, y a la vez que esa via depende de una infraestructura que no existe en todas partes. Para quien decide donde construir, la leccion practica es clara: el emplazamiento condiciona la huella hidrica tanto como la tecnologia de refrigeracion elegida. Ignorar eso en la fase de diseño significa heredar un problema caro e imposible de corregir despues. La conversacion util no es si usar orina tratada, sino como planificar centros de datos que no compitan con las personas por el agua.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.