Categoría: Hardware y Cómputo

  • Samsung y Qualcomm logran el primer 5G FWA en vRAN

    Samsung y Qualcomm logran el primer 5G FWA en vRAN

    Samsung Electronics y Qualcomm Technologies han conseguido validar la capacidad 5G FWA vRAN Power Class 1 en una configuración completamente virtualizada, marcando un hito técnico que combina transmisión de alta potencia con arquitectura RAN definida por software. Esta implementación representa el primer caso documentado de integración exitosa entre dispositivos de mayor potencia de transmisión y una red de acceso radio completamente virtualizada.

    Qué significa este avance técnico y por qué importa ahora

    La validación combina dos tecnologías críticas para el despliegue 5G: Fixed Wireless Access (FWA) con Power Class 1 y virtualized Radio Access Network (vRAN). Power Class 1 permite a los dispositivos transmitir con hasta 23 dBm de potencia, significativamente superior a los dispositivos móviles estándar que operan en Power Class 3 (23 dBm máximo en condiciones específicas). Esta mayor potencia de transmisión extiende el alcance de cobertura y mejora la calidad de señal en implementaciones FWA.

    El timing de este anuncio coincide con la presión creciente de operadores para reducir costes operativos mientras expanden cobertura 5G. vRAN permite separar hardware y software de la red de acceso radio, ejecutando funciones de red en servidores comerciales estándar en lugar de equipos propietarios. Esta arquitectura promete reducir dependencia de proveedores únicos y acelerar innovación mediante actualizaciones de software.

    Implicaciones técnicas para el despliegue 5G empresarial

    La integración exitosa de 5G FWA vRAN con Power Class 1 resuelve un problema técnico específico: tradicionalmente, las implementaciones vRAN han mostrado limitaciones de rendimiento comparadas con RAN tradicionales, especialmente en escenarios de alta demanda. La validación de Power Class 1 en este entorno sugiere que vRAN puede manejar dispositivos de mayor potencia sin degradación significativa de performance.

    Para operadores, esto significa poder ofrecer conectividad FWA empresarial con el alcance extendido de Power Class 1 mientras mantienen la flexibilidad operativa de vRAN. Los dispositivos Power Class 1 pueden cubrir distancias mayores desde torres celulares, reduciendo necesidad de densificación de red en áreas suburbanas o rurales donde las empresas buscan alternativas a fibra óptica.

    Cómo pueden aplicar esto las empresas hoy

    Las empresas evaluando conectividad 5G FWA deben considerar que esta validación técnica no se traduce inmediatamente en disponibilidad comercial. Sin embargo, pueden prepararse evaluando sus necesidades de ancho de banda y latencia actuales versus las capacidades prometidas por 5G FWA. Empresas en ubicaciones donde fibra es costosa o no disponible deberían monitorear despliegues piloto de operadores locales que implementen estas tecnologías combinadas. El ROI potencial incluye reducción de costes de conectividad fija y mayor flexibilidad para expansión geográfica sin infraestructura cableada.

    Análisis Blixel

    Este anuncio técnico refleja la maduración gradual del ecosistema vRAN, que ha enfrentado escepticismo justificado sobre su viabilidad en implementaciones exigentes. La validación de Power Class 1 en vRAN por dos gigantes como Samsung y Qualcomm envía una señal clara al mercado: vRAN está listo para casos de uso empresariales serios, no solo para despliegues experimentales. Sin embargo, la realidad es que estamos viendo el primer paso de un proceso largo. La validación técnica en laboratorio dista mucho de despliegues comerciales a escala, y los operadores seguirán siendo cautelosos hasta ver métricas de rendimiento en condiciones reales. Para las empresas españolas, esto significa que 5G FWA empresarial sigue siendo una promesa a medio plazo, pero una promesa cada vez más creíble.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • Optus logra agregacion 5G standalone de 180MHz

    Optus logra agregacion 5G standalone de 180MHz

    Optus y Ericsson han completado lo que califican como la primera agregacion espectro 5G standalone de 180MHz en una red comercial activa, combinando las bandas de 2.3GHz y 3.5GHz. Esta prueba marca un hito técnico en la evolución de las redes móviles, demostrando capacidades avanzadas de gestión de espectro que prometen multiplicar el rendimiento de las conexiones 5G.

    Que significa esta agregacion de espectro y por que es relevante

    La agregacion espectro 5G standalone permite a los operadores combinar múltiples bandas de frecuencia simultáneamente, creando canales de comunicación más anchos y eficientes. En este caso, Optus ha logrado agregar 180MHz totales distribuyendo el espectro entre las bandas de 2.3GHz (100MHz) y 3.5GHz (80MHz), una configuración que teóricamente puede duplicar o triplicar las velocidades de descarga respecto a implementaciones 5G convencionales.

    Lo crucial de este logro es que se ha realizado en modo standalone, es decir, sin depender de infraestructura 4G como ancla. Esto significa que la red 5G opera de forma completamente independiente, aprovechando al máximo las capacidades nativas del estándar, incluyendo latencias ultra-bajas y arquitectura de red más flexible. Hasta ahora, la mayoría de despliegues 5G comerciales funcionan en modo non-standalone, limitando su potencial real.

    Implicaciones tecnicas para la industria de telecomunicaciones

    Esta demostración técnica de Optus y Ericsson establece un precedente para otros operadores mundiales que buscan maximizar la eficiencia espectral de sus inversiones 5G. La capacidad de agregar espectro de forma dinámica y eficiente se convierte en una ventaja competitiva crítica, especialmente en mercados donde el espectro radioeléctrico es limitado y costoso.

    Desde el punto de vista de la infraestructura, esta agregación requiere equipos de red capaces de coordinar múltiples bandas simultáneamente y terminales móviles compatibles con estas configuraciones avanzadas. Ericsson ha demostrado que su hardware actual puede soportar estas demandas, lo que posiciona a la empresa sueca favorablemente frente a competidores como Huawei, Nokia o Samsung en el mercado de equipos 5G enterprise.

    Como pueden aplicar esto las empresas hoy

    Para empresas que evalúan conectividad 5G, esta evolución técnica representa oportunidades concretas a medio plazo. Sectores como logística, manufactura avanzada o servicios financieros que requieren conectividad ultra-fiable pueden beneficiarse de estas mejoras de capacidad y latencia. Sin embargo, la adopción práctica dependerá de que los operadores locales implementen configuraciones similares y de que los dispositivos empresariales soporten estas funcionalidades avanzadas.

    Las PYMEs tecnológicas que desarrollan aplicaciones IoT, realidad aumentada o sistemas de monitorización en tiempo real deberían considerar estos avances al planificar sus roadmaps de producto. La mayor capacidad de red puede habilitar casos de uso que hoy son inviables por limitaciones de ancho de banda o latencia, especialmente en entornos industriales donde múltiples dispositivos compiten por conectividad.

    Analisis Blixel

    La industria de telecomunicaciones vive un momento paradójico: mientras los operadores invierten miles de millones en 5G, la mayoría de usuarios apenas perciben diferencias respecto a 4G avanzado. Esta demostración de Optus sugiere que el problema no está en el estándar 5G, sino en implementaciones conservadoras que no explotan su potencial real. La agregacion espectro 5G standalone representa el tipo de innovación técnica que puede justificar finalmente las inversiones masivas en nueva infraestructura. Sin embargo, queda la incógnita de si los operadores europeos y españoles tendrán la ambición técnica y los recursos espectrales necesarios para replicar estos avances. La ventaja competitiva no vendrá de tener 5G, sino de implementarlo correctamente, y ejemplos como este marcan la diferencia entre operadores que lideran tecnológicamente y aquellos que simplemente siguen tendencias de marketing.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • Anthropic cierra acuerdo masivo de computo con SpaceX

    Anthropic cierra acuerdo masivo de computo con SpaceX

    Anthropic ha cerrado un acuerdo masivo de computo con SpaceX que le dará acceso a más de 300 megavatios de capacidad en el datacenter Colossus 1. El trato, que entrará en vigor este mismo mes, representa una de las alianzas de infraestructura más significativas entre una empresa de IA y un proveedor de compute externo hasta la fecha.

    Un acuerdo que rompe moldes en la industria

    El datacenter Colossus 1 de SpaceX, diseñado inicialmente para soportar las operaciones de Starlink y otras iniciativas de la compañía de Elon Musk, ahora abrirá sus puertas a Anthropic. Los 300 megavatios de capacidad representan una cantidad considerable de poder de procesamiento, suficiente para entrenar y ejecutar modelos de IA a gran escala. Para poner esto en perspectiva, un datacenter típico de hiperescala consume entre 20 y 50 megavatios.

    Este movimiento marca un precedente inusual en la industria. Tradicionalmente, las empresas de IA han dependido de proveedores cloud como AWS, Google Cloud o Azure, o han construido su propia infraestructura. Que Anthropic recurra a SpaceX sugiere tanto la escasez de capacidad disponible en el mercado como la búsqueda de alternativas más flexibles y potencialmente más económicas.

    Las implicaciones técnicas del Colossus 1

    El datacenter Colossus 1 fue construido originalmente para manejar la constelación Starlink, que requiere procesamiento masivo de datos satelitales en tiempo real. Esta infraestructura incluye sistemas de refrigeración avanzados, redundancia energética y conectividad de alta velocidad, características que lo hacen atractivo para cargas de trabajo de IA intensivas. La ubicación exacta del datacenter no ha sido revelada, pero se especula que está en Texas, cerca de las instalaciones de SpaceX en Boca Chica.

    Para Anthropic, este acuerdo resuelve uno de los mayores cuellos de botella en el desarrollo de IA: el acceso a compute suficiente. La empresa ha estado compitiendo directamente con OpenAI en el desarrollo de modelos de lenguaje avanzados, y el acceso a esta capacidad adicional podría acelerar significativamente sus ciclos de entrenamiento y permitir experimentos con modelos más grandes. El timing es crucial, ya que la industria se prepara para la próxima generación de LLMs que requerirán órdenes de magnitud más compute que los actuales.

    Qué significa este movimiento para el mercado

    Este acuerdo señala una diversificación del mercado de infraestructura para IA. Hasta ahora, los grandes proveedores cloud han dominado este espacio, pero la entrada de SpaceX como proveedor de compute sugiere que empresas con infraestructura subutilizada podrían convertirse en jugadores relevantes. Esto podría presionar los precios a la baja y ofrecer más opciones a las empresas de IA que buscan alternativas a los proveedores tradicionales.

    Para SpaceX, monetizar la capacidad excedente de Colossus 1 representa una nueva línea de ingresos que puede ayudar a financiar sus ambiciosas metas espaciales. La empresa de Musk ha demostrado repetidamente su capacidad para encontrar sinergias entre sus diferentes ventures, y este acuerdo con Anthropic encaja perfectamente en esa estrategia. Además, la experiencia ganada al servir cargas de trabajo de IA podría beneficiar futuras aplicaciones espaciales que requieran procesamiento inteligente a bordo.

    Análisis Blixel

    La escasez de compute se ha convertido en el nuevo petróleo de la era de la IA, y este acuerdo lo demuestra de forma contundente. Que Anthropic tenga que recurrir a SpaceX para conseguir 300 megavatios revela hasta qué punto la demanda ha superado la oferta en el mercado tradicional. Los grandes cloud providers están saturados, las GPUs H100 siguen siendo un bien escaso, y las empresas de IA están dispuestas a explorar alternativas poco convencionales. Este movimiento podría abrir las compuertas a un mercado secundario de compute donde empresas con infraestructura subutilizada—desde mineras de Bitcoin hasta centros de investigación—se conviertan en proveedores de capacidad para IA. Para las empresas españolas que evalúan proyectos de IA, esto es una señal clara: la infraestructura será el factor limitante, no la tecnología. Planificar con antelación y diversificar proveedores ya no es opcional, es supervivencia.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • Anthropic SpaceX colaboracion centros datos IA Claude

    Anthropic SpaceX colaboracion centros datos IA Claude

    La Anthropic SpaceX colaboracion centros datos IA marca un hito en la escalabilidad de modelos de lenguaje empresariales. Esta alianza estrategica entre la creadora de Claude y la empresa aeroespacial de Elon Musk busca revolucionar la infraestructura computacional necesaria para entrenar y desplegar IA a gran escala. Para las empresas espanolas que evaluan integrar Claude en sus operaciones, esta colaboracion promete mejores tiempos de respuesta y mayor disponibilidad del servicio.

    Detalles de la colaboracion Anthropic SpaceX en infraestructura

    La alianza aprovecha la experiencia de SpaceX en sistemas de alta precision y tolerancia a fallos para optimizar los centros de datos de Anthropic. SpaceX aporta su conocimiento en refrigeracion avanzada, gestion energetica eficiente y sistemas de respaldo criticos, tecnologias desarrolladas originalmente para misiones espaciales. Esta Anthropic SpaceX colaboracion centros datos IA incluye el diseno de arquitecturas de red de baja latencia y sistemas de distribucion geografica que garantizan disponibilidad del 99.9% para Claude.

    Los nuevos centros incorporaran tecnologia de enfriamiento por inmersion liquida, similar a la utilizada en los sistemas de soporte vital de las naves Dragon. Esta innovacion reduce el consumo energetico en un 40% comparado con refrigeracion tradicional por aire, mientras permite densidades de GPU superiores. Anthropic espera completar la primera fase de expansion en seis centros estrategicos durante 2024, con capacidad para 50,000 GPUs H100 adicionales.

    Impacto en rendimiento y escalabilidad de Claude

    Esta infraestructura mejorada permitira a Anthropic reducir los tiempos de inferencia de Claude en un 35% y aumentar el throughput de tokens procesados simultaneamente. Para empresas que integran Claude via API, esto se traduce en respuestas mas rapidas en chatbots, analisis de documentos y tareas de generacion de contenido. La colaboracion tambien habilita el despliegue de modelos Claude mas grandes sin comprometer la velocidad de respuesta.

    La experiencia de SpaceX en sistemas distribuidos criticos aporta redundancia geografica que minimiza interrupciones del servicio. Si un centro experimenta problemas, el trafico se redirige automaticamente a instalaciones alternativas en menos de 200 milisegundos. Esta robustez resulta crucial para aplicaciones empresariales que requieren disponibilidad constante, como sistemas de atencion al cliente automatizada o plataformas de analisis en tiempo real.

    Aplicaciones practicas Anthropic SpaceX para empresas espanolas

    Las PYMEs espanolas que consideren integrar Claude deben evaluar como esta Anthropic SpaceX colaboracion centros datos IA mejora sus casos de uso especificos. Para empresas de e-commerce, los tiempos de respuesta reducidos permiten chatbots mas fluidos que no frustren a los clientes. En el sector legal, el procesamiento mas rapido de documentos largos agiliza revisiones contractuales y analisis de compliance. Las consultoras pueden ofrecer servicios de analisis de datos mas competitivos gracias a la mayor capacidad de procesamiento.

    Sin embargo, las empresas deben considerar que esta mejora en infraestructura podria reflejarse en ajustes de precios de la API de Claude. Anthropic ha indicado que mantendra los precios actuales durante 2024, pero es probable que introduzca tiers premium con acceso prioritario a la nueva infraestructura. Las empresas con volumenes altos de procesamiento deberian negociar contratos anuales antes de que estos cambios entren en vigor.

    Analisis Blixel

    Esta Anthropic SpaceX colaboracion centros datos IA representa una movida inteligente que va mas alla del marketing. SpaceX no solo aporta capital, sino expertise real en sistemas criticos que Anthropic necesita para competir con Google y Microsoft en infraestructura. La experiencia aeroespacial en gestion termica y redundancia se traduce directamente en ventajas operativas para Claude. Para las empresas espanolas, esto significa que Anthropic se posiciona como alternativa mas robusta a GPT-4, especialmente para aplicaciones que requieren alta disponibilidad. La colaboracion tambien sugiere que Anthropic planea expandirse agresivamente en Europa, donde la latencia desde centros de datos estadounidenses penaliza el rendimiento. Recomendamos a las PYMEs que esten evaluando proveedores de IA considerar esta alianza como indicador de la seriedad de Anthropic sobre infraestructura empresarial, pero mantengan contratos flexibles hasta que los beneficios se materialicen en produccion.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Cuellos de botella IA 2024: escasez chips y energia frenan

    Cuellos de botella IA 2024: escasez chips y energia frenan

    Los cuellos de botella IA 2024 están limitando el crecimiento de la industria más allá de las previsiones iniciales. Cinco ejecutivos clave del ecosistema artificial discutieron en la Milken Global Conference los obstáculos críticos que enfrentan las empresas: desde la escasez severa de semiconductores hasta restricciones energéticas que obligan a Google a explorar centros de datos espaciales. Estos problemas no son teóricos sino realidades operativas que afectan directamente la capacidad de las empresas para implementar y escalar soluciones de IA.

    Escasez de chips: el cuello de botella principal en IA

    La demanda de GPUs especializadas para IA supera dramáticamente la oferta disponible. Los hyperscalers como Amazon, Microsoft y Google no pueden obtener todos los chips que necesitan, creando una cascada de retrasos en proyectos empresariales. NVIDIA, que controla aproximadamente el 80% del mercado de chips para IA, no puede aumentar la producción lo suficientemente rápido debido a limitaciones en la fabricación de semiconductores avanzados. TSMC y Samsung, los principales fabricantes, operan a capacidad máxima con listas de espera que se extienden hasta 18 meses.

    Esta escasez tiene consecuencias directas para las PYMEs españolas que dependen de servicios cloud. Los proveedores priorizan a clientes enterprise con contratos millonarios, dejando a empresas medianas con acceso limitado a recursos de GPU. El coste por hora de computación GPU ha aumentado entre 40-60% en los últimos 12 meses, según datos de múltiples proveedores cloud. Empresas que planificaban implementar modelos de IA personalizados se ven forzadas a utilizar APIs de terceros, perdiendo control sobre sus datos y capacidades de customización.

    Limitaciones energéticas obligan a repensar la infraestructura

    El consumo energético de los centros de datos de IA está alcanzando límites físicos en muchas regiones. Google explora seriamente la construcción de centros de datos espaciales para evitar restricciones terrestres de energía y refrigeración. Un centro de datos moderno para IA puede consumir entre 50-100 megavatios, equivalente al consumo de una ciudad mediana. Las redes eléctricas existentes en muchas ubicaciones no pueden soportar esta demanda adicional sin inversiones masivas en infraestructura.

    Microsoft ha invertido más de 15.000 millones de dólares en 2024 en nueva infraestructura energética, incluyendo acuerdos directos con plantas nucleares y parques solares dedicados. Amazon anunció que construirá reactores nucleares modulares pequeños (SMR) específicamente para alimentar sus centros de datos de IA. Estas inversiones reflejan la magnitud del problema: la IA no es solo un desafío tecnológico sino energético. Para 2030, se estima que los centros de datos de IA consumirán el 8% de la electricidad global, comparado con el 1% actual.

    Cuellos de botella IA impactan directamente a empresas españolas

    Las PYMEs españolas que evalúan implementar IA deben considerar estos cuellos de botella en su planificación estratégica. Los costes de computación seguirán siendo volátiles y los tiempos de acceso a recursos GPU impredecibles durante al menos 24 meses. Empresas que dependan de entrenar modelos propios necesitan presupuestos flexibles y planes de contingencia. Una alternativa práctica es comenzar con modelos pre-entrenados y APIs, evaluando gradualmente la migración hacia infraestructura propia cuando la situación se estabilice.

    Google Cloud reportó ingresos de 20.000 millones de dólares el último trimestre con crecimiento del 63%, mientras su backlog casi se duplicó de 250.000 a 460.000 millones de dólares. Este backlog masivo indica demanda reprimida: empresas dispuestas a pagar pero sin acceso inmediato a recursos. Para empresas españolas, esto significa que los contratos cloud deben negociarse con mayor anticipación y flexibilidad en fechas de entrega. Considerar proveedores alternativos como OVHcloud o proveedores locales puede ofrecer mejor disponibilidad, aunque con limitaciones en servicios especializados de IA.

    Análisis Blixel

    Los cuellos de botella IA 2024 revelan una industria en transición acelerada donde la demanda supera dramáticamente la capacidad de suministro. No es una crisis temporal sino una realidad estructural que durará años. Las empresas que esperan a que se «normalice» el mercado perderán ventaja competitiva, pero las que se lanzan sin considerar estas limitaciones enfrentarán sobrecostes y retrasos significativos. La estrategia inteligente es implementación gradual: comenzar con soluciones que no dependan de recursos GPU intensivos, construir competencias internas y preparar infraestructura para escalar cuando la disponibilidad mejore. Google explorando centros espaciales no es ciencia ficción sino pragmatismo empresarial ante restricciones terrestres reales. Para PYMEs españolas, esto significa que la IA seguirá siendo cara y compleja de implementar, pero también que las empresas que lo hagan correctamente tendrán ventajas sostenibles cuando la competencia aún esté evaluando opciones.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.
  • Google invertirá 40B en Anthropic: ¿Impacto en tu negocio IA?

    Google invertirá 40B en Anthropic: ¿Impacto en tu negocio IA?

    La carrera por el dominio de la Inteligencia Artificial no frena, y hoy tenemos un anuncio que redefine el tablero. Google invertirá hasta 40B en Anthropic (la empresa detrás del modelo Claude) en una operación que combina capital y una cantidad ingente de recursos computacionales. No hablamos solo de dinero, sino de la infraestructura que alimenta el futuro de la IA. Para cualquier empresa que esté planteándose cómo integrar o escalar soluciones de inteligencia artificial, esta noticia es crucial.

    La estructura de esta inversión es compleja, pero importante de entender. Incluye 10.000 millones de dólares inmediatos a una valoración de 350.000 millones para Anthropic, con otros 30.000 millones condicionados a metas de rendimiento a largo plazo. Es un voto de confianza estratosférico en el potencial de Anthropic y, por extensión, en la demanda insaciable de capacidad de cómputo para la IA. Esta alianza no es nueva; amplía una asociación previa con Anthropic y Broadcom, centrada en el desarrollo de chips de IA personalizados de Google, las famosas TPU (Tensor Processing Units).

    Google invertirá hasta 40B en Anthropic: El músculo computacional detrás del acuerdo

    El verdadero quid de la cuestión para las empresas no es solo la inversión monetaria, sino el compromiso computacional. Inicialmente, Google ya había apalabrado la provisión de múltiples gigavatios de TPUs para servicios desde 2027. Ahora, esta nueva fase añade 5 GW adicionales a través de Google Cloud en los próximos cinco años, con promesas de escalabilidad futura. Para que nos entendamos, esto es como duplicar o triplicar la capacidad de un motor ya potente. Las TPUs son aceleradores diseñados específicamente por Google para el entrenamiento e inferencia de modelos grandes de lenguaje (LLMs), ofreciendo una eficiencia superior en operaciones de punto flotante por segundo (FLOPS) comparado con las GPUs tradicionales para estas cargas de trabajo.

    ¿Qué significa esto en la práctica? La infraestructura de Anthropic para modelos como Claude se verá robustecida enormemente, mitigando uno de los cuellos de botella más importantes en el desarrollo actual de la IA: la disponibilidad de cómputo de alto rendimiento. Para las PYMES, esto se traduce en la posibilidad de acceso a modelos más potentes, rápidos y eficientes a medida que Google Cloud los ponga a disposición.

    Implicaciones para empresas y la guerra de la IA

    Esta jugada de Google se sitúa en el centro de la ‘guerra de la IA’ entre los gigantes tecnológicos. Al invertir en un competidor clave como Anthropic, Google no solo asegura influencia, sino que optimiza la utilización de su propio hardware propietario, las TPUs. Esto puede resultar en una mayor integración entre los servicios de Google Cloud y los modelos de Anthropic, impactando directamente en APIs, capacidades de fine-tuning y despliegues a escala empresarial. Para una PYME que ya utiliza Google Cloud o que está valorando proveedores de IA, esta sinergia podría facilitar la implementación y gestión de sus soluciones. Pensemos en APIs más robustas, mayor capacidad de personalización y tiempos de respuesta mejorados. La elección de la plataforma y el modelo de IA adecuados se vuelve aún más crítica; es fundamental entender cómo se alinean estas alianzas con nuestras propias estrategias tecnológicas. Aquí puedes encontrar más información sobre cómo el Cloud Computing potencia la IA.

    Análisis Blixel: Google y Anthropic, tu hoja de ruta

    Desde Blixel, vemos esta inversión de Google como una señal clara: la infraestructura y la capacidad de cómputo son las verdaderas divisas en la economía de la IA. ¿Qué significa esto para tu empresa? Primero, si ya trabajas con Google Cloud, las soluciones de Anthropic podrían integrarse de forma más fluida y eficiente en el futuro. Es un buen momento para explorar cómo Claude podría complementar tus operaciones, especialmente si necesitas modelos de lenguaje de gran capacidad.

    Segundo, esto refuerza la tesis de que la IA se democratizará aún más gracias a estas alianzas potentes que abordan cuellos de botella computacionales. Empresas de todos los tamaños, incluidas las PYMES, podrán acceder a niveles de procesamiento de IA que antes eran impensables. Sin embargo, no hay que dormirse. La elección de modelos y la estrategia de implementación deben ser proactivas. Evalúa tus necesidades, investiga cómo los modelos más recientes pueden resolverlas y prepárate para aprovechar esta marea tecnológica.

    La capacidad de cómputo que Google invertirá hasta 40B en Anthropic abre la puerta a una nueva generación de aplicaciones y servicios. Asegúrate de estar preparado para capitalizarla.

    Fuente: TechCrunch

  • Google lanza TPUs 8ª generación: más allá de Nvidia

    Google lanza TPUs 8ª generación: más allá de Nvidia

    En el reciente evento Google Cloud Next 2026, Google lanza TPUs 8ª generación, dos nuevos procesadores, el TPU 8t y el TPU 8i, optimizados para revolucionar el desarrollo y despliegue de la inteligencia artificial. Google está apostando fuerte por este hardware, buscando no solo satisfacer la creciente demanda de la IA sino también establecer una competencia seria con gigantes como Nvidia. Para las empresas, esto significa más opciones y, potencialmente, una mayor eficiencia en sus proyectos de IA.

    Google lanza TPUs 8ª generación: El 8t para Entrenamiento a Gran Escala

    El TPU 8t ha sido diseñado específicamente para el entrenamiento de modelos de IA a gran escala, incluyendo la artillería pesada de los Grandes Modelos de Lenguaje (LLM). Lo crucial aquí es que la colaboración con Google DeepMind ha permitido crear un chip que reduce los ciclos de desarrollo de meses a semanas. Esto no es una promesa vacía; es un dato que debería resonar con cualquier directivo de PYME que entienda el coste y el tiempo implicado en la innovación. Para vuestros equipos de desarrollo, esto se traduce en una capacidad sin precedentes para iterar y lanzar productos de IA al mercado mucho más rápido.

    Este nuevo TPU potencia supercomputadoras personalizadas, abordando así las demandas de arquitecturas de modelos en constante evolución. En un mercado donde la velocidad es oro, el TPU 8t podría ser el activo diferenciador que una empresa necesita para mantenerse a la vanguardia. La posibilidad de entrenar modelos complejos en una fracción del tiempo abre la puerta a experimentos más audaces y a la adaptación ágil a nuevas tendencias tecnológicas. Más contexto e información podéis encontrar, por ejemplo, en cómo Google ha ido evolucionando su hardware de IA.

    El TPU 8i: Eficiencia en Inferencias y Despliegue en Producción

    Mientras el 8t se enfoca en el músculo del entrenamiento, el TPU 8i pisa fuerte en el terreno de la inferencia y el aprendizaje por refuerzo. Aquí, Google promete un 80% de mejora en rendimiento por dólar respecto a la generación anterior. Esta cifra no es menor, especialmente para aquellas empresas que están moviendo modelos de IA de la fase de prototipo a la producción. El coste de la inferencia puede escalar rápidamente, y una mejora del 80% en eficiencia económica es un argumento de peso para considerar el TPU 8i en vuestras infraestructuras.

    Estos chips se integran en la infraestructura AI Hypercomputer de Google, que combina cómputo de alto rendimiento, almacenamiento rápido y remediación automatizada. Esto significa no solo hardware potente, sino un ecosistema completo diseñado para optimizar el ciclo de vida de la IA. Las velocidades récord en desarrollo de productos que menciona Google no son solo un eslogan; son una oportunidad para que vuestras empresas agilicen lanzamientos y mejoren la competitividad.

    Análisis Blixel: Implicaciones Reales de los TPUs de Google

    Desde Blixel, vemos con optimismo que Google lanza TPUs 8ª generación. Para las PYMEs, esta noticia es de doble filo pero con un matiz positivo. Primero, la clara competencia con Nvidia significa que la carrera por la eficiencia y el precio se intensificará, lo que debería traducirse en costes más accesibles a medio y largo plazo para las cargas de trabajo de IA. Ya sea que optéis por Google Cloud o por otros proveedores, la presión competitiva os beneficiará.

    Segundo, la apuesta de Google por sus propios chips reduce la dependencia de un único proveedor de hardware. Esto es clave en la gestión de riesgos en la cadena de suministro y garantiza una mayor estabilidad a la hora de planificar vuestra estrategia de IA. Nuestra recomendación es empezar a evaluar las ofertas de Google Cloud que integran estos nuevos TPUs, especialmente si ya tenéis cargas de trabajo significativas en inferencia o estáis contemplando el entrenamiento de modelos de lenguaje propios. No se trata de un cambio radical mañana, pero sí de una señal clara de dónde se dirige el mercado y de las oportunidades que se abren para optimizar vuestros presupuestos y tiempos de desarrollo.

    Adicionalmente, los acuerdos estratégicos de Google, incluyendo un pacto multibillonario con Anthropic para el acceso a hasta 1 millón de TPUs, solidifican su posición como proveedor líder de infraestructura AI. Estos movimientos no solo aseguran la visibilidad de ingresos para Google Cloud, sino que también garantizan la disponibilidad y escalabilidad de estos recursos para empresas como la vuestra. Al diversificar su dependencia de GPUs Nvidia, Google está construyendo una base sólida para un futuro de IA más versátil y eficiente.

    Fuente: TechCrunch

  • Anthropic x Amazon: 5 GW de cómputo Trainium2 y revenue que se triplica a 30 B$

    Anthropic x Amazon: 5 GW de cómputo Trainium2 y revenue que se triplica a 30 B$

    Abril 2026 cierra con uno de los movimientos de infraestructura de IA más grandes del año: Anthropic suma 5 gigavatios de capacidad de cómputo con Amazon sobre chips Trainium2 para H1 2026, al tiempo que su revenue anualizado pasa de ~9 B$ a cierre de 2025 a más de 30 B$. A esto se suma la incorporación de Vas Narasimhan (ex-CEO de Novartis) al Board, señal de peso sobre hacia dónde mira la compañía.

    5 GW Trainium2: el acuerdo de infraestructura

    El número es considerable. 5 gigavatios de capacidad computacional dedicados a entrenamiento y despliegue de Claude, situados en centros de datos de AWS y construidos sobre la nueva generación de chips propietarios Trainium2. Para contexto: la mayor parte de centros de datos hiperescalares operan en rangos de cientos de megavatios; 5 GW es equivalente al consumo de una ciudad mediana.

    La apuesta por Trainium2 tiene dos lecturas. Por un lado, Anthropic diversifica su dependencia histórica del hardware NVIDIA. Por otro, AWS consolida Trainium como alternativa real a la H100/H200 de NVIDIA y a los TPU de Google. Para la industria, significa que la competencia en infraestructura de IA se intensifica en 2026, lo que debería traducirse en precios más estables para los usuarios finales del stack.

    Revenue x3,3 en 4 meses: 9 B$ → 30+ B$

    El dato financiero es probablemente más llamativo que el de infraestructura. El revenue anualizado de Anthropic ha pasado de ~9.000 millones de dólares a cierre de 2025 a más de 30.000 millones de dólares a cierre del primer trimestre de 2026. Un crecimiento 3,3× en cuatro meses que sitúa a Anthropic en la conversación directa con OpenAI en términos de escala comercial.

    Qué hay detrás del crecimiento:

    • Adopción acelerada de Claude en empresas Fortune 500, tras Opus 4.6 y 4.7
    • Crecimiento exponencial de Claude Code como plataforma para equipos técnicos
    • Nuevos productos enterprise (Cowork, Managed Agents) monetizados
    • Expansión internacional con contratos grandes en APAC y Europa

    Vas Narasimhan al Board: la apuesta por salud y farmacéutica

    Un detalle estratégico importante: Anthropic incorpora a Vas Narasimhan, ex-CEO de Novartis (2018-2024), al Board de directores. La señal es clara: Anthropic quiere aumentar su peso en farmacéutica, salud y ciencias de la vida, sectores con volúmenes altos, compliance complejo y necesidad de IA especializada (análisis regulatorio, farmacovigilancia, investigación clínica).

    Narasimhan aporta relaciones directas con grandes farmacéuticas globales y conocimiento profundo de los ciclos regulatorios FDA/EMA. Es el tipo de incorporación que suele preceder a movimientos de producto específico para el sector o a asociaciones estratégicas con grandes grupos pharma.

    Análisis Blixel: qué significa este pulso de infraestructura para empresas medianas

    Los 5 GW de capacidad añadida tienen un efecto directo y positivo para cualquier empresa que use Claude: capacidad disponible, menor probabilidad de rate limits en picos y latencias más estables. Los grandes acuerdos de infraestructura suelen traducirse en mejor calidad de servicio para el cliente final, aunque no lo veamos en el marketing.

    El crecimiento de revenue también tiene implicaciones indirectas. Un Anthropic con 30 B$ de revenue anualizado puede sostener inversión agresiva en investigación y producto, pero también presiona para capturar mercado enterprise de forma más activa (de ahí Cowork y Managed Agents). Para empresas medianas, el mejor momento para negociar condiciones favorables es ahora, cuando la compañía busca crecimiento acelerado de cuentas.

    Finalmente, la señal farmacéutica con Narasimhan es un indicador de dónde va a haber producto específico en 12-18 meses. Si tu empresa opera en salud, biotech o farmacéutica, merece la pena evaluar cómo posicionarse temprano con el stack de Anthropic antes de que el mercado se sature.

    Desde Blixel AI seguimos de cerca estos movimientos de infraestructura porque afectan directamente a la arquitectura que recomendamos a nuestros clientes. Si estás evaluando elegir proveedor (Anthropic, OpenAI, Google, on-premise con Llama/Qwen), podemos ayudarte a tomar una decisión con criterio técnico y comercial realista.

    Implementa IA en tu empresa con Blixel

    Desde Blixel AI acompañamos a empresas en cada fase: diagnóstico, elección de modelo, implementación y formación del equipo. Si estas novedades de Anthropic cambian tu hoja de ruta de IA, podemos ayudarte a priorizar qué adoptar primero y cómo hacerlo sin romper lo que ya funciona.

    👉 Agenda una videollamada gratuita para revisar tu caso. 30 minutos, sin compromiso, con criterio técnico real.

    Fuentes: Anthropic News, anuncios corporativos AWS, informes financieros Q1 2026 y reportes de industria.

  • AWS EC2 G7e: la nueva generación para inferencia IA

    AWS EC2 G7e: la nueva generación para inferencia IA

    Amazon Web Services (AWS) acaba de lanzar las instancias AWS EC2 G7e para inferencia IA, marcando un antes y un después en el procesamiento de cargas de trabajo de inteligencia artificial generativa. Estas nuevas instancias, potenciadas por GPUs NVIDIA RTX 6000 Ada Blackwell Server Edition, prometen un rendimiento de inferencia hasta 2.3 veces superior en comparación con la generación anterior (G6e). Para cualquier negocio que dependa de modelos de lenguaje grandes (LLMs), IA agéntica o modelos multimodales, esto no es solo una mejora, es una oportunidad de escalar de forma más eficiente y económica.

    AWS EC2 G7e: Un paso adelante en inferencia de IA

    La capacidad de procesar la inferencia de IA de manera rápida y eficiente es crítica. Un cuello de botella en este punto puede significar costes operativos disparados o una experiencia de usuario deficiente. Las instancias G7e abordan directamente estos desafíos con mejoras significativas:

    • Un ancho de banda de memoria GPU 1.85 veces mayor.
    • 1.27 veces más TFLOPs, lo que se traduce en mayor potencia computacional.
    • 2 veces más memoria GPU, elevando la capacidad para modelos más grandes.
    • Hasta 4 veces más ancho de banda GPU-a-GPU, crucial para la comunicación entre procesadores.

    Estas características permiten que las G7e manejen modelos de hasta 70 mil millones de parámetros con una precisión FP8 en una única GPU, algo impensable hace poco tiempo. Esto significa que las empresas pueden ejecutar modelos más sofisticados y complejos sin la necesidad de fragmentarlos, simplificando la gestión y reduciendo la latencia. La arquitectura también soporta comunicación directa entre GPUs (NVIDIA GPUDirect P2P vía PCIe), optimizando el rendimiento en despliegues multi-GPU. Para aquellos interesados en profundizar en las soluciones existentes, es relevante revisar las soluciones de IA en la nube disponibles en AWS.

    Análisis Blixel: Implicaciones prácticas de las G7e

    Desde Blixel, vemos en las AWS EC2 G7e para inferencia IA una herramienta potentísima para PYMEs y startups que busquen optimizar sus operaciones con inteligencia artificial. La mejora en rendimiento no es solo un dato técnico; implica una reducción directa en el tiempo de respuesta de aplicaciones con IA, lo que se traduce en una mejor experiencia para el cliente y, potencialmente, en una ventaja competitiva. Piensen en asistentes virtuales más rápidos, análisis de datos en tiempo real con mayor precisión o sistemas de recomendación más eficientes. Sin embargo, no todo es encender y usar. Es fundamental que las empresas evalúen sus modelos actuales y planifiquen la migración, asegurándose de que la inversión en estas instancias se alinee con el retorno esperado. El soporte para plataformas de orquestación como Amazon ECS, EKS y AWS Parallel Computing Service, junto con Amazon SageMaker HyperPod, facilita la escalabilidad, pero la configuración inicial sigue requiriendo una estrategia clara.

    Para las empresas que están en plena fase de expansión de capacidades de IA, la posibilidad de consolidar modelos complejos en una sola instancia o de escalar a docenas de GPUs sin una configuración manual exhaustiva es un ahorro de tiempo y recursos considerable. Es importante recordar que el uso eficiente de estas instancias no solo depende del hardware, sino también de la optimización del software y de los modelos —aquí es donde una buena consultoría técnica puede marcar la diferencia.

    Optimización para grandes modelos y computación científica

    Las G7e no solo destacan en inferencia. Su diseño permite alojar hasta 768 GB de memoria GPU en un único nodo, una capacidad crucial para desplegar modelos muy grandes sin la necesidad de fragmentación, lo que simplifica la gestión y reduce la complejidad operativa. Además, estas instancias están optimizadas para la computación espacial y científica, ofreciendo hasta 4 veces mayor ancho de banda CPU-a-GPU. Esto abre puertas a innovaciones en sectores como la investigación genómica, la simulación de materiales o el desarrollo farmacéutico, donde las grandes cantidades de datos y la necesidad de cálculos complejos son la norma.

    La versatilidad de las AWS EC2 G7e para inferencia IA se extiende a su compatibilidad con múltiples plataformas de orquestación. Ya sea que su empresa utilice Amazon ECS para contenerización, Amazon EKS para Kubernetes o AWS Parallel Computing Service, las G7e se integran sin problemas. Además, el soporte para Amazon SageMaker HyperPod permite escalar rápidamente a clústeres de GPUs sin necesidad de configuraciones manuales complejas, liberando a los equipos de desarrollo para que se centren en la innovación y no en la infraestructura.

    Fuente: AWS News Blog

  • Cerebras IPO: Impacto en el futuro del hardware IA empresarial

    Cerebras IPO: Impacto en el futuro del hardware IA empresarial

    La carrera por el liderazgo en hardware de Inteligencia Artificial acaba de acelerarse. Cerebras IPO es una realidad, con la startup pionera en chips de IA de alto rendimiento presentando su solicitud ante la SEC para una Oferta Pública Inicial. Este movimiento estratégico no es un detalle menor; marca un hito significativo en cómo las empresas, grandes y pequeñas, podrán acceder y utilizar la IA más potente.

    Cerebras IPO: ¿Qué significa este avance en chips de IA?

    Cerebras Systems no es una compañía más en el sector tecnológico. Se ha labrado una reputación con su arquitectura Wafer-Scale Engine (WSE), que es, a día de hoy, el procesador de IA más grande del mundo. Hablamos de un chip que integra millones de núcleos en un solo wafer de silicio, diseñado específicamente para entrenamiento e inferencia de modelos de IA a gran escala. Esto se traduce en una capacidad de procesamiento brutal, llegando hasta los 125 petaflops con su última generación, el WSE-3.

    Para las PYMES, esto implica que la barrera de entrada al cómputo IA de alto nivel podría reducirse a medio plazo. Actualmente, la mayor limitación para muchas empresas es el acceso a infraestructuras potentes y asequibles. Una empresa como Cerebras con mayor capital podría democratizar estas tecnologías, permitiendo a negocios más pequeños ejecutar modelos complejos sin depender exclusivamente de soluciones en la nube de gigantes tecnológicos.

    El impacto de Cerebras en el ecosistema de hardware IA

    El anuncio de la Cerebras IPO llega en un momento de enorme demanda por chips eficientes. El acuerdo reportado con OpenAI, valorado en más de $20 mil millones, subraya la posición de Cerebras como un proveedor clave para los grandes jugadores del ecosistema de IA. Sin embargo, su tecnología tiene implicaciones mucho más amplias.

    Al eliminar la complejidad de las interconexiones multi-chip tradicionales, Cerebras ofrece ventajas significativas en velocidad de entrenamiento y eficiencia energética. Para una empresa, esto puede traducirse en menores costos operativos y tiempos de desarrollo más cortos para sus aplicaciones de IA. Más allá de NVIDIA, Cerebras está demostrando que hay otras opciones robustas para acelerar la computación de IA. La competencia en el sector de las GPUs es una señal excelente para el mercado.

    Análisis Blixel: Implicaciones directas para su negocio

    Desde Blixel, vemos la Cerebras IPO como una oportunidad crucial para la diversificación del hardware IA. Si bien la inversión directa en Cerebras Systems puede no ser una prioridad para su PYME, la consecuencia de su éxito sí lo es. Un mercado de chips más competitivo significa mejores precios y tecnologías más accesibles.

    Recomendación accionable: Esté atento a cómo esta IPO impacta el costo y la disponibilidad de los servicios de IA que consume o planea consumir. Un aumento en la competencia entre fabricantes de chips podría traducirse en soluciones de IA en la nube más potentes y económicas. Considere analizar sus necesidades de cómputo IA y evalúe si la eficiencia de arquitecturas como la de Cerebras podría ofrecerle una ventaja competitiva en el futuro. No se trata solo de la tecnología, sino de cómo esa tecnología se traduce en acceso y costes para su estrategia de IA.

    La capacidad de Cerebras para manejar modelos con miles de billones de parámetros de manera eficiente es un factor diferenciador. En un futuro no muy lejano, esto podría permitir a cualquier negocio, independientemente de su tamaño, acceder a capacidades de IA que hoy están reservadas para gigantes.

    Fuente: TechCrunch

  • Kepler Compute: El mayor clúster de cómputo orbital comercial

    Kepler Compute: El mayor clúster de cómputo orbital comercial

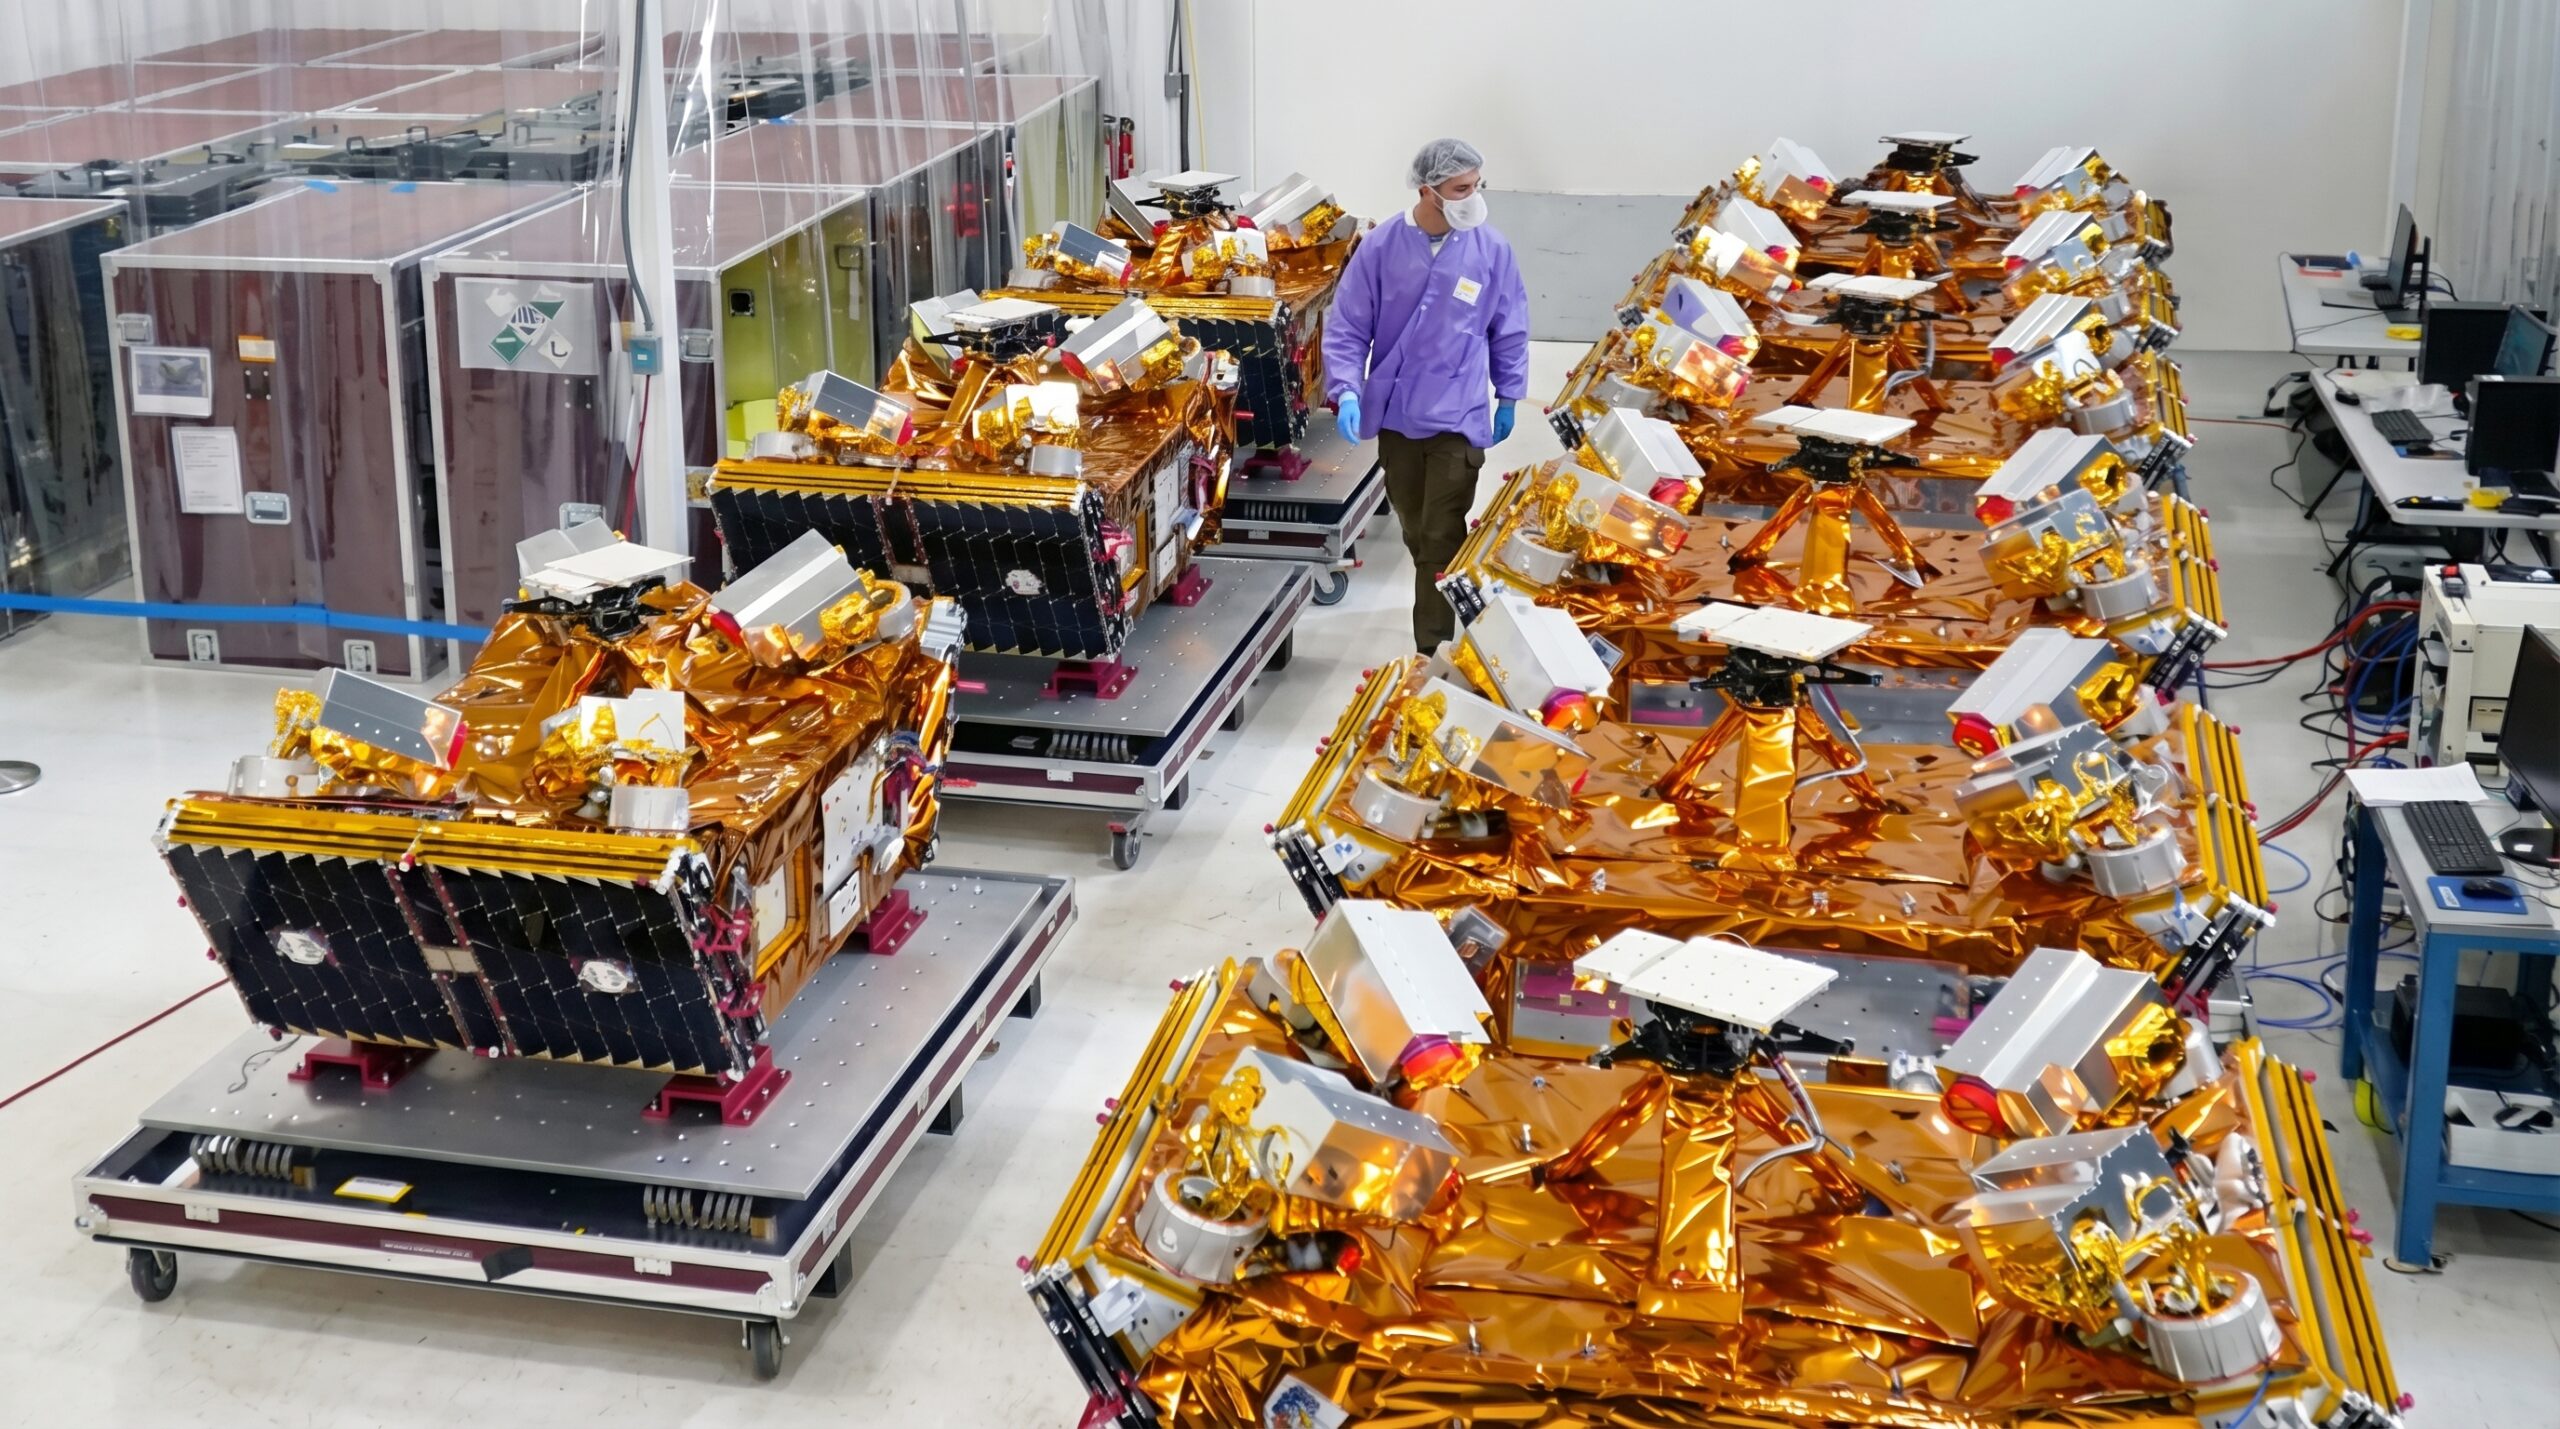
    La empresa Kepler Communications ha activado Kepler Compute, el mayor clúster de cómputo orbital del mundo. Este hito tecnológico, operativo desde marzo de 2026, implica una constelación de 10 satélites en órbita terrestre baja (LEO), cada uno equipado con cuatro módulos NVIDIA Jetson Orin, sumando 40 GPUs distribuidas en el espacio. Esto no es solo una proeza de ingeniería, sino una plataforma para reinventar cómo las empresas interactúan con los datos y la inteligencia artificial.

    Kepler Compute: Más allá de los centros de datos terrestres

    La arquitectura de Kepler Compute está diseñada para el procesamiento de datos en tiempo real a 400 km de altitud. La clave está en la interconectividad: enlaces ópticos intersatelitales de alta velocidad que permiten la escalabilidad, distribución de cargas de trabajo y una notable tolerancia a fallos. ¿El beneficio? Elimina la necesidad de descargar masivamente datos a centros terrestres para su procesamiento, reduciendo la latencia y abriendo un abanico de posibilidades para aplicaciones que requieren inmediatez, como la observación terrestre, las telecomunicaciones o la defensa.

    El anuncio de su apertura comercial ya suma 18 clientes. Un ejemplo palpable es la colaboración con Sophia Space, que desplegará su sistema operativo propietario en seis GPUs distribuidas en dos satélites. Esta prueba es la primera adaptación a gran escala de software orbital dinámico, similar a lo que ocurre en un centro de datos terrestre, pero en un entorno de microgravedad y radiación. Aquí puedes ver la noticia original: TechCrunch

    Análisis Blixel: Tu PYME y el cómputo orbital

    Desde Blixel, vemos en Kepler Compute una clara disrupción con implicaciones directas para las PYMES. Si tu negocio depende de la recopilación masiva de datos –sensores en campo, monitoreo ambiental, agricultura de precisión, logística– o si aspiras a desarrollar soluciones de IA que requieran análisis ultra-rápido, Kepler está abriendo una nueva avenida.

    Imagínate poder procesar imágenes satelitales obtenidas para la gestión de cultivos en minutos, sin necesidad de invertir en infraestructura terrestre ni esperar el “downlink”. Esto no es ciencia ficción, es una realidad comercial que permite a las PYMES acceder a capacidades de cómputo espacial bajo un modelo de “as-a-service”, similar a lo que ya conoces con AWS o Google Cloud. Los modelos de negocio de Kepler (conectividad, hosted payloads y cómputo como servicio) están diseñados para democratizar el acceso a esta tecnología. Prepárate para que la IA aplicada se mueva a la órbita baja, redefiniendo los límites de la inmediatez y la eficiencia operativa para tu empresa.

    Este mercado, el de edge computing orbital, no es una moda pasajera. Se proyecta un crecimiento de 1.770 millones de dólares en 2029 a 39.090 millones en 2035, con una CAGR del 67,4%. Este crecimiento exponencial será impulsado por la demanda de IA en sectores clave. Aunque los grandes centros de datos en el espacio (como los que propone SpaceX) tardarán en llegar, la tecnología de Kepler ya es madura y comercialmente viable.

    Fuente: TechCrunch

  • Snap lanzará gafas con IA: ¿Qué significa para tu PYME?

    Snap lanzará gafas con IA: ¿Qué significa para tu PYME?

    La realidad aumentada (AR) está a punto de dar un salto significativo con el anuncio de que Snap lanzará gafas con IA impulsadas por Qualcomm. Esta colaboración estratégica, que involucra a la filial Specs de Snap, marca el resurgimiento de un proyecto ambicioso que promete llevar la inteligencia artificial directamente a la experiencia del usuario a través de un hardware portable y potente. Para las PYMES, entender el impacto de esta tecnología es crucial.

    Snap lanzará gafas con IA: El renacimiento del hardware AR

    Después de un periodo de pausa, Snap ha reactivado su iniciativa de hardware AR con una alianza multimillonaria con Qualcomm. La clave de esta renovación reside en la incorporación de las plataformas Snapdragon XR de Qualcomm, chips diseñados específicamente para dispositivos AR y VR. Esto significa que las nuevas gafas Specs no serán solo un visor, sino un potente computador de IA on-device, capaz de ofrecer gráficos avanzados y experiencias digitales complejas. Esta tecnología abre un abanico de posibilidades que hasta ahora eran impensables sin la dependencia de la nube.

    La integración de IA on-device es el gran diferenciador. A diferencia de versiones anteriores, estas gafas podrán procesar datos en tiempo real, lo que se traduce en una latencia mínima y una mayor privacidad de los datos. Esto es fundamental para aplicaciones que requieren inmediatez, como el reconocimiento de objetos en un entorno o la asistencia contextual. Conoce más sobre la IA on-device y sus beneficios para PYMEs.

    Análisis Blixel: Implicaciones para tu PYME ante el lanzamiento de gafas con IA

    Desde Blixel, vemos con optimismo cauteloso el lanzamiento de estas gafas AR, especialmente porque Snap lanzará gafas con IA. Para una PYME, esto no es ciencia ficción, es una herramienta potencial de negocio. Ya no hablamos solo de filtros divertidos; hablamos de aplicaciones prácticas que pueden revolucionar desde la interacción con clientes hasta la eficiencia operativa.

    Pensemos en el sector retail: visualización de productos en el espacio del cliente antes de la compra, asistentes virtuales contextuales que ofrecen información en tiempo real mientras el cliente interactúa con un producto físico. En el sector industrial, el mantenimiento predictivo asistido por AR, donde un técnico puede superponer diagramas o instrucciones sobre una máquina. La publicidad y el marketing también verán una explosión de formatos inmersivos.

    La recomendación clave es empezar a entender la realidad aumentada. No necesitas invertir ahora mismo en hardware, pero sí en la exploración de casos de uso y en la capacitación interna sobre cómo estas tecnologías pueden encajar en tu estrategia a medio plazo. La privacidad de los datos on-device y el procesamiento en tiempo real son puntos fuertes a considerar para cualquier implementación futura.

    El CEO de Snap, Evan Spiegel, ha sido claro: esta alianza busca establecer una base tecnológica sólida, empujando los límites de lo posible. Las plataformas Snapdragon XR se distinguen por su optimización en la computación espacial, fusionando datos de sensores, seguimiento de movimiento y modelos de IA ligeros. Esto permite inferir y actuar sobre el entorno en tiempo real, un factor que fue un obstáculo para versiones anteriores de las Spectacles de Snap debido a las limitaciones de eficiencia energética y rendimiento.

    ¿Por qué ahora? El contexto del mercado AR

    El momento elegido por Snap para este lanzamiento no es casual. Coincide con un resurgimiento general del sector de la realidad aumentada, en parte impulsado por la entrada de grandes jugadores como Apple con sus Vision Pro. La demanda de experiencias inmersivas y contextuales está creciendo, y la convergencia del hardware AR portátil con la IA edge computing (procesamiento en el dispositivo) es el área donde se están dirimiendo las batallas tecnológicas clave.

    La IA on-device en estas gafas permitirá funcionalidades avanzadas como el reconocimiento de gestos para interactuar con interfaces virtuales, superposiciones contextuales que proporcionan información relevante sobre objetos reales, y asistentes virtuales inmersivos que pueden integrarse de manera fluida en la vida diaria. Estos son los cimientos sobre los que Snap lanzará gafas con IA que van más allá del entretenimiento.

    Preparando tu negocio para la era de la IA visual

    La llegada de dispositivos como las nuevas gafas de Snap acelerará la adopción de la realidad aumentada en muchos frentes. Las empresas que logren integrar estas experiencias en sus flujos de trabajo o en sus estrategias de engagement con el cliente, estarán un paso por delante. La clave no es reaccionar, sino anticipar y prepararse.

    Empieza por identificar procesos donde una superposición de información digital o una interacción manos libres podría mejorar la eficiencia. Considera cómo la visualización 3D o las simulaciones podrían enriquecer la experiencia de tus clientes. La revolución de la IA visual y la AR está en camino, y entender cómo Snap lanzará gafas con IA es una pieza más en este rompecabezas tecnológico.

    Fuente: TechCrunch