
Categoría: IA Aplicada

  • Samsung da ChatGPT y Codex a todos sus empleados

    Samsung da ChatGPT y Codex a todos sus empleados

    La integracion de ChatGPT y Codex para empleados de Samsung marca uno de los despliegues internos de IA generativa mas grandes vistos en una tecnologica de hardware. La compania surcoreana ha puesto las herramientas de OpenAI a disposicion de sus trabajadores para usarlas en sus operaciones diarias, con foco en desarrolladores y otros perfiles profesionales. No es un piloto cerrado ni una prueba de concepto: hablamos de un acceso a escala organizacional que coloca a Samsung entre las primeras del sector en mover estas tecnologias del laboratorio al puesto de trabajo real.

    Que ha pasado y por que importa

    Samsung Electronics ha implementado ChatGPT y Codex de OpenAI como herramientas internas para sus empleados. ChatGPT cubre tareas generalistas de redaccion, sintesis y consulta, mientras que Codex se orienta a generacion y asistencia de codigo para los equipos de desarrollo. La medida da acceso a capacidades de IA generativa dentro de los flujos de trabajo diarios de la plantilla, no como un experimento aislado sino como una herramienta de productividad disponible a gran escala.

    El movimiento tiene peso porque Samsung no es una startup de software: es un fabricante con divisiones de semiconductores, moviles, electrodomesticos y mas. Que una organizacion de ese tamano y complejidad despliegue la integracion de ChatGPT y Codex para empleados indica que la IA generativa ha dejado de ser una curiosidad para convertirse en infraestructura de trabajo. Conviene recordar que en 2023 Samsung llego a restringir el uso de ChatGPT internamente tras filtraciones de datos sensibles. El giro actual, hacia una adopcion controlada y oficial, refleja cuanto ha madurado el debate corporativo sobre estas herramientas en apenas un par de anos.

    Implicaciones tecnicas y de productividad

    La diferencia entre prohibir una herramienta y desplegarla oficialmente esta en el control. Un despliegue corporativo de la integracion de ChatGPT y Codex para empleados implica acuerdos sobre tratamiento de datos, separacion de la informacion confidencial respecto al entrenamiento de los modelos y politicas de uso claras. Para una empresa que maneja secretos industriales en chips y dispositivos, ese marco no es opcional: es la condicion que hace viable el proyecto.

    En el lado de desarrollo, Codex apunta a acelerar tareas repetitivas: generar funciones, documentar codigo, explicar fragmentos heredados o sugerir tests. No sustituye al ingeniero, pero recorta tiempo en trabajo de bajo valor anadido. ChatGPT, por su parte, cubre el resto de la organizacion: borradores, traducciones internas, resumenes de documentacion tecnica o consultas rapidas. El reto real no es tecnico sino de adopcion: que la plantilla aprenda a usar estas herramientas con criterio, sin delegar a ciegas y sin verter datos que no deben salir. Un despliegue masivo sin formacion suele generar mas ruido que productividad, y ahi es donde se juega el retorno de inversion.

    Que lecciones deja este caso para las empresas

    La leccion mas util del caso Samsung no es «adopta IA», sino el recorrido completo: de la prohibicion en 2023 al despliegue oficial controlado. Para una PYME, esto significa que el orden importa. Antes de dar acceso a ChatGPT o herramientas similares conviene definir tres cosas: que datos NO pueden introducirse, que version se contrata (las de pago empresarial no entrenan con tus datos por defecto) y que tareas concretas se quieren acelerar. La integracion de ChatGPT y Codex para empleados funciona cuando responde a un problema medible, no cuando se reparte el acceso «por si acaso».

    En lo practico: empieza por un departamento, mide horas ahorradas en tareas concretas durante un mes y solo entonces escala. Evita dar licencias sin formacion, porque el coste invisible es el mal uso. Y si trabajas con codigo o informacion sensible, exige por contrato la garantia de que tus datos no alimentan el entrenamiento del modelo. Esa clausula es lo que separa un despliegue serio de un riesgo legal.

    Analisis Blixel

    Lo interesante de este movimiento no es que una gigante use IA, sino el contraste con su propia historia reciente. Hace dos anos Samsung vetaba estas herramientas por miedo a filtraciones; hoy las reparte por toda la plantilla. Ese giro resume bien el momento que vive la IA corporativa: el debate ha pasado del «si» al «como», y el «como» se llama gobernanza de datos.

    Para las PYMEs espanolas hay una tentacion peligrosa: ver titulares asi y asumir que la jugada es repartir licencias cuanto antes. No lo es. Una multinacional con miles de ingenieros tiene equipos de seguridad, juristas y presupuesto para negociar condiciones a medida con OpenAI. Una empresa de veinte personas no juega en esa liga, pero tampoco lo necesita: le basta con una version empresarial bien configurada y reglas claras sobre que se puede y que no se puede pegar en el chat.

    El verdadero diferencial competitivo no sera tener acceso a Codex o a ChatGPT, porque pronto lo tendra todo el mundo. Sera quien construya el habito de usarlos con criterio, mida resultados reales y forme a su gente. La tecnologia se compra en cinco minutos; la cultura de uso productivo cuesta meses. Samsung lo aprendio por la via dura, prohibiendo primero y desplegando despues. Las empresas que empiecen ahora tienen la ventaja de saltarse el error inicial: no se trata de correr, sino de entrar ordenados.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • iOS 27 mete la IA en apps nativas sin pasar por Siri

    iOS 27 mete la IA en apps nativas sin pasar por Siri

    Las funciones de IA en iOS 27 no llegan envueltas en un asistente que pide ordenes, sino escondidas dentro de las apps que ya usas a diario. Apple ha presentado en su beta para desarrolladores un conjunto de herramientas que dividen una cuenta de restaurante con Apple Cash, actualizan contrasenas comprometidas sin que toques nada o crean atajos a partir de una descripcion en lenguaje natural. El enfoque es claro: resolver tareas concretas sin obligar al usuario a abrir un chatbot ni aprender comandos nuevos. El lanzamiento publico esta previsto para otono de 2026.

    Que ha presentado Apple y por que importa

    Apple ha mostrado en iOS 27 varias funciones de IA repartidas por sus aplicaciones nativas en lugar de concentrarlas en un unico asistente. Entre las novedades confirmadas estan la division automatica de cuentas de restaurante mediante Apple Cash, la actualizacion sin intervencion manual de contrasenas que se hayan visto comprometidas en filtraciones, y la creacion de atajos describiendo en lenguaje natural lo que se quiere conseguir. Todas ellas se activan dentro del flujo habitual del usuario, sin pedir que se invoque a Siri ni a ninguna otra interfaz conversacional.

    El movimiento encaja con una tendencia que se viene observando en el sector: la IA deja de ser un destino al que el usuario acude y pasa a ser una capa invisible que actua cuando hace falta. Apple lleva tiempo apostando por procesar tareas en el dispositivo y por integrar capacidades de forma discreta, frente a propuestas mas centradas en el chatbot como protagonista. Las funciones ya estan disponibles en la beta para desarrolladores y llegaran al publico general en otono de 2026 con el lanzamiento oficial de iOS 27.

    Implicaciones tecnicas de integrar la IA sin asistente

    El planteamiento de las funciones de IA en iOS 27 cambia el punto de friccion. En un modelo de asistente, el usuario tiene que saber que la funcion existe, formular bien la peticion y confiar en que el sistema interprete su intencion. Al incrustar la inteligencia directamente en la tarea (dividir una cuenta, cambiar una contrasena, montar un atajo), Apple elimina ese paso intermedio y reduce el margen de error en la interpretacion. La IA actua sobre un contexto acotado y conocido, no sobre una conversacion abierta.

    Esto tiene consecuencias practicas. La actualizacion automatica de contrasenas comprometidas, por ejemplo, convierte una tarea de seguridad que casi nadie hace a tiempo en algo que ocurre sin esfuerzo. La generacion de atajos por descripcion en lenguaje natural rebaja la barrera de entrada a la automatizacion, historicamente reservada a usuarios avanzados. El reto, como en cualquier funcion que actua de forma autonoma, sera la transparencia: que el usuario entienda que ha pasado, pueda revisarlo y revertirlo. Las funciones de IA en iOS 27 apuntan precisamente a ese equilibrio entre comodidad y control.

    Que lecciona esto a quien disena productos

    Aqui hay una idea aprovechable para cualquier empresa que construya software, no solo para fabricantes de moviles. La apuesta de las funciones de IA en iOS 27 demuestra que el valor no esta en tener un asistente vistoso, sino en colocar la inteligencia en el punto exacto donde el usuario tiene un problema. Una PYME que desarrolla una app de gestion no necesita un chatbot flotante: necesita que la IA rellene un campo previsible, detecte un dato incoherente o proponga la siguiente accion dentro del formulario que ya esta usando el cliente. La leccion concreta es priorizar tareas acotadas y repetitivas (conciliar un pago, avisar de una credencial debil, generar una automatizacion sencilla) frente a funciones conversacionales genericas que exigen al usuario aprender a pedirlas. Antes de anadir IA a un producto, conviene preguntarse donde se atasca realmente la gente y si una funcion silenciosa resolveria mas que un asistente. Esa diferencia separa una feature que se usa de una que se ignora.

    Analisis Blixel

    Durante un par de anos, la industria ha confundido adoptar IA con poner un cuadro de chat en cada pantalla. El resultado han sido decenas de asistentes que nadie abre dos veces, porque obligan al usuario a hacer el trabajo de explicar lo que quiere. Apple, que llego tarde y con prisas a la conversacion de la IA generativa, parece haber leido bien esa frustracion: lo interesante de esta tanda de novedades no es lo que la IA dice, sino lo que hace sin decir nada. Dividir una cuenta o cambiar una contrasena filtrada son tareas aburridas, y precisamente por eso valiosas cuando se automatizan bien.

    El riesgo evidente es el de la opacidad. Una funcion que actua sola sobre tu dinero o tus credenciales necesita un nivel de confianza que solo se gana con transparencia y reversibilidad impecables; si Apple falla ahi, la comodidad se volvera ansiedad. Y conviene no perder la perspectiva temporal: esto llega al publico en otono de 2026, lo que en este sector es una eternidad. Para las empresas espanolas, la moraleja es mas util que el calendario. No hace falta esperar a Apple ni montar un asistente propio para aplicar este principio. Identificar las tres tareas mas tediosas de vuestro producto y automatizarlas de forma discreta aporta mas valor real que cualquier integracion conversacional vistosa. La IA util suele ser la que no se nota.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • In the Weights mide tu rastro en los modelos de IA

    In the Weights mide tu rastro en los modelos de IA

    Medir tu presencia en los modelos de IA ya no es un ejercicio teorico. In the Weights, una web creada por dos ex-empleados de OpenAI, consulta directamente a GPT, Claude, Gemini y otros modelos para calcular como de bien recuerdan a una persona sin recurrir a busqueda web. El resultado es una puntuacion de «fuerza» que refleja cuanta informacion sobre alguien quedo grabada en los parametros del modelo durante su entrenamiento. La herramienta nace de una observacion concreta: cada vez mas gente pregunta a un chatbot quien eres antes que a Google.

    Que ha pasado y por que importa

    In the Weights mide la presencia en los modelos de IA de una persona interrogando a varios LLM sin permitirles buscar en internet. Es una distincion clave: en lugar de comprobar que dice la web sobre alguien, comprueba que recuerda el modelo por si mismo, es decir, que informacion quedo fijada en sus pesos durante el entrenamiento. A partir de esas respuestas asigna una puntuacion de fuerza que ordena a las personas consultadas en un ranking.

    Los datos publicados ilustran el funcionamiento. El actor Macaulay Culkin lidera actualmente la clasificacion con 988 puntos. El periodista Anthony Ha obtuvo 641, lo que le situa en el 6% superior de los nombres consultados. La herramienta consulta modelos de distintos proveedores —GPT, Claude, Gemini y otros— para que la nota no dependa de un unico sistema.

    El contexto que explica su aparicion es el desplazamiento del trafico desde el buscador tradicional hacia los chatbots. Si muchas personas ya obtienen informacion sobre otras preguntando a un LLM en vez de escribiendo en Google, lo que el modelo «sabe» de ti deja de ser una curiosidad y se convierte en una capa nueva de reputacion. In the Weights pone numero a algo que hasta ahora era invisible.

    Implicaciones tecnicas de medir tu presencia en los modelos de IA

    Lo interesante de medir la presencia en los modelos de IA sin busqueda web es que aisla el conocimiento parametrico. Un LLM aprende durante el entrenamiento y comprime una parte de esa informacion en sus pesos. Cuando se le pregunta por alguien sin darle acceso a internet, su respuesta solo puede venir de ahi. Por eso la puntuacion de fuerza es, en la practica, una estimacion de cuanta huella dejo una persona en los datos de entrenamiento de cada modelo.

    Esto tiene matices importantes. La memoria de un modelo no es estable: depende de la fecha de corte de sus datos, de cuanto material existia sobre esa persona y de como cada proveedor filtra y pondera la informacion. Por eso consultar varios modelos a la vez tiene sentido, ya que cada uno fue entrenado con corpus y criterios distintos.

    Tambien expone un problema conocido: las alucinaciones. Un modelo puede afirmar con seguridad datos incorrectos sobre una persona poco representada en su entrenamiento. Una puntuacion baja no solo significa anonimato, sino mayor riesgo de que el modelo invente detalles cuando alguien pregunte. Medir la presencia en los modelos de IA es, en el fondo, medir tambien donde es mas probable que la maquina se equivoque.

    Como pueden aplicar esto las empresas hoy

    Para una empresa, la utilidad inmediata de medir la presencia en los modelos de IA es de monitorizacion reputacional. Si tus clientes empiezan a preguntar a un chatbot por tu marca, tus directivos o tus productos antes de buscar en Google, conviene saber que responden esos modelos por defecto. Una herramienta como In the Weights sirve para una primera foto: comprobar si los LLM tienen informacion correcta, desactualizada o directamente inexistente sobre las personas y nombres clave del negocio.

    El siguiente paso es accionable y no requiere inversion alta: asegurarse de que existe informacion publica, clara y verificable sobre la empresa en fuentes que los modelos suelen ingerir. No se trata de «hackear» el ranking, sino de reducir el riesgo de que un modelo invente datos por falta de material fiable. Lo que conviene evitar es tratar la puntuacion como una metrica de exito: una nota alta no equivale a buena reputacion, solo a mayor cantidad de datos memorizados, que pueden ser erroneos. Para una PYME, el ROI realista esta en detectar errores graves —confusiones de identidad, datos falsos— antes de que un cliente los reciba de un chatbot.

    Analisis Blixel

    Conviene separar lo util de lo anecdotico. El ranking de famosos, con Culkin a la cabeza, es el gancho mediatico, pero lo verdaderamente relevante es la idea de fondo: el conocimiento que un modelo guarda sobre alguien empieza a funcionar como una reputacion paralela, fuera de tu control y dificil de auditar. Eso si merece atencion de cualquier empresa que dependa de su imagen.

    Dicho esto, no hay que sobredimensionar la herramienta. Una puntuacion de fuerza es una metrica indirecta y opaca: no sabemos exactamente como se calcula, los modelos cambian con cada version y la nota puede subir o bajar sin que nadie haga nada. Tratar ese numero como un KPI seria un error clasico de confundir lo medible con lo importante. Su valor real es diagnostico, no operativo.

    El riesgo de fondo no es quedar bajo en un ranking, sino que un modelo afirme cosas falsas con tono de certeza sobre tu marca o tus directivos. Ahi es donde una empresa debe poner el foco: verificar que dicen los LLM y corregir errores en las fuentes que esos modelos consumen. La aparicion de utilidades como esta confirma una tendencia que ya no es opinable: parte de la conversacion sobre quien eres ocurre dentro de un chatbot, y conviene saber que se esta diciendo.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • SageMaker estrena 100 metricas para vigilar tu LLM

    SageMaker estrena 100 metricas para vigilar tu LLM

    Las nuevas metricas de inferencia en SageMaker ponen sobre la mesa algo que muchos equipos de MLOps llevaban tiempo pidiendo: visibilidad real de lo que pasa dentro de un endpoint de IA generativa. Amazon SageMaker AI ahora emite mas de 100 metricas detalladas que cubren salud de GPU, latencia por token, presion de cache KV, distribucion de trafico entre zonas de disponibilidad y diagnosticos de arranque en frio. Todo fluye automaticamente a un dashboard integrado en CloudWatch. Para quien gestiona modelos en produccion, esto cambia la forma de diagnosticar problemas.

    Que ha pasado y por que importa

    Amazon SageMaker AI ha incorporado mas de 100 metricas detalladas de inferencia orientadas especificamente a cargas de IA generativa. Hasta ahora, monitorizar un endpoint LLM se limitaba en gran medida a indicadores genericos como uso de CPU, memoria o latencia media, que dicen poco cuando el problema esta en la cola de tokens o en la cache. Las nuevas metricas de inferencia en SageMaker cubren la salud de la GPU, la latencia por token, la presion de la cache KV, como se reparte el trafico entre zonas de disponibilidad y los diagnosticos de arranque en frio.

    Estas senales se dirigen a equipos de MLOps y SRE que necesitan encontrar la causa raiz cuando la latencia P99 de un endpoint se dispara. Las metricas llegan de forma automatica a un dashboard integrado, SageMaker Insights, dentro de CloudWatch, que soporta consultas PromQL. La funcion viene activada por defecto en los endpoints nuevos, mientras que los endpoints existentes requieren un opt-in explicito para empezar a emitir estos datos.

    Implicaciones tecnicas de las nuevas metricas de inferencia en SageMaker

    El valor de las metricas de inferencia en SageMaker esta en el nivel de detalle. La latencia por token permite distinguir si la lentitud viene del tiempo hasta el primer token o de la generacion sostenida, dos problemas con causas y soluciones distintas. La presion de la cache KV es clave en modelos con contexto largo: cuando se llena, el rendimiento cae y antes era casi invisible sin instrumentacion propia. Los diagnosticos de arranque en frio ayudan a entender los picos de latencia tras un escalado o un despliegue.

    El soporte de PromQL es relevante para quien ya trabaja con stacks de observabilidad basados en Prometheus. Permite reutilizar logica de consulta conocida sin reaprender un lenguaje propietario, y facilita alertas mas finas sobre la latencia P99 en lugar de promedios que esconden la cola de peticiones lentas. Al fluir a CloudWatch, las metricas conviven con el resto de telemetria de AWS, lo que reduce el numero de paneles que un SRE tiene que vigilar. La activacion por defecto en endpoints nuevos baja la barrera de entrada, aunque el opt-in en los existentes obliga a una revision manual de la flota ya desplegada.

    Como pueden aplicar esto las empresas hoy

    Si ya tienes endpoints LLM en SageMaker, el primer paso es activar el opt-in en los existentes y no asumir que estan cubiertos: solo los nuevos vienen instrumentados por defecto. A partir de ahi, define alertas sobre latencia P99 y presion de cache KV, no sobre medias, porque la experiencia del usuario la marca la cola lenta. Quien gestione contexto largo deberia vigilar de cerca la cache KV antes de escalar hardware: a veces el problema es de gestion de memoria, no de falta de GPU.

    En cuanto a ROI, el ahorro no esta en la funcion en si, que es gratuita salvo el coste de CloudWatch, sino en evitar sobreaprovisionar GPU por miedo a no saber donde esta el cuello de botella. Las metricas de inferencia en SageMaker permiten dimensionar con datos. Que evitar: crear decenas de alertas sin umbral pensado, porque generan ruido y fatiga de avisos. Empieza por tres o cuatro indicadores criticos (latencia por token, P99, cache KV y arranque en frio) y amplia segun lo que tu trafico real demuestre que importa.

    Analisis Blixel

    Durante mucho tiempo, poner un modelo generativo en produccion se ha parecido a conducir de noche sin faros: funcionaba hasta que dejaba de hacerlo, y entonces nadie sabia por que. La observabilidad especifica para inferencia LLM era el eslabon que faltaba entre los demos brillantes y las cargas reales que tienen que cumplir un SLA. Que un proveedor cloud asuma de serie metricas como la presion de la cache KV o la latencia por token reconoce algo que la industria llevaba meses descubriendo a base de incidentes.

    Para una PYME espanola que apenas tiene un equipo reducido de plataforma, esto importa mas de lo que parece. No por la moda de la observabilidad, sino porque reduce el tiempo de diagnostico cuando algo se rompe a las tres de la tarde y la atencion al cliente depende de un endpoint. El soporte de PromQL es un acierto pragmatico: respeta lo que la gente ya sabe hacer en lugar de imponer otra herramienta mas.

    El matiz a vigilar es el opt-in en endpoints existentes. Es facil leer el titular, asumir que todo queda cubierto y descubrir en el peor momento que la flota antigua sigue a ciegas. Conviene tratar esta novedad como una tarea de mantenimiento concreta, no como un interruptor magico. Bien aprovechada, esta instrumentacion convierte el debugging de modelos de un arte adivinatorio en un trabajo de ingenieria con datos encima de la mesa. Y eso, a la larga, es lo que separa los pilotos eternos de los sistemas que de verdad llegan a produccion.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Karamo lanza Ke, app de bienestar con su clon de IA

    Karamo lanza Ke, app de bienestar con su clon de IA

    El clon digital de IA de Karamo Brown ya tiene casa propia. El coach de vida de ‘Queer Eye’ ha lanzado Ke, una app de bienestar que permite conversar en tiempo real con una version digital del presentador, construida con tecnologia de Delphi. La aplicacion suma planes de fitness, guias nutricionales, meditacion y una seccion comunitaria, y se mueve en un mercado cada vez mas saturado: el de las apps de bienestar potenciadas por IA. Cuesta 14,99 dolares al mes tras una prueba gratuita de tres dias y esta disponible en iOS y Android.

    Que ha lanzado Karamo Brown y por que llama la atencion

    Ke es una app de bienestar que gira en torno a un clon digital de IA del propio Karamo Brown. La pieza central es ese avatar conversacional, creado con la plataforma Delphi, que responde a los usuarios como si fuera el presentador. Alrededor de esa funcion se articula el resto del producto: planes de fitness personalizados, guias de nutricion, contenido de meditacion y un espacio comunitario para los suscriptores. El modelo de negocio es una suscripcion de 14,99 dolares mensuales, precedida por una prueba gratuita de tres dias, y esta disponible tanto en iOS como en Android.

    El movimiento no es aislado. Las celebridades y creadores llevan meses experimentando con avatares de IA que reproducen su voz, su estilo y su forma de aconsejar. La promesa es escalar la presencia de una figura publica sin que esa persona tenga que estar presente. En el caso de Karamo, conocido precisamente por su faceta de coach emocional en television, el encaje entre figura publica y app de bienestar resulta evidente: el clon digital de IA es la extension natural de un personaje cuyo valor de marca ya es dar consejos.

    Implicaciones tecnicas y de mercado de un clon conversacional

    Tecnicamente, un clon digital de IA como el de Ke es un modelo de lenguaje afinado para imitar la voz, el tono y el conocimiento de una persona concreta. Plataformas como Delphi se encargan de empaquetar ese proceso: ingieren material del creador, ajustan el comportamiento del modelo y exponen una interfaz de chat. El resultado no es Karamo Brown, sino una representacion estadistica de como hablaria. Esa distincion importa, porque marca los limites de lo que un avatar puede ofrecer en un terreno tan sensible como el bienestar.

    En el plano de mercado, el sector de apps de bienestar con IA esta abarrotado y la diferenciacion es dificil. Calm, Headspace y decenas de competidores compiten por la misma atencion y el mismo gasto recurrente. Lo que aporta Ke no es la tecnologia, que esta disponible para cualquiera via Delphi, sino la marca personal de Karamo. Ese es el activo real. El precio de 14,99 dolares al mes lo situa en la franja media-alta del segmento, lo que obliga a justificar un valor que va mas alla de la novedad de hablar con un clon digital de IA durante los primeros dias.

    La leccion para empresas y creadores que miran los avatares de IA

    Aqui hay una leccion concreta y no obvia. El clon digital de IA de Karamo funciona como caso de estudio para cualquier marca o creador que se plantee monetizar un avatar: la tecnologia se ha vuelto accesible y barata, pero por si sola no sostiene una suscripcion recurrente. Lo que retiene a un usuario es el ecosistema alrededor (planes de fitness, nutricion, comunidad) y, sobre todo, una marca con autoridad previa. Para una PYME que considere ofrecer un asistente con la ‘voz’ de su fundador o de un experto interno, el orden importa: primero la propuesta de valor y los contenidos, despues el avatar como capa de interaccion. Lanzar un clon conversacional sin nada solido detras genera curiosidad de tres dias y cancelaciones al cuarto. Conviene tambien ser transparente sobre que el interlocutor es una IA y no la persona real, especialmente si se dan consejos de salud o emocionales, donde un error de tono tiene consecuencias reputacionales.

    Analisis Blixel

    Que una figura televisiva venda consejos a traves de un avatar dice mas del estado del mercado que de la tecnologia en si. Construir un chatbot que imite a alguien ya no es el reto: lo dificil es que la gente pague 14,99 dolares al mes mes tras mes por hablar con una version sintetica de un presentador. El riesgo evidente es la confusion sobre quien aconseja. En un terreno como el bienestar, donde se mezclan emociones, habitos y a veces salud, delegar el acompanamiento en un modelo de lenguaje afinado plantea preguntas que la app deberia responder con claridad: que pasa cuando el avatar se equivoca, que datos guarda y donde estan los limites del consejo automatizado. Para creadores y marcas, el caso es util precisamente porque desnuda el truco: la tecnologia es commodity, la marca es el producto. Quien tenga audiencia y autoridad puede empaquetar un avatar y cobrar por el; quien no, tendra una funcion vistosa que nadie usa pasada la prueba gratuita. La pregunta honesta para cualquier empresa espanola que mire esto no es ‘puedo clonar a alguien’, porque la respuesta ya es si, sino ‘aporta algo que justifique pagar todos los meses’. Si la respuesta no es contundente, el avatar es marketing, no producto.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • La CLI de Bright Data lleva el scraping a la terminal

    La CLI de Bright Data lleva el scraping a la terminal

    La Bright Data CLI para gestionar scraping aterriza como una interfaz de linea de comandos unificada para controlar toda la infraestructura de Bright Data sin salir de la terminal. La herramienta agrupa proxies residenciales, de centros de datos y otros recursos bajo un mismo flujo de comandos, con autenticacion, gestion de zonas y monitoreo de uso. Se instala via npm y esta pensada para encajar en pipelines de CI/CD. Para los equipos que ya dependen de scraping a escala, supone cambiar la consola web por scripts reproducibles y versionables.

    Que ha pasado y por que importa

    El repositorio describe la Bright Data CLI como una capa de orquestacion para todos los productos de la plataforma. Desde un unico binario puedes autenticarte, crear y ejecutar colecciones de proxies residenciales y de centros de datos, configurar reglas de uso y activar el monitoreo. Tambien expone comandos para gestionar recursos como redes, usuarios y zonas, ademas de lanzar tareas de scraping o automatizacion sobre la infraestructura existente. La documentacion incluye ejemplos de uso, instalacion via npm y notas sobre variables de entorno para integrarla en flujos de desarrollo.

    La razon por la que la Bright Data CLI para gestionar scraping resulta relevante es practica: hasta ahora gran parte de esta configuracion vivia en una interfaz web, dificil de versionar y de automatizar. Trasladar la gestion de proxies y zonas a comandos permite tratar la infraestructura como codigo, registrar cambios en control de versiones y reproducir entornos. Para equipos que extraen datos de forma recurrente, esa trazabilidad reduce el numero de configuraciones manuales que se rompen sin que nadie sepa por que.

    Implicaciones tecnicas para tus flujos de trabajo

    La instalacion via npm coloca la herramienta en el mismo terreno que el resto del tooling JavaScript que ya usan muchos equipos. Eso facilita anadirla a un paso de pipeline sin instalar dependencias exoticas. El uso de variables de entorno para autenticacion y configuracion es el patron esperado en CI/CD: las credenciales no quedan escritas en el repositorio y cada entorno (local, staging, produccion) puede apuntar a zonas o proyectos distintos cambiando una variable. La Bright Data CLI para gestionar scraping actua como capa de orquestacion, lo que significa que otros scripts y herramientas externas pueden invocarla en lugar de hablar directamente con la API.

    El planteamiento tiene matices. Una CLI de orquestacion anade una capa mas entre tu codigo y la infraestructura, asi que conviene entender que abstrae y que no. Para tareas puntuales, llamar a la API directamente puede seguir siendo mas simple. La ventaja aparece cuando hay muchas zonas, reglas y colecciones que mantener coordinadas: ahi el control desde la terminal evita el clasico desfase entre lo que esta configurado y lo que el equipo cree que esta configurado. El monitoreo de uso integrado tambien ayuda a vigilar el consumo, un factor de coste nada menor en scraping a escala.

    Como pueden aplicar esto las empresas hoy

    Si tu empresa ya consume servicios de proxy o scraping de forma habitual, el primer paso es identificar que configuraciones se gestionan hoy a mano y cuales podrian convertirse en comandos versionados. Empieza por un entorno de pruebas: instala la CLI via npm, configura las variables de entorno con credenciales de un proyecto de bajo riesgo y reproduce una coleccion existente desde la terminal. Si el resultado coincide con lo que tenias en la web, ya tienes una base para automatizar. A partir de ahi, evalua integrar uno o dos comandos en tu pipeline de CI/CD, por ejemplo para provisionar una zona antes de un job de extraccion.

    Sobre el ROI: la ganancia no esta en el scraping en si, sino en reducir errores de configuracion y tiempo de mantenimiento. Mide cuantas incidencias actuales vienen de cambios manuales mal documentados. Que evitar: migrar todo de golpe ni meter credenciales en el repositorio. Y antes de comprometerte, comprueba que los limites legales de extraccion de datos que apliquen a tu sector estan claros, porque ninguna CLI los resuelve por ti.

    Analisis Blixel

    Tratar la infraestructura como codigo dejo de ser una moda hace anos: es la forma sensata de evitar que un cambio invisible tumbe un proceso critico. Que un proveedor de proxies traslade su gestion a una linea de comandos versionable encaja en esa logica y, francamente, llega tarde mas que pronto. La utilidad real aqui no es poder hacer scraping (eso ya se podia), sino poder reproducirlo y auditarlo. Para un equipo de datos, la diferencia entre una configuracion clicada en una web y un script en el repositorio es la diferencia entre rezar y saber. Dicho esto, conviene no idealizar: una capa de orquestacion solo aporta si el volumen lo justifica. Para una PYME que lanza una extraccion ocasional al mes, montar todo esto en CI/CD es sobreingenieria; le bastara la interfaz web o un par de llamadas a la API. El punto de inflexion aparece cuando hay varias zonas, varios entornos y varias personas tocando lo mismo. Tambien pesa el factor coste: el monitoreo de uso integrado es bienvenido, porque el scraping a escala se descontrola en factura con facilidad. Y queda el elefante en la habitacion, que ninguna herramienta tecnica resuelve: la legalidad de extraer datos de terceros depende de jurisdiccion, terminos de servicio y tipo de dato. Automatizar mal y rapido solo significa equivocarse mas deprisa.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • La mitad de los solteros de EE UU rechaza la IA en citas

    La mitad de los solteros de EE UU rechaza la IA en citas

    El rechazo a la IA en aplicaciones de citas ya no es una intuicion: tiene cifras. Match Group, propietaria de Tinder, Hinge y OkCupid entre otras, ha hecho publico que cerca del 50% de los solteros estadounidenses tiene una percepcion negativa sobre el uso de inteligencia artificial en estas plataformas. El dato llega justo cuando el sector apuesta por funciones automaticas para mejorar emparejamientos y conversaciones. La paradoja es evidente: las empresas invierten en IA mientras la mitad de su publico desconfia de ella. Conviene entender por que.

    Que ha pasado y por que importa

    Match Group ha compartido los resultados de un estudio segun el cual aproximadamente la mitad de los solteros en Estados Unidos ve con malos ojos la implementacion de inteligencia artificial en las plataformas de citas. El estudio recoge la opinion de los usuarios sobre como la IA podria afectar a la autenticidad de las interacciones romanticas digitales, un terreno donde la confianza es el activo central del producto. El rechazo a la IA en aplicaciones de citas se convierte asi en una barrera medible para una compania que lleva meses incorporando estas funciones.

    El contexto explica la tension. Las grandes apps de citas han presentado herramientas que sugieren mensajes, optimizan perfiles y refinan el algoritmo de emparejamiento. Sobre el papel, todo esto reduce friccion y promete mejores resultados. Pero en una categoria donde el usuario busca conexiones humanas reales, la percepcion de artificialidad puede pesar mas que la mejora funcional. El dato de Match Group no mide la calidad de la tecnologia, sino la disposicion del publico a aceptarla, y ese es un problema distinto y mas dificil de resolver con codigo.

    Implicaciones de mercado y de producto

    Para Match Group, el rechazo a la IA en aplicaciones de citas plantea un dilema de producto clasico: la funcion que mejora las metricas internas puede erosionar la confianza que sostiene el negocio. Si la mitad de la base percibe que la IA contamina la autenticidad, cualquier despliegue agresivo arriesga retencion y reputacion. No es un detalle menor en un sector donde el boca a boca y la percepcion de seguridad determinan las descargas.

    El matiz importante es que la desconfianza no equivale a un veto absoluto. Un usuario puede rechazar que la IA escriba sus mensajes y a la vez aceptar que filtre perfiles falsos o detecte comportamientos abusivos. La diferencia esta en donde se aplica: la IA que ayuda en segundo plano genera menos resistencia que la que se mete en la conversacion intima. Para el sector, la leccion estrategica es de posicionamiento. La inteligencia artificial vendida como herramienta de moderacion y seguridad encaja con las expectativas; vendida como sustituto del esfuerzo humano en el cortejo, choca con ellas. El reto no es tecnico, es de encaje entre la funcion y el contrato implicito que el usuario tiene con la plataforma.

    La leccion para empresas que despliegan IA de cara al cliente

    Aqui hay un aprendizaje concreto y no obvio para cualquier PYME que este metiendo IA en su producto o atencion al cliente. El dato de Match Group demuestra que la aceptacion de una funcion de IA depende menos de su calidad tecnica que de donde se coloca dentro de la experiencia. Automatizar tareas de fondo (filtrar spam, detectar fraude, priorizar tickets) genera poca friccion. Automatizar la parte donde el cliente espera trato humano (una conversacion personal, una recomendacion sensible, una disculpa) puede salir caro en confianza.

    La accion practica: antes de desplegar una funcion de IA, pregunta a tu base si la quiere y donde. Un sondeo sencillo evita lanzar algo que el cliente percibe como deshumanizador. Segunda recomendacion: se transparente sobre cuando interviene la IA y deja siempre una salida humana visible. Y tercera, mide la retencion y la satisfaccion antes y despues, no solo las metricas de eficiencia interna. Una funcion puede subir la productividad y bajar la confianza al mismo tiempo, y solo lo veras si miras ambas cosas. Lo que para Match Group es un estudio de mercado, para una PYME deberia ser un checklist previo a cualquier integracion visible.

    Analisis Blixel

    Hay una trampa habitual en la adopcion de IA: confundir lo que es tecnicamente posible con lo que el usuario realmente quiere. El caso de las apps de citas lo expone con crudeza. Una funcion que escribe mensajes mas atractivos o que optimiza el emparejamiento puede ser brillante en el laboratorio y un fracaso en el mercado, porque la gente que busca pareja no quiere delegar la parte humana del proceso. La eficiencia no es el unico valor en juego; en muchos productos, la percepcion de autenticidad lo es todo.

    Esto conecta con un patron que vemos en empresas de cualquier tamano. Se despliega un chatbot, un autorrespondedor o un recomendador automatico porque la tecnologia esta disponible y abarata costes, sin preguntar si el cliente lo va a tolerar en ese punto concreto. El resultado suele ser una mejora de metricas internas acompanada de un deterioro silencioso de la relacion con el usuario, que tarda en notarse pero acaba pesando. La IA aplicada con criterio empieza por entender donde el cliente acepta ayuda y donde la rechaza.

    La lectura util no es que la IA sea un problema en productos sensibles, sino que su valor depende del contexto. En moderacion, seguridad y tareas repetitivas tiene recorrido claro. En la zona donde el cliente espera trato humano, conviene pisar con cuidado y medir antes de escalar. El dato de Match Group no es un argumento contra la IA, es un recordatorio de que la tecnologia tiene que servir a la experiencia, no al reves.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • ChatGPT mejora su inteligencia de salud y citas medicas

    ChatGPT mejora su inteligencia de salud y citas medicas

    La inteligencia de salud en ChatGPT recibe un paquete de mejoras orientadas a dar respuestas medicas mas precisas y trazables. Los cambios afectan a tres frentes: mejor comprension de terminologia clinica, referencias a fuentes cientificas verificadas y avisos explicitos que recuerdan al usuario la necesidad de acudir a un profesional. Para desarrolladores y empresas del sector sanitario, la actualizacion abre la puerta a integrar estas capacidades en plataformas de atencion al cliente y herramientas de informacion medica, con la cautela que exige cualquier contenido relacionado con la salud.

    Que ha cambiado y por que importa

    OpenAI ha reforzado la inteligencia de salud en ChatGPT en tres ejes concretos. El primero es una mejor comprension de la terminologia medica, lo que reduce malentendidos cuando el usuario describe sintomas, farmacos o procedimientos con lenguaje tecnico o coloquial. El segundo es la incorporacion de referencias a fuentes cientificas verificadas, de modo que las respuestas no se queden en afirmaciones sueltas sino que apunten a evidencia contrastable. El tercero son las advertencias apropiadas: el modelo recuerda de forma sistematica que su salida no sustituye el criterio de un profesional sanitario.

    El contexto explica el enfasis. Los modelos de lenguaje generativo han sido criticados por ofrecer informacion medica plausible pero incorrecta, sin distinguir entre divulgacion y consejo clinico. En un terreno donde un error puede tener consecuencias reales, la trazabilidad de las fuentes y los avisos de seguridad no son adornos: son requisitos minimos. Estas mejoras buscan precisamente acotar el riesgo y elevar la fiabilidad percibida de la informacion medica generada por IA.

    Implicaciones tecnicas para desarrolladores

    Para quien construye sobre la API, la mejora en la inteligencia de salud en ChatGPT cambia el punto de partida. Una mejor comprension de la terminologia medica significa menos preprocesamiento y normalizacion manual de entradas, y respuestas mas consistentes ante variantes lexicas del mismo concepto. Las referencias a fuentes verificadas facilitan auditar las salidas y mostrar al usuario final de donde procede una afirmacion, algo clave para cumplir requisitos de transparencia.

    Las advertencias integradas tambien tienen lectura tecnica: reducen la necesidad de envolver cada respuesta en disclaimers propios, aunque no eximen al desarrollador de su responsabilidad. La informacion medica sigue siendo una categoria sensible y ninguna mejora del modelo convierte a ChatGPT en un dispositivo medico. El diseno de producto debe asumir que el sistema asiste, no diagnostica, y que la validacion humana sigue siendo obligatoria en cualquier flujo que toque decisiones clinicas.

    Como pueden aplicar esto las empresas hoy

    Las empresas del sector sanitario pueden integrar la inteligencia de salud en ChatGPT en casos de uso de bajo riesgo y alto volumen: triaje informativo, resolucion de dudas frecuentes sobre tratamientos, explicacion de terminologia medica a pacientes o soporte a equipos de atencion al cliente. El ROI es mas claro cuando la IA descarga consultas repetitivas y deja el criterio clinico al personal cualificado. Antes de desplegar, conviene definir limites: que preguntas puede responder el sistema y cuales derivan siempre a un profesional. Hay que evitar dos errores. El primero, presentar la informacion medica generada como diagnostico o consejo personalizado, lo que ademas puede tener implicaciones regulatorias. El segundo, integrar la capacidad sin un proceso de revision ni registro de las fuentes citadas. Recomendamos pilotar con un perimetro estrecho, medir tasa de derivacion a humanos y solo despues ampliar. Las advertencias del modelo ayudan, pero la responsabilidad legal sobre la informacion medica que ofrece una empresa sigue siendo de la empresa, no del proveedor del modelo.

    Analisis Blixel

    Citar fuentes y avisar de que hay que ver a un medico es lo minimo exigible, no un logro extraordinario. La direccion es correcta, pero conviene leerla sin entusiasmo automatico. Que un modelo comprenda mejor la terminologia clinica y apunte a evidencia verificable reduce el riesgo de respuestas confiadas y erroneas, que es el problema real en salud. Aun asi, la mejora no cambia la naturaleza de la herramienta: sigue siendo un asistente conversacional, no un sistema validado clinicamente, y tratarlo como otra cosa es donde empiezan los problemas. Para las empresas sanitarias espanolas la oportunidad es genuina en tareas informativas y de soporte, pero el marco regulatorio europeo sobre datos de salud y dispositivos medicos no se relaja porque el modelo cite papers. La trazabilidad de fuentes es util justamente porque permite auditar, y ahi esta la clave: usarla para verificar, no para delegar. Quien integre esta capacidad sin un proceso humano de revision esta trasladando un riesgo, no eliminandolo. El consejo practico es sencillo: empezar por casos de bajo riesgo, medir cuanto deriva el sistema a profesionales y vigilar que las fuentes citadas sean realmente pertinentes. La informacion medica fiable se construye con procesos, no solo con mejores modelos. Esta actualizacion mejora la materia prima; el resto depende de como la empresa la cocine.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Por que no deberias casarte con un solo LLM

    Por que no deberias casarte con un solo LLM

    La estrategia multi-modelo con LLM parte de una idea simple: estandarizar toda tu operacion en un unico modelo de lenguaje es tan poco eficiente como que cada comensal pida su propio plato en lugar de compartir la comida. La comparacion del estilo familiar resume bien el argumento. Distintos modelos destacan en tareas distintas (razonamiento, creatividad, codigo, velocidad o coste), y combinarlos en lugar de elegir uno solo mejora la calidad de las respuestas, abarata el gasto y reduce el riesgo de quedarte atado a un solo proveedor.

    Que propone el enfoque y por que importa

    El planteamiento es directo: en lugar de apostar todo a un unico LLM, orquestar varios modelos especializados de proveedores diferentes y asignar cada tarea al que mejor la resuelve. La metafora del banquete frente al plato individual ilustra el cambio de mentalidad. Un modelo puede ser fuerte en razonamiento estructurado, otro en generacion creativa, otro en codigo y otro simplemente mas rapido o mas barato para tareas de alto volumen. Forzar todo a traves de uno solo deja valor sobre la mesa.

    Aqui es donde entra OpenRouter, que actua como capa de coordinacion. Ofrece una API unificada para acceder a modelos de varios proveedores, ruteo inteligente entre ellos y herramientas para experimentar y comparar resultados sin reescribir la integracion cada vez. La estrategia multi-modelo con LLM deja de ser un ejercicio teorico y se vuelve operativa: un solo punto de entrada que decide, segun la tarea, a que modelo enviar cada peticion. El mensaje de fondo es que el futuro practico de la IA en empresas y productos no pasa por un ganador unico, sino por la combinacion.

    Implicaciones tecnicas de orquestar varios modelos

    Trabajar con una estrategia multi-modelo con LLM cambia la arquitectura de tu aplicacion. En lugar de acoplar tu codigo a un SDK concreto, la API unificada de OpenRouter te da una interfaz comun y te permite cambiar de modelo con una variable de configuracion. Esto tiene tres consecuencias practicas. La primera es resiliencia: si un proveedor sufre una caida o degrada su servicio, el ruteo puede redirigir el trafico a una alternativa sin parar la operacion. La segunda es control de coste: puedes mandar las tareas triviales a un modelo economico y reservar los modelos premium para lo que de verdad lo necesita.

    La tercera consecuencia es la capacidad de medir. Comparar modelos sobre tus propias tareas, con tus propios datos, deja de depender de benchmarks genericos que rara vez reflejan tu caso de uso real. El coste de este enfoque es la complejidad anadida: hay que definir reglas de ruteo, vigilar la coherencia de salidas entre modelos distintos y gestionar el hecho de que cada uno tiene su propio comportamiento, formato y limites de contexto. La capa unificada simplifica la integracion, pero no elimina la necesidad de diseno. Orquestar varios modelos especializados es una decision de ingenieria, no un interruptor magico.

    Como pueden aplicar esto las empresas hoy

    El primer paso es nada glamuroso: inventariar tus tareas de IA y clasificarlas. No todas necesitan el modelo mas caro. Clasificacion de tickets, resumenes internos o extraccion de datos suelen funcionar bien con modelos rapidos y baratos; el razonamiento complejo o la generacion de codigo critico justifican modelos premium. Con ese mapa, una API unificada como OpenRouter te permite probar la estrategia multi-modelo con LLM sin comprometer la arquitectura desde el primer dia. Empieza con dos modelos y una regla de ruteo simple antes de complicar nada.

    Para evaluar el ROI, mide tres cosas sobre tus casos reales: coste por peticion, calidad de salida y latencia. Si el ahorro de derivar el 70% del trafico a un modelo economico no degrada la calidad percibida, el caso esta hecho. Que evitar: montar reglas de ruteo barrocas antes de tener datos, asumir que un modelo nuevo es mejor sin medirlo, y olvidar que cada proveedor cambia precios y modelos con frecuencia. La ventaja de no casarte con un unico LLM es precisamente esa flexibilidad; usala con disciplina, no como excusa para no decidir.

    Analisis Blixel

    Atarse a un solo proveedor fue durante un tiempo la opcion comoda: una factura, una documentacion, un equipo que dominaba una herramienta. Pero ese confort se paga en dependencia. Cuando el proveedor sube precios, cambia las condiciones o degrada un modelo, te quedas sin margen de maniobra. La logica de combinar modelos especializados no es una moda, es una respuesta sensata a un mercado donde el liderazgo tecnico cambia cada pocos meses y ningun modelo gana en todo a la vez.

    Dicho esto, conviene no idealizar el enfoque. La capa de orquestacion anade puntos de fallo, complejidad de mantenimiento y una curva de aprendizaje que las PYMEs con equipos pequenos deben calcular antes de lanzarse. La estrategia multi-modelo con LLM tiene sentido cuando el volumen y la diversidad de tareas justifican el esfuerzo; para un caso de uso unico y estable, un solo modelo bien elegido sigue siendo perfectamente valido. La metafora del banquete es buena, pero un banquete tambien requiere mas vajilla que un plato individual.

    Nuestra recomendacion es pragmatica: trata la portabilidad como un seguro. Aunque hoy uses un solo modelo, integrar a traves de una API unificada te cuesta poco y te ahorra un dolor de cabeza el dia que necesites cambiar. La flexibilidad arquitectonica es barata si la diseñas desde el principio y carisima si la dejas para despues.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Snap apuesta por unas gafas de RA de 2.195 dolares

    Snap apuesta por unas gafas de RA de 2.195 dolares

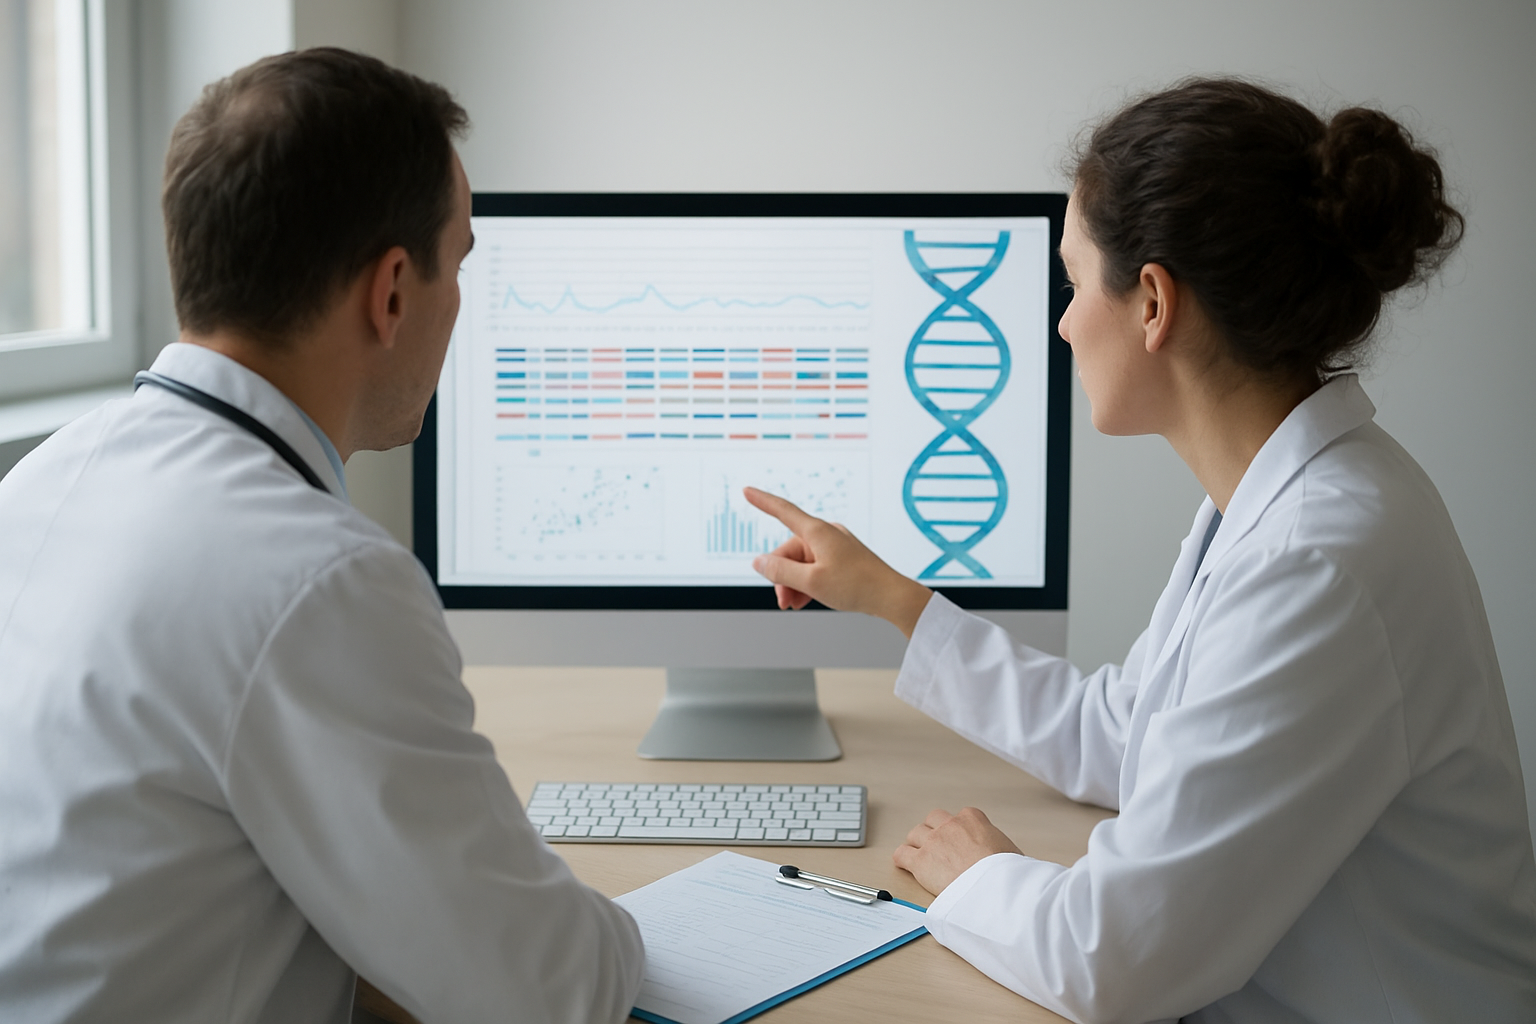
    Las nuevas gafas de realidad aumentada de Snap llegan con un precio de 2.195 dolares y suponen el ultimo movimiento de la compania conocida por Snapchat para hacerse un hueco en un segmento dominado hasta ahora por gigantes con mucho mas musculo financiero. La cifra no es accidental: situa el producto fuera del consumo masivo y dentro de un territorio de uso profesional, creativo y de desarrollo. Conviene mirar con calma que ha anunciado realmente Snap, a quien va dirigido y por que un precio asi no es necesariamente un error de calculo.

    Que ha presentado Snap y por que importa

    Snap ha presentado oficialmente sus nuevas gafas de realidad aumentada con un precio de 2.195 dolares, segun la propia compania. Se trata del ultimo impulso de la empresa de redes sociales en un segmento al que lleva anos acercandose con sus dispositivos Spectacles. A diferencia de otros wearables centrados en grabar video o reproducir audio, la propuesta de Snap se enmarca en las gafas de realidad aumentada, es decir, dispositivos que superponen elementos digitales sobre el campo de vision del usuario.

    El contexto es relevante. Las gafas de realidad aumentada llevan mas de una decada prometiendo ser el sucesor del smartphone sin terminar de cuajar en el mercado de consumo. Snap no es nueva en esto: ha lanzado varias generaciones de Spectacles con resultados desiguales. El precio de 2.195 dolares deja claro que esta version no busca competir por volumen, sino posicionarse como herramienta para desarrolladores y creadores que quieran experimentar con experiencias de realidad aumentada antes de que la tecnologia llegue a un punto de precio asumible para el gran publico.

    Implicaciones para un mercado todavia inmaduro

    El movimiento de Snap se produce en un momento en el que las gafas de realidad aumentada concentran de nuevo la atencion del sector hardware, con varias companias grandes apostando por formatos mas ligeros y asequibles enfocados en audio y camara. Frente a esa via, Snap insiste en la realidad aumentada completa, lo que la coloca en una posicion mas ambiciosa pero tambien mas arriesgada tecnicamente.

    Un precio de 2.195 dolares cumple una funcion estrategica clara: financia parcialmente el coste de un hardware caro de fabricar y, al mismo tiempo, filtra al publico hacia perfiles dispuestos a tolerar limitaciones a cambio de acceso temprano. Para Snap, cuyo negocio principal sigue siendo la publicidad en Snapchat, el hardware de realidad aumentada funciona como una apuesta a largo plazo y como manera de no quedar fuera de la plataforma que podria suceder al movil. El reto es que la autonomia, el peso, el campo de vision y el catalogo de aplicaciones siguen siendo los puntos debiles historicos de estas gafas, y ningun precio resuelve esos problemas por si solo.

    Analisis Blixel

    Fijar un precio de 2.195 dolares no es una rendicion comercial, sino una decision de manual cuando una tecnologia aun no es viable a escala. Snap esta haciendo lo que ya hizo Microsoft con HoloLens y otros con sus primeras gafas profesionales: vender acceso anticipado a quien construye sobre la plataforma, no a quien quiere un gadget. Ese enfoque tiene sentido siempre que se entienda como lo que es, un kit de desarrollo, y no como un producto de consumo disfrazado.

    El problema de fondo no es el precio, sino el catalogo de usos. Las gafas de realidad aumentada llevan diez anos buscando su aplicacion imprescindible y todavia no la han encontrado fuera de nichos como mantenimiento industrial, formacion o cirugia. Mientras tanto, los competidores que apuestan por formatos sencillos centrados en audio y camara estan vendiendo unidades reales porque resuelven necesidades concretas a un precio razonable. Snap rema en sentido contrario, hacia la version mas dificil de la tecnologia.

    Para una empresa cuya cuenta de resultados depende de la publicidad, esta apuesta es defendible como inversion en una posible plataforma futura, pero exige paciencia y bolsillo. La leccion para cualquier organizacion que observe el sector es simple: la realidad aumentada de gama alta sigue siendo terreno de experimentacion, no de despliegue. Quien necesite resultados ahora encontrara mas valor en wearables modestos y bien acotados que en la promesa, todavia incumplida, de la gafa que lo cambia todo.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • La IA que ayuda a diagnosticar enfermedades raras

    La IA que ayuda a diagnosticar enfermedades raras

    Un nuevo sistema basado en IA para diagnostico de enfermedades raras promete acortar uno de los procesos mas frustrantes de la medicina pediatrica: identificar patologias geneticas que un medico ve quiza una o dos veces en toda su carrera. La herramienta no sustituye al clinico, lo asiste. Y ahi esta su valor. En enfermedades que afectan a poblaciones muy pequenas, la experiencia acumulada es escasa por definicion, y cada semana perdida en pruebas inconclusas pesa sobre familias con ninos enfermos. Conviene mirar esto con realismo, sin promesas de milagro inmediato.

    Que ha pasado y por que importa

    Se ha presentado un sistema de IA disenado para asistir a medicos en el diagnostico de enfermedades geneticas raras que afectan a la poblacion infantil. El planteamiento es claro: apoyar la decision clinica en escenarios donde la rareza de la patologia limita la experiencia disponible. La IA para diagnostico de enfermedades raras entra precisamente en ese hueco, ofreciendo soporte donde el conocimiento humano se diluye por la baja frecuencia de los casos.

    El objetivo declarado es doble: acelerar procesos diagnosticos complejos y mejorar la precision en situaciones donde un especialista, por muy competente que sea, carece de referencias suficientes. No es un detalle menor. El llamado peregrinaje diagnostico, esa sucesion de consultas y pruebas que arrastran muchas familias durante anos, es uno de los problemas estructurales de las enfermedades raras.

    Las enfermedades raras se definen por su baja prevalencia, pero en conjunto afectan a millones de personas. La mayoria tiene origen genetico y se manifiesta en la infancia. El reto diagnostico siempre ha sido el mismo: pocos casos, sintomas que se solapan con otras dolencias y un numero reducido de profesionales con experiencia directa. Cualquier herramienta que comprima ese tiempo de incertidumbre tiene impacto real sobre los pacientes.

    Implicaciones tecnicas y limites actuales

    La logica detras de la IA para diagnostico de enfermedades raras es la de un sistema de apoyo a la decision. Estos modelos cruzan signos clinicos, datos geneticos y patrones aprendidos para sugerir hipotesis que el medico quiza no habria considerado. No emiten un veredicto: estrechan el campo de busqueda y ordenan las posibilidades. La decision final sigue siendo humana, y debe seguir siendolo en un terreno tan sensible.

    El contenido disponible no incluye datos especificos sobre la implementacion del sistema ni sobre sus resultados clinicos. Eso obliga a la cautela. Sin metricas de sensibilidad, especificidad o validacion en entornos hospitalarios reales, no se puede afirmar cuanto mejora realmente el diagnostico. La diferencia entre una demo prometedora y una herramienta fiable en consulta es enorme, y se mide en estudios, no en titulares.

    Hay ademas barreras conocidas en cualquier IA sanitaria: la calidad y representatividad de los datos de entrenamiento, el sesgo hacia poblaciones sobre las que existe mas informacion, la trazabilidad de las recomendaciones y los requisitos regulatorios. Un sistema que asiste en decisiones medicas debe superar validacion clinica y, en Europa, cumplir el marco de productos sanitarios. Eso marca el ritmo real de adopcion.

    Cuando y para quien sera relevante esto

    El primer colectivo que notara el efecto de la IA para diagnostico de enfermedades raras seran los hospitales de referencia y las unidades de genetica clinica, no los centros de atencion primaria. Es donde se concentran los casos complejos, los datos y los especialistas capaces de interpretar y supervisar lo que el sistema sugiere. La adopcion sera gradual y vendra precedida de validacion en entornos controlados.

    El horizonte temporal realista es de medio plazo, no inmediato. Antes de un uso rutinario hacen falta estudios que demuestren mejora diagnostica frente a la practica habitual, integracion con la historia clinica electronica y certificacion regulatoria. Para las familias afectadas, el beneficio tangible llegara cuando estas herramientas esten validadas e integradas en el flujo de trabajo hospitalario, no antes. La promesa es solida; la prudencia, obligatoria. Quien venda diagnostico automatico y definitivo hoy, exagera.

    Analisis Blixel

    Pocas aplicaciones de la inteligencia artificial tienen un caso de uso tan limpio como este. Cuando un problema combina escasez de datos humanos, alta complejidad y un coste enorme del error, el apoyo algoritmico aporta exactamente lo que falta: capacidad de cruzar patrones que ningun medico puede memorizar. Aqui la IA no compite con el profesional, le devuelve tiempo y le amplia el campo de vision. Esa es la forma sana de plantear la tecnologia en sanidad.

    Dicho esto, conviene no dejarse llevar. La ausencia de datos de resultados es justamente lo que separa una buena idea de una herramienta clinica. En medicina pediatrica, un falso positivo genera angustia y pruebas innecesarias; un falso negativo puede ser grave. La validacion no es burocracia molesta, es la frontera entre ayudar y perjudicar. Y el medico debe mantener siempre la ultima palabra, con criterio para cuestionar lo que el sistema propone.

    Para el sector salud espanol, la leccion es de gobernanza mas que de tecnologia. Quien quiera incorporar sistemas de apoyo diagnostico debera exigir evidencia, trazabilidad y encaje regulatorio antes que velocidad. El valor no esta en tener IA, sino en integrarla donde reduce sufrimiento real y en saber decir que no cuando la evidencia no acompana. Ese equilibrio, poco espectacular, es lo que distingue la adopcion seria de la moda pasajera.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Pixi convierte tus mensajes en personajes AR con IA

    Pixi convierte tus mensajes en personajes AR con IA

    La app de personajes AR con IA de Pixi acaba de aterrizar en iOS con una propuesta concreta: enviar caracteres virtuales a traves de iMessage que cobran vida usando la camara del iPhone y reaccionan al entorno en tiempo real. No son stickers animados ni filtros enlatados. La compania combina realidad aumentada con procesamiento de IA en el propio dispositivo para que los personajes interactuen con el espacio que les rodea. Esta disponible gratis para iPhone 11 y modelos posteriores, con la mirada puesta en Android, WhatsApp e Instagram. Vale la pena mirar que hay debajo y que aprovechar de aqui.

    Que ha lanzado Pixi y por que llama la atencion

    Pixi ha publicado una aplicacion para iOS centrada en una idea sencilla de explicar pero exigente de ejecutar: integrar personajes AR con IA dentro del flujo de mensajeria de iMessage. En lugar de mandar un GIF o un sticker, el usuario envia un caracter virtual que, al abrirse en el otro dispositivo, se renderiza sobre la imagen real captada por la camara del iPhone. Los personajes reaccionan al entorno en tiempo real, lo que segun la compania los aleja de las animaciones predefinidas de toda la vida.

    El procesamiento de IA ocurre en local, en el propio telefono, en lugar de depender por completo de servidores remotos. Eso tiene implicaciones de latencia y privacidad que conviene tener en cuenta. La app es gratuita y requiere iPhone 11 o posterior, un corte logico porque ese hardware es el que sostiene con holgura las cargas de AR y de inferencia en dispositivo. Pixi ya ha anunciado planes de expansion a Android y a plataformas con bases de usuarios masivas como WhatsApp e Instagram, donde el formato de mensajeria es el terreno natural para este tipo de contenido.

    Implicaciones tecnicas del AR con IA en local

    Que los personajes AR con IA se procesen en el dispositivo no es un detalle menor. La inferencia local reduce la dependencia de conexion, baja la latencia entre el gesto del usuario y la reaccion del personaje, y mantiene los datos de la camara dentro del telefono en lugar de enviarlos a la nube. Para una experiencia que depende de reaccionar al entorno en tiempo real, esos milisegundos son la diferencia entre algo creible y algo que se siente roto.

    El requisito de iPhone 11 en adelante delata las exigencias: chips con aceleradores neuronales capaces de mover modelos de vision por computador y renderizado AR simultaneamente sin fundir la bateria. El reto de portar esto a Android no es trivial, porque la fragmentacion de hardware obliga a optimizar para un abanico enorme de chips y camaras. Y llevarlo a WhatsApp o Instagram depende de las APIs que esas plataformas expongan, algo que no controla Pixi. La promesa tecnica es solida; la ejecucion multiplataforma es donde se vera si la propuesta aguanta. Por ahora, el caso iOS funciona como vitrina controlada de lo que el AR con IA puede hacer dentro de la mensajeria cotidiana.

    Que puede aprender una empresa de este lanzamiento

    La leccion util aqui no es «manda personajes AR a tus clientes», que seria forzado para la mayoria de negocios. Lo accionable es el patron tecnico: ejecutar IA en local para ganar latencia y privacidad en lugar de tirar siempre de la nube. Si una empresa esta evaluando funciones de IA en su propia app movil (reconocimiento de producto, asistentes visuales, personalizacion en tiempo real), el enfoque de inferencia en dispositivo de los personajes AR con IA de Pixi es un buen recordatorio de que no todo necesita servidor.

    El segundo aprendizaje es estrategico: Pixi lanza primero en iOS, un ecosistema homogeneo, antes de pelearse con la fragmentacion de Android. Es una secuencia que las PYMEs con recursos limitados harian bien en copiar: validar en la plataforma mas controlable y rentable antes de escalar. Lo que conviene evitar es perseguir el formato porque suena moderno. El AR con IA tiene sentido si resuelve algo (mostrar un mueble en tu salon, probar unas gafas), no como capa decorativa. Antes de invertir, mide si el formato reduce friccion real en la decision de compra o solo anade vistosidad sin retorno.

    Analisis Blixel

    Hay un patron que se repite cada pocos anos: una tecnologia visualmente impactante busca un hueco en la mensajeria y promete reinventar como nos comunicamos. Los stickers animados, los Memoji, los filtros faciales. Casi siempre el efecto es novedad intensa que se enfria rapido. La pregunta honesta sobre esta propuesta no es si la ejecucion tecnica es buena (procesar AR e IA en local en un iPhone tiene merito real), sino si el formato resuelve algo que la gente echaba de menos o si es una solucion buscando un problema.

    Para empresas, el riesgo es confundir lo llamativo con lo rentable. El engagement digital basado en AR genera metricas bonitas de interaccion inicial que rara vez se traducen en conversion o retencion sostenida. Donde si veo valor genuino es en el enfoque de inferencia en dispositivo: esa decision arquitectonica es replicable y aplica mucho mas alla de los personajes virtuales. La expansion anunciada a WhatsApp e Instagram es la verdadera prueba de fuego, porque depende de APIs ajenas y de bases de usuarios que no perdonan la friccion. Mi recomendacion para cualquier directivo tentado por este tipo de formatos es simple: pide una hipotesis medible antes de un presupuesto. Si nadie puede explicar que metrica de negocio mueve esto, no es una inversion, es un gasto en vistosidad. La tecnologia es interesante; el caso de uso empresarial todavia esta por demostrar.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.