
Categoría: IA Aplicada

  • GPT-5 resuelve en horas un enigma de inmunologia

    GPT-5 resuelve en horas un enigma de inmunologia

    El uso de GPT-5 en investigacion cientifica acaba de sumar un caso concreto: el inmunologo Derya Unutmaz afirma haber resuelto con el modelo un problema de su laboratorio que llevaba tres anos sin solucion. No es una demo de marketing ni un benchmark de laboratorio cerrado, sino uno de los primeros usos documentados del modelo en biomedicina real. El episodio interesa menos por la hazana puntual y mas por lo que sugiere sobre como los LLM avanzados empiezan a colarse en el dia a dia de la ciencia especializada.

    Que ha pasado y por que importa

    Derya Unutmaz, inmunologo, asegura que recurrio a GPT-5 para abordar un problema de investigacion que su equipo arrastraba durante tres anos. Segun su relato, el modelo aporto una perspectiva que ayudo a desbloquear el caso. Lo relevante del episodio es su naturaleza: se trata de uno de los primeros usos documentados de GPT-5 en un contexto de investigacion biomedica real, fuera de pruebas controladas. El uso de GPT-5 en investigacion cientifica deja de ser hipotetico cuando un especialista narra un resultado concreto en su propio campo.

    La inmunologia es un terreno especialmente exigente: combina volumenes enormes de literatura, mecanismos celulares complejos y la necesidad de conectar hallazgos dispersos entre disciplinas. Hasta ahora, los modelos de lenguaje se habian mostrado utiles para resumir papers, redactar borradores o generar hipotesis genericas. El salto que insinua este caso es distinto: usar el modelo como interlocutor capaz de ofrecer un angulo nuevo sobre un problema que un equipo humano experto ya habia explorado a fondo sin exito.

    Implicaciones tecnicas del caso

    Conviene leer este episodio con prudencia metodologica. Un testimonio individual, por valioso que sea, no equivale a evidencia reproducible. No conocemos el detalle del problema, ni que prompts se usaron, ni en que medida el modelo aporto la idea clave frente a confirmarla o reorganizarla. El uso de GPT-5 en investigacion cientifica seguira necesitando validacion experimental: un LLM puede sugerir una hipotesis plausible, pero la ciencia la confirma o la descarta en el laboratorio, no en el chat.

    Dicho esto, el patron tecnico es coherente con la direccion que llevan los modelos de frontera. Su capacidad para razonar sobre dominios densos, cruzar contextos largos y plantear conexiones no obvias encaja con tareas de generacion de hipotesis. El valor no esta en que el modelo sepa mas inmunologia que un inmunologo, sino en que no comparte sus sesgos ni su fatiga, y puede proponer caminos que el experto descarto pronto. Ese rol de socio cognitivo, mas que de oraculo, es probablemente el mas realista para los LLM en ciencia avanzada hoy.

    Cuando y para quien sera relevante esto

    El uso de GPT-5 en investigacion cientifica es ya relevante, pero para un perfil concreto: investigadores con experiencia capaces de evaluar criticamente lo que el modelo propone. Para ese grupo, el horizonte es inmediato: generacion de hipotesis, revision de enfoques atascados, exploracion de literatura cruzada y formulacion de preguntas alternativas. No sustituye al cientifico; le da un interlocutor incansable.

    Para equipos sin esa base, el horizonte es mas largo y mas arriesgado. Un LLM que suena convincente puede inducir conclusiones erroneas a quien no tiene criterio para filtrarlas, y en biomedicina el coste de un camino falso es alto. El beneficio real llega cuando hay un humano experto en el bucle que valida cada sugerencia. A medio plazo, lo esperable es que herramientas de este tipo se integren en flujos de laboratorio, no como autores de descubrimientos, sino como aceleradores de la fase de ideacion. La adopcion seria depende menos del modelo y mas de la cultura de verificacion del equipo que lo usa.

    Analisis Blixel

    Un testimonio no hace tendencia, y aqui esta el riesgo de leer demasiado en un solo caso. Cuando un especialista cuenta que una herramienta le desbloqueo tres anos de trabajo, el titular se escribe solo, pero la pregunta interesante es otra: cuantos intentos fallidos quedaron sin contar antes de ese acierto. La honestidad obliga a tratar este episodio como una senal prometedora, no como prueba. Lo que si resulta solido es el cambio de rol del modelo. Pasamos de pedirle resumenes a usarlo como contraparte intelectual sobre problemas que ya hemos exprimido. Ahi esta el valor genuino: un experto atascado tiene mas que ganar de un interlocutor que no comparte sus puntos ciegos que de uno que sabe mas que el. Para empresas y laboratorios, la leccion practica es clara: el retorno aparece cuando hay alguien capaz de juzgar la respuesta, no cuando se delega el juicio. Quien adopte estos modelos esperando que decidan por el acabara persiguiendo callejones sin salida con aire de certeza. Quien los use como amplificador de su propio criterio, con verificacion sistematica, sacara ventaja real. La inteligencia artificial avanzada no resuelve problemas: ofrece angulos. La diferencia entre acelerar la ciencia y contaminarla con ruido convincente la sigue marcando el humano que esta delante de la pantalla.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Claude ya vive en tu Slack y recuerda lo que pasa

    Claude ya vive en tu Slack y recuerda lo que pasa

    Anthropic acaba de presentar Claude Tag, un asistente IA en Slack que permanece activo en los canales de la empresa y aprende de forma continua del trabajo del equipo. La novedad no es que responda preguntas, eso ya lo hacian los bots anteriores, sino que mantiene contexto persistente y memoria entre sesiones, ademas de poder intervenir por iniciativa propia para actualizar al equipo o recordar tareas pendientes. La funcion llega en version de investigacion para clientes de Claude Enterprise y Claude Team, con control administrativo sobre que puede ver y hacer cada instancia.

    Que ha pasado y por que importa

    Anthropic ha lanzado Claude Tag como un asistente IA en Slack en fase de investigacion. A diferencia de un chatbot que arranca de cero en cada conversacion, Claude Tag se queda residente en los canales, sigue las conversaciones y accede a informacion organizacional para construir un contexto continuo del trabajo de la empresa. Eso le permite recordar decisiones tomadas semanas atras, retomar hilos sin que nadie le ponga al dia y entender de que se habla sin necesidad de repetir todo el historial.

    El cambio relevante es la memoria persistente. Hasta ahora, integrar un modelo en Slack significaba pegarle el contexto en cada peticion, con limites de tokens y resultados desiguales. Claude Tag puede intervenir proactivamente: avisar de un cambio, recordar un pendiente o resumir lo acordado sin que se lo pidan. Esa proactividad, bien acotada, es justo lo que separa una herramienta de consulta de un companero de equipo automatizado. Esta disponible para Claude Enterprise y Claude Team, y son los administradores quienes definen que herramientas, que informacion y que canales puede tocar cada instancia.

    Implicaciones tecnicas de un asistente con memoria

    Un asistente IA en Slack con contexto persistente cambia la arquitectura del problema. La gracia de Claude Tag no esta solo en el modelo, sino en la capa de memoria y permisos que lo rodea. Que un agente recuerde entre sesiones implica almacenar y recuperar contexto de forma fiable, algo que tradicionalmente se resolvia con sistemas RAG montados a mano. Aqui Anthropic lo integra de fabrica, con el control de acceso como pieza central: cada instancia ve solo los canales e informacion que el administrador autorice.

    Esa granularidad de permisos es lo que hace viable el despliegue en una empresa real. Un asistente que escucha todo y recuerda todo es un riesgo de gobernanza evidente; uno que solo opera en los canales y datos definidos es gestionable. La intervencion proactiva tambien obliga a pensar en el ruido: un bot que escribe cuando no toca se desactiva en una semana. El reto tecnico real no es la inteligencia del modelo, sino calibrar cuando merece la pena que hable y garantizar que la memoria persistente no filtre informacion entre equipos que no deberian compartirla.

    Como pueden aplicar esto las empresas hoy

    Si ya usas Claude Enterprise o Claude Team, el primer paso es acotar. No abras Claude Tag a todos los canales de golpe: empieza por uno o dos donde el contexto sea valioso y el riesgo bajo, como un canal de soporte interno o de seguimiento de proyecto. Define desde el panel de administracion que informacion y herramientas puede tocar antes de activarlo, no despues. Mide algo concreto durante las primeras semanas: tiempo ahorrado en poner al dia a alguien, pendientes que el equipo olvidaba y ahora se recuerdan, o consultas resueltas sin abrir otra herramienta.

    Que evitar: dejarlo en modo proactivo agresivo desde el dia uno, porque el rechazo del equipo a un bot pesado es dificil de revertir. Tampoco lo metas en canales con datos sensibles de RRHH o financieros sin revisar permisos a fondo. El ROI aqui no esta en sustituir a nadie, sino en eliminar el coste invisible de repetir contexto una y otra vez. Para una PYME con equipos pequenos y rotacion, esa memoria compartida es lo que mas se nota.

    Analisis Blixel

    La frontera entre un chatbot y un agente util se cruza justo en este punto: la persistencia. Un modelo que olvida todo al cerrar la pestana es una calculadora cara; uno que recuerda lo que paso ayer y actua sin que se lo pidan empieza a parecerse a algo que aporta de verdad. Anthropic ha entendido que el valor no esta en otra demo de razonamiento, sino en resolver el problema aburrido y carisimo de mantener a un equipo alineado.

    Dicho esto, la version de investigacion no es casualidad. La proactividad es un arma de doble filo: el dia que el bot interrumpe una conversacion delicada con un recordatorio fuera de lugar, o resume algo que no deberia haber leido, la confianza se evapora. Y la memoria persistente en un entorno multiequipo es un campo minado de fugas de informacion si los permisos no estan bien atados. Que el control administrativo sea granular es buena senal, pero el exito dependera de lo que las empresas hagan con el, no de lo que prometa Anthropic.

    Nuestra recomendacion es pragmatica: pruebenlo en un canal, con permisos restrictivos y modo discreto, y dejen que el equipo decida si quiere mas. Las herramientas que se imponen desde arriba en Slack mueren rapido. Las que ganan su sitio canal a canal se quedan. Esta tiene madera de quedarse, si se despliega con cabeza.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • AWS estrena arquitectura multi-tenant en Bedrock AgentCore

    AWS estrena arquitectura multi-tenant en Bedrock AgentCore

    AWS ha publicado una guía técnica para construir una arquitectura multi-tenant con Amazon Bedrock AgentCore, pensada para empresas SaaS que sirven a varios clientes desde la misma infraestructura. La propuesta combina recursos compartidos con aislamiento total de datos entre inquilinos, y añade niveles de servicio diferenciados. El ejemplo de referencia es un asistente de IA sanitario con dos planes: uno Básico con Mistral Ministral 3 8B para clínicas pequeñas, y otro Premium con OpenAI GPT OSS 120B para hospitales que necesitan análisis clínicos más exigentes.

    Qué ha publicado AWS y por qué importa

    La guía detalla cómo desplegar una arquitectura multi-tenant con Amazon Bedrock AgentCore donde varios clientes comparten la misma plataforma pero mantienen sus datos completamente separados. El objetivo es claro: reducir costes operativos sin renunciar a la seguridad ni a la separación estricta entre cuentas. En lugar de levantar una infraestructura dedicada por cada cliente, la empresa proveedora gestiona un único entorno con aislamiento lógico por inquilino.

    El caso práctico que AWS usa para ilustrarlo es un asistente para el sector sanitario estructurado en dos niveles. El plan Básico recurre a Mistral Ministral 3 8B, un modelo ligero adecuado para clínicas pequeñas con consultas sencillas. El plan Premium usa OpenAI GPT OSS 120B, un modelo mucho mayor orientado a hospitales que requieren razonamiento clínico complejo. Esta segmentación por modelo permite ajustar coste y capacidad a lo que cada cliente paga y necesita.

    El patrón multi-tenant no es nuevo en SaaS tradicional, pero aplicarlo a agentes de IA introduce retos específicos: aislar contextos, memoria y datos sensibles entre clientes que comparten el mismo motor de inferencia. Que AWS documente un camino concreto con AgentCore baja la barrera para equipos que ya operan en su nube.

    Implicaciones técnicas de esta arquitectura multi-tenant

    Lo relevante de la arquitectura multi-tenant con Amazon Bedrock AgentCore es que separa dos decisiones que suelen mezclarse: la infraestructura y el modelo. Un mismo despliegue puede enrutar las peticiones de cada inquilino al modelo que corresponde a su nivel de servicio, sin duplicar el resto del stack. Eso significa que el plan Básico y el Premium comparten orquestación, autenticación y gestión, pero divergen en el modelo que ejecuta la inferencia.

    El aislamiento completo entre inquilinos es el punto crítico, especialmente en sanidad. Los datos clínicos de una clínica no pueden filtrarse al contexto de otra, ni acabar en la memoria de un agente compartido. La guía aborda precisamente cómo mantener esa separación mientras se reutiliza infraestructura común, que es donde está el ahorro de costes.

    La elección de modelos también es indicativa. Combinar un modelo pequeño como Ministral 3 8B con uno grande como GPT OSS 120B muestra una estrategia de escalado por necesidad real: no todos los clientes requieren la misma potencia, y pagar por capacidad que no se usa es desperdicio. Esta lógica de niveles encaja con cómo facturan la mayoría de productos SaaS.

    Cómo pueden aplicar esto las empresas hoy

    Si desarrollas un SaaS de IA y ya estás en AWS, la arquitectura multi-tenant con Amazon Bedrock AgentCore ofrece un patrón directo para empezar a evaluar. El primer paso es mapear tus clientes por nivel real de necesidad: cuántos requieren razonamiento complejo y cuántos resuelven con un modelo ligero. Esa segmentación define tu estructura de planes y tu coste de inferencia. Antes de migrar, conviene calcular el ahorro frente a tu modelo actual: la infraestructura compartida solo compensa si tienes suficientes clientes para amortizarla.

    El riesgo a vigilar es el aislamiento de datos. En sectores regulados como sanidad, una fuga entre inquilinos no es un bug menor, es un incidente legal. Antes de pasar a producción, audita que la memoria de los agentes y los contextos no se crucen entre clientes, y documenta esa separación para cumplimiento. Lo que conviene evitar es lanzar un único nivel para todos: pagar GPT OSS 120B para consultas triviales destruye el margen. La gracia del patrón está en cobrar y servir según uso, no en igualar a todos por arriba.

    Análisis Blixel

    El mérito de esta guía no está en la tecnología, sino en que pone nombre a una decisión que muchos equipos posponen: no todos los clientes necesitan el modelo más caro. La industria lleva un par de años obsesionada con el modelo más grande disponible, cuando la mayoría de casos de uso reales se resuelven con uno pequeño y bien orquestado. Reservar GPT OSS 120B para los hospitales y dejar Ministral 3 8B para las clínicas pequeñas es ingeniería de costes con sentido común, justo lo que falta en demasiados proyectos de IA.

    Dicho esto, el patrón multi-tenant tiene una trampa que conviene nombrar: el aislamiento de datos es fácil de prometer y difícil de garantizar cuando varios clientes comparten el mismo motor de inferencia. En sanidad eso no se negocia, y cualquier equipo que adopte esta arquitectura debería invertir tanto en auditar la separación como en construir las features. AWS documenta el camino, pero la responsabilidad de que un agente no arrastre el contexto de otro inquilino sigue siendo del que lo despliega. Para una PYME tecnológica que vende SaaS, este enfoque reduce la barrera de entrada real: ya no hace falta una infraestructura por cliente para parecer serio. Pero la verdadera ventaja competitiva no será la arquitectura, que cualquiera puede copiar, sino la disciplina al elegir qué modelo va en cada plan. Ahí es donde se gana o se pierde el margen.

    ¿Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido común. Hablemos.

  • Santa Pola moderniza su alumbrado con NB-IoT

    Santa Pola moderniza su alumbrado con NB-IoT

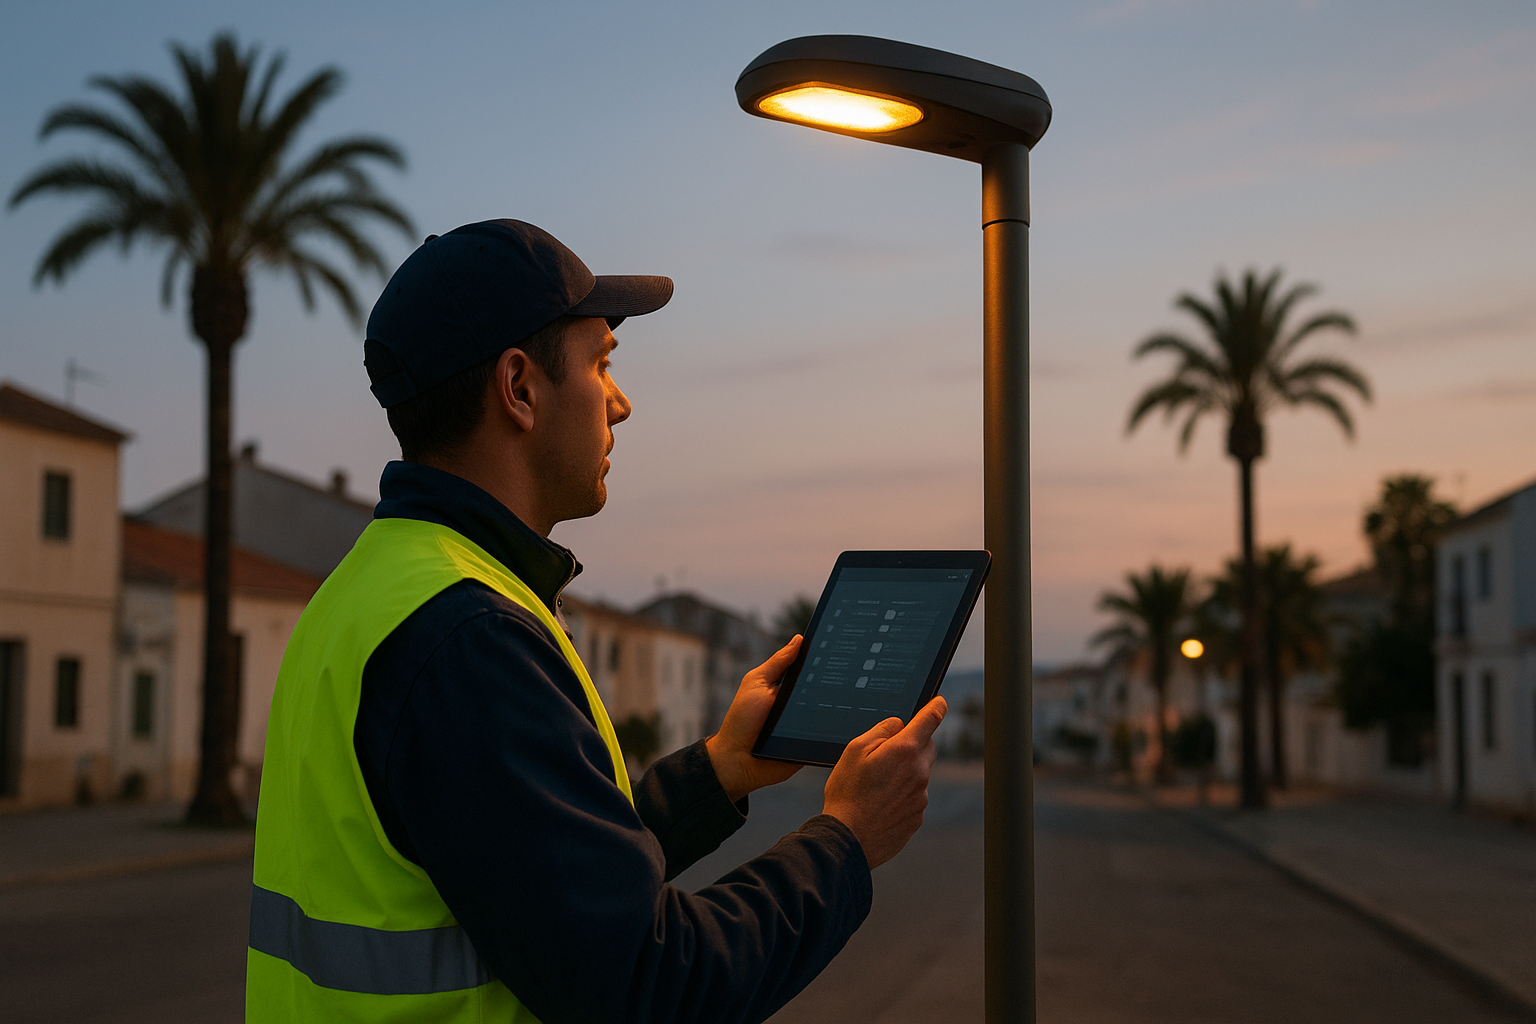
    El alumbrado publico con NB-IoT ha dado un paso concreto en la Costa Blanca: Telefonica Tech ha colaborado con el municipio de Santa Pola para actualizar su red de iluminacion urbana mediante conectividad de banda estrecha para el Internet de las Cosas. No es un piloto de laboratorio ni una demo de feria, sino un despliegue real sobre infraestructura que ya existia. El caso interesa porque el alumbrado es uno de los servicios municipales mas costosos en energia y mantenimiento, y porque demuestra como una tecnologia poco glamurosa puede generar ahorro medible sin reformas faraonicas.

    Que ha pasado en Santa Pola y por que importa

    Telefonica Tech ha aportado sus capacidades de NB-IoT a la modernizacion del alumbrado publico de Santa Pola, una localidad costera de la Costa Blanca. El proyecto conecta los puntos de luz de la ciudad a una red de banda estrecha pensada especificamente para dispositivos que envian pocos datos, de forma intermitente y con bajo consumo. Es justo el perfil de una farola: no necesita transmitir video ni grandes volumenes de informacion, solo estado, consumo y eventuales averias.

    La relevancia del caso esta en el tipo de tecnologia elegida. El alumbrado publico con NB-IoT no requiere desplegar una red propia ni instalar gateways por toda la ciudad, porque aprovecha la cobertura de las operadoras moviles. Eso reduce la barrera de entrada para un ayuntamiento que no quiere convertirse en operador de telecomunicaciones para gestionar sus farolas. El alumbrado es, ademas, una de las partidas energeticas mas pesadas de cualquier consistorio, asi que cualquier mejora en control y eficiencia tiene impacto directo en el presupuesto municipal.

    Implicaciones tecnicas del despliegue NB-IoT

    NB-IoT (Narrowband IoT) es un estandar de conectividad celular de bajo consumo y largo alcance, integrado en las redes moviles. Sus ventajas para un caso como el alumbrado publico con NB-IoT son claras: penetracion de senal en ubicaciones complicadas, consumo energetico muy bajo en los modulos conectados y un coste por dispositivo contenido. A cambio, ofrece poco ancho de banda y latencias altas, limitaciones irrelevantes cuando lo unico que viaja es telemetria de farolas.

    Conectar los puntos de luz permite pasar del encendido por reloj o por celula fotoelectrica a una gestion centralizada y granular: regular la intensidad por tramos horarios, detectar lamparas fundidas sin esperar a que un vecino las reporte y medir el consumo real punto por punto. Esa visibilidad es la base del ahorro, porque convierte el mantenimiento reactivo en preventivo y elimina horas de patrullaje para localizar averias. El alumbrado publico con NB-IoT tambien sienta las bases para anadir despues otros servicios sobre la misma red municipal, desde sensores de contenedores hasta medicion de calidad del aire, sin rehacer la infraestructura de conectividad.

    Como pueden aplicar esto las empresas y municipios hoy

    Para un ayuntamiento o una empresa de servicios, la leccion practica es empezar por el caso de uso con ROI mas obvio antes de imaginar la ciudad inteligente completa. El alumbrado publico con NB-IoT funciona como punto de entrada precisamente porque el ahorro es cuantificable: factura electrica y horas de mantenimiento. Antes de firmar nada, conviene exigir una linea base de consumo actual y un objetivo de reduccion medible, no promesas genericas de eficiencia.

    Que evaluar: cobertura NB-IoT real en la zona concreta (no toda el area tiene la misma senal), coste por dispositivo y por conexion mensual, y quien gestiona la plataforma de telemetria. Lo que conviene evitar es montar un piloto de tres farolas y declarar exito sin extrapolar costes a escala, o atarse a una plataforma cerrada que impida anadir luego otros sensores. Para una PYME que presta servicios a municipios, el caso de Santa Pola es argumento comercial concreto: hay un despliegue real que mostrar, no una diapositiva. Empezar pequeno, medir bien y expandir solo lo que demuestre retorno es la via realista.

    Analisis Blixel

    Hay una tentacion constante de vender la ciudad inteligente como un salto futurista lleno de pantallas y datos en tiempo real. La realidad util es mucho mas aburrida y mucho mas rentable: una farola que avisa cuando se funde y se regula sola por la noche. Ese pragmatismo es lo que hace creible este tipo de proyecto. No se trata de tecnologia por la tecnologia, sino de atacar una partida de gasto concreta con la herramienta minima necesaria.

    Conviene matizar el entusiasmo, eso si. La conectividad es solo el primer eslabon; el valor real depende de la plataforma de gestion, de quien analiza la telemetria y de que el ayuntamiento tenga capacidad para actuar sobre lo que mide. Conectar farolas sin un proceso detras solo genera datos que nadie mira. El riesgo tipico de estos despliegues no es tecnico, es organizativo: comprar sensores y no cambiar la forma de trabajar.

    El modelo de banda estrecha sobre red de operadora tiene sentido porque libera al municipio de operar telecomunicaciones, aunque crea una dependencia del proveedor que hay que negociar bien desde el contrato. Para municipios pequenos y medianos, casos como este marcan el camino sensato: empezar por lo que ahorra dinero de verdad, demostrarlo con numeros y expandir solo entonces. Menos relato y mas factura electrica.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Nvidia quiere redes telecom autonomas con agentes IA

    Nvidia quiere redes telecom autonomas con agentes IA

    Nvidia ha decidido alinear a buena parte del sector de las telecomunicaciones detras de un objetivo concreto: los agentes de IA en telecomunicaciones que permitan saltar de la automatizacion por tareas a redes capaces de operar solas. Junto a varios socios del sector, la compania prepara una demostracion de un paquete de datos, modelos y herramientas de simulacion que mostrara en DTW Ignite 2026. El mensaje de fondo es claro: el siguiente paso para los operadores no es automatizar procesos sueltos, sino orquestar agentes que tomen decisiones sobre la red de forma continua y, en buena medida, sin intervencion humana.

    Que ha pasado y por que importa

    Nvidia y sus socios de telecomunicaciones planean presentar en DTW Ignite 2026 un conjunto formado por datos, modelos preentrenados y herramientas de simulacion. El proposito declarado es ayudar a los operadores a pasar de la automatizacion basada en tareas, donde cada proceso se programa de forma aislada, hacia operaciones de red completamente autonomas. En la practica, eso significa pasar de scripts que ejecutan acciones concretas a agentes de IA que perciben el estado de la red, deciden y actuan dentro de un marco definido.

    El movimiento de los agentes de IA en telecomunicaciones no surge de la nada. Los operadores llevan anos invirtiendo en automatizacion de operaciones de red, gestion de incidencias y optimizacion de capacidad, pero la mayoria de esos sistemas siguen siendo reactivos y muy acotados. La aportacion de la simulacion es relevante: permite entrenar y validar comportamientos antes de tocar infraestructura real, algo critico cuando hablamos de redes que dan servicio a millones de personas. Que Nvidia reuna a varias telcos en torno a un mismo enfoque sugiere un intento de estandarizar la base sobre la que se construyen esos agentes.

    Implicaciones tecnicas y de mercado

    El planteamiento de los agentes de IA en telecomunicaciones descansa en tres piezas que encajan entre si. Los datos aportan el contexto operativo real de la red; los modelos ofrecen la capacidad de razonar y decidir sobre ese contexto; y la simulacion proporciona un entorno seguro para validar antes de desplegar. La diferencia frente a la automatizacion clasica esta en el grado de autonomia: un agente no se limita a ejecutar un paso, sino que encadena observacion, decision y accion, ajustandose a situaciones que no estaban previstas linea a linea.

    Para el mercado, que sea Nvidia quien orqueste esta iniciativa no es un detalle menor. La compania controla buena parte del hardware de computacion que se usa para entrenar e inferir modelos, y posicionar los agentes de IA en telecomunicaciones como la nueva frontera operativa refuerza la demanda de su stack. Para los operadores, el atractivo es operativo y economico: redes autonomas prometen menos intervencion manual, respuesta mas rapida ante incidencias y mejor uso de la capacidad. El riesgo, igual de real, es la dependencia tecnologica y la dificultad de auditar decisiones tomadas por agentes en infraestructura critica.

    Como pueden aplicar esto las empresas hoy

    Pocas PYMEs operan una red de telecomunicaciones, pero la logica detras de los agentes de IA en telecomunicaciones es trasladable a cualquier empresa que ya tenga automatizacion por tareas y se plantee dar un paso mas. La accion concreta no es comprar un agente, sino auditar primero que procesos estan bien automatizados y cuales generan decisiones repetitivas que un agente podria encadenar. Sin datos limpios y un entorno donde probar sin romper produccion, cualquier salto a la autonomia es prematuro. La simulacion que plantea Nvidia es justamente eso: un recordatorio de que validar antes de desplegar no es opcional.

    En terminos de ROI, conviene ser realista. Lo que aporta valor inmediato es reducir intervencion manual en tareas de alto volumen y baja complejidad, no perseguir autonomia total desde el primer dia. Lo que hay que evitar es comprar la narrativa de las redes autonomas y aplicarla a procesos que ni siquiera estan medidos. Empieza por casos acotados, mide la tasa de error del agente frente al proceso manual y mantén siempre supervision humana en decisiones con impacto critico. La autonomia es un destino gradual, no un interruptor.

    Analisis Blixel

    Reunir a un sector entero alrededor de un mismo paquete de datos, modelos y simulacion es una jugada de plataforma tan logica como interesada. Nvidia no vende solo una vision tecnica: vende la base de computo sobre la que se ejecutara esa vision, y eso conviene tenerlo presente antes de comprar el relato de la red que se gobierna sola. La promesa de los agentes de IA en telecomunicaciones es atractiva, pero el salto de la automatizacion por tareas a la autonomia completa es mucho mas largo de lo que sugiere una demo en un congreso. Las redes de los operadores son entornos criticos donde un fallo no es una incidencia menor, sino un servicio caido para millones de personas. La pieza de simulacion es, de hecho, la mas sensata del anuncio: reconoce implicitamente que estos sistemas necesitan validarse a fondo antes de tocar produccion. El verdadero cuello de botella no sera el modelo, sino la calidad de los datos operativos, la trazabilidad de las decisiones y la confianza regulatoria. Para cualquier empresa que observe este movimiento, la leccion util no es correr hacia la autonomia, sino entender que un agente solo es tan bueno como el contexto que recibe y el marco que lo limita. La autonomia bien hecha se construye despacio, midiendo, y manteniendo a una persona responsable de lo que importa. Lo demas es marketing de congreso.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Ericsson empuja la automatizacion de redes moviles

    Ericsson empuja la automatizacion de redes moviles

    La automatizacion de redes moviles vuelve al centro del tablero de los operadores. Ericsson ha presentado un conjunto de actualizaciones de producto acompanadas de estrategias comerciales definidas, todas orientadas a un mismo objetivo: ayudar a las operadoras a aumentar el grado de autonomia de sus redes. El movimiento no es menor en un sector donde gestionar miles de nodos y picos de trafico de forma manual ya no es sostenible. Aqui repasamos que ha anunciado el fabricante sueco, por que importa para el mercado de telecomunicaciones y que pueden hacer hoy las empresas que dependen de esa infraestructura.

    Que ha presentado Ericsson y por que importa

    Ericsson ha actualizado parte de su gama de productos e introducido estrategias comerciales concretas pensadas para apoyar a los operadores en su camino hacia una mayor automatizacion de redes moviles. El foco declarado es la autonomia de la red: que la infraestructura pueda gestionarse, optimizarse y corregirse con la minima intervencion humana posible. Para los operadores, esto se traduce en menos tareas manuales repetitivas y en una operacion mas predecible a medida que crece la complejidad de las redes 5G.

    El contexto explica el movimiento. Las redes moviles actuales combinan multiples generaciones de tecnologia, densidades de nodos crecientes y patrones de trafico cada vez mas dificiles de anticipar. La gestion manual de ese entramado encarece la operacion y multiplica el margen de error. Ericsson, como uno de los grandes proveedores de equipamiento de red del mundo, lleva anos posicionando la automatizacion de redes moviles como palanca para reducir costes operativos. Esta actualizacion de gama y el acompanamiento comercial son una continuacion logica de esa apuesta, mas que un giro de estrategia.

    Implicaciones tecnicas y de mercado

    La autonomia de red no es un interruptor que se activa, sino una escala de niveles que va desde la asistencia puntual hasta sistemas capaces de tomar decisiones operativas sin supervision directa. Cuando un fabricante como Ericsson refuerza su gama hacia la automatizacion de redes moviles y la acompana de estrategias comerciales definidas, esta facilitando que los operadores avancen por esa escala sin tener que ensamblar piezas sueltas de distintos proveedores. El valor para el cliente esta tanto en la tecnologia como en el modelo de adopcion.

    Para el mercado, el mensaje es de consolidacion. Los operadores europeos llevan tiempo bajo presion para contener el gasto operativo mientras mantienen la calidad del servicio, y la automatizacion es una de las pocas vias para conseguir ambas cosas. Que el proveedor empaquete producto y propuesta comercial reduce la friccion de compra y refuerza su posicion frente a competidores. La automatizacion de redes moviles se confirma asi como un campo de batalla comercial, no solo tecnico, entre los grandes fabricantes de equipamiento.

    Como pueden aplicar esto las empresas hoy

    Si tu empresa depende de conectividad critica (logistica, retail con multiples sedes, industria), este anuncio importa de forma indirecta: una mayor automatizacion de redes moviles en tu operador deberia traducirse, con el tiempo, en menos incidencias y mejor estabilidad. La accion concreta no es comprar producto de Ericsson, sino preguntar a tu proveedor de conectividad por su hoja de ruta de autonomia de red y por los compromisos de servicio asociados. Evalua el ROI midiendo el coste de las caidas e incidencias actuales frente a lo que te ofrece un operador con red mas automatizada. Lo que conviene evitar es asumir que la automatizacion elimina el riesgo: la autonomia de red reduce tareas manuales, pero no exime de tener planes de contingencia ni de revisar los SLA por escrito. Pide datos verificables de disponibilidad antes de migrar servicios criticos.

    Analisis Blixel

    Conviene separar el anuncio del ruido. Cuando un gran fabricante refuerza su gama y la envuelve en estrategias comerciales, lo que vende no es magia operativa: es una forma mas comoda de comprar capacidades que antes habia que integrar a mano. Eso tiene valor real para los operadores, pero no cambia las leyes de la fisica ni de la gestion de proyectos. La automatizacion de redes moviles es una tendencia solida porque responde a un problema autentico, el de operar infraestructuras demasiado complejas para gestionarse manualmente, y no a una moda. El matiz importante es que la autonomia de red llega por niveles y de forma desigual: ningun operador pasa de la gestion manual a la red autonoma de un trimestre a otro. Para las empresas que consumen esa conectividad, la recomendacion es de pragmatismo: aprovechar las mejoras de estabilidad cuando lleguen, exigir transparencia en metricas y no firmar nada por una promesa de futuro. Los anuncios de producto de los grandes proveedores marcan direccion, pero el beneficio tangible para el cliente final tarda en materializarse y depende tanto de la ejecucion del operador como de la tecnologia subyacente. Mirar el anuncio con interes, pero medir resultados con escepticismo, es la postura sensata.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Como entrenar redes neuronales hasta 6 veces mas rapido

    Como entrenar redes neuronales hasta 6 veces mas rapido

    Optimizar el entrenamiento de redes neuronales dejo de ser un lujo reservado a los grandes laboratorios. Quince tecnicas concretas, implementables en PyTorch, permiten reducir los tiempos de entrenamiento entre 4 y 6 veces sin cambiar de hardware. Hablamos de ajustes en el optimizador, el uso correcto de la GPU, la precision mixta, el paralelismo en multiples tarjetas y la gestion fina de la memoria y los datos. Para equipos que pagan horas de computo por hora, cada porcentaje de aceleracion se traduce en factura. Aqui esta el mapa completo, sin humo.

    Que se ha publicado y por que importa

    El conjunto de tecnicas para optimizar el entrenamiento de redes neuronales agrupa quince practicas que van de lo basico a lo avanzado, cada una acompanada de su fragmento de codigo en PyTorch. En el escalon de entrada estan decisiones que mucha gente pasa por alto: usar un optimizador eficiente como AdamW, mover el computo a aceleradores GPU o TPU y subir el batch size hasta el maximo que la memoria permita. Solo con esto, muchos entrenamientos ya ganan velocidad.

    El segundo bloque entra en territorio mas tecnico: entrenamiento de precision mixta para usar formatos de coma flotante de 16 bits sin perder estabilidad, y paralelismo en multiples GPU repartido por modelo, datos, pipeline o tensor. Cuando los modelos son grandes, frameworks como DeepSpeed o FSDP (Fully Sharded Data Parallel) reparten parametros y estados del optimizador entre tarjetas. La diferencia frente a hace unos anos es que estas herramientas ya estan integradas y documentadas, no son codigo experimental. El que sepa elegir la combinacion correcta para su caso obtiene la aceleracion; el que las aplique a ciegas, no.

    Implicaciones tecnicas de cada bloque de tecnicas

    El tercer grupo se centra en memoria y datos, y es donde se esconden las ganancias menos evidentes al optimizar el entrenamiento de redes neuronales. El activation checkpointing intercambia memoria por computo: en lugar de guardar todas las activaciones, las recalcula en el backward, lo que permite batch size mas grandes. La normalizacion ejecutada en GPU evita transferencias innecesarias, y la acumulacion de gradientes simula un batch grande cuando no cabe en memoria, dividiendolo en pasos.

    Hay detalles que parecen menores y no lo son. Crear los tensores directamente en la GPU, en vez de en CPU y luego moverlos, ahorra transferencias por el bus PCIe. Ajustar el DataLoader con num_workers adecuados y pin_memory activado evita que la carga de datos se convierta en el cuello de botella mientras la GPU espera ociosa. Cada tecnica viene con su explicacion de cuando aplicarla y por que acelera o estabiliza. Esa parte es clave: ninguna de estas optimizaciones es universal. Subir el batch size puede degradar la convergencia, y el paralelismo de modelo solo compensa cuando el modelo no cabe en una sola tarjeta.

    Como pueden aplicar esto las empresas hoy

    El orden de adopcion importa. Para optimizar el entrenamiento de redes neuronales sin reescribir todo, empieza por lo barato y de bajo riesgo: AdamW, mover el computo a GPU, ajustar el DataLoader (num_workers, pin_memory) y crear tensores en GPU. Estos cambios son de pocas lineas y rara vez rompen nada. Despues, activa la precision mixta, que en hardware moderno suele dar la mejor relacion esfuerzo-ganancia.

    El paralelismo multi-GPU y frameworks como DeepSpeed o FSDP son el ultimo escalon: solo merecen la pena cuando el modelo o el batch no caben en una sola tarjeta, o cuando entrenas con frecuencia y la factura de computo justifica la complejidad de configuracion. Antes de saltar ahi, mide. Perfila el entrenamiento para saber si tu cuello de botella es la GPU, la memoria o la carga de datos: optimizar lo que no limita es tirar horas. Para una PYME que entrena modelos a medida cada pocas semanas, dominar los primeros seis puntos ya recorta tiempos y coste cloud sin contratar un especialista en sistemas distribuidos.

    Analisis Blixel

    La velocidad de entrenamiento es uno de esos parametros que las empresas ignoran hasta que ven la factura de la nube. Y ahi esta el verdadero valor de un listado como este: no es teoria de paper, es ingenieria de costes. Reducir un entrenamiento de seis horas a una se traduce directamente en menos gasto en GPU alquiladas y en ciclos de experimentacion mas cortos, que es lo que de verdad mueve un proyecto de machine learning hacia produccion.

    El riesgo que vemos a diario es el contrario: equipos que saltan directamente al paralelismo multi-GPU o a DeepSpeed porque suena potente, cuando su cuello de botella real era un DataLoader mal configurado que tenia la tarjeta esperando datos la mitad del tiempo. El orden correcto es medir primero, optimizar despues. Las ganancias mas grandes casi siempre estan en lo aburrido: precision mixta, batch size razonable y carga de datos eficiente.

    Tambien conviene desconfiar del numero magico. Un 4x o 6x depende del modelo, del hardware y del punto de partida; quien ya tenia un pipeline decente vera menos, y quien partia de un setup ingenuo vera mas. Lo sensato es tratar estas quince tecnicas como una checklist priorizada por riesgo y esfuerzo, no como una receta que se aplica entera. La disciplina de perfilar antes de tocar separa a los equipos que aceleran de verdad de los que solo anaden complejidad.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Como evitar el data leakage en tus modelos de ML

    Como evitar el data leakage en tus modelos de ML

    La fuga de datos en pipelines de ML es uno de esos fallos silenciosos que no aparecen en ningun error de consola, pero que arruinan un proyecto entero. El modelo entrena bien, las metricas son excelentes y todo el mundo se felicita. Luego llega a produccion y rinde mucho peor de lo prometido. El culpable suele ser el data leakage: el modelo ha visto durante el entrenamiento informacion que no tendra disponible en el momento real de la prediccion. Y eso convierte cualquier validacion en una mentira piadosa que se paga cara.

    Que es el data leakage y por que rompe tus modelos

    La fuga de datos en pipelines de ML ocurre cuando, de forma inadvertida, durante el entrenamiento se cuela informacion que no estaria disponible en inferencia. El resultado son metricas infladas: precision, recall o error que parecen estupendos en la fase de pruebas pero que no se sostienen cuando el modelo opera con datos reales. El equipo cree tener un modelo fiable cuando en realidad tiene uno que ha hecho trampa sin saberlo.

    Las fugas mas comunes son tambien las mas faciles de pasar por alto. Una clasica: aplicar transformaciones como escalado, imputacion de valores faltantes o encoding antes de dividir los datos en train, validation y test. Otra igual de frecuente: calcular estadisticas (medias, desviaciones, categorias) usando tambien los conjuntos de validacion o prueba. En ambos casos, informacion del futuro o de datos que el modelo no deberia conocer se filtra hacia el entrenamiento.

    El problema no es nuevo. Cualquiera que haya trabajado con Kaggle o con modelos en produccion ha visto el salto entre la metrica de validacion y la realidad. La diferencia entre un buen practicante y uno que aun esta aprendiendo suele estar precisamente aqui: en saber detectar donde se esta colando informacion que no toca.

    Como se previene tecnicamente la fuga de datos

    La regla de oro para evitar la fuga de datos en pipelines de ML es sencilla de enunciar y facil de incumplir: divide primero, transforma despues. Primero separas train, validation y test. Solo entonces ajustas las transformaciones usando exclusivamente el conjunto de entrenamiento, y luego aplicas esos mismos parametros al resto. El escalador aprende la media y la desviacion del train; la imputacion calcula sus valores con el train; el encoder fija sus categorias con el train. Validation y test reciben esas transformaciones ya cerradas, sin participar en su calculo.

    Con datos que tienen componente temporal, el cuidado debe ser aun mayor. Mezclar aleatoriamente filas que tienen un orden cronologico permite al modelo acceder a informacion del futuro para predecir el pasado, algo imposible en produccion. Aqui la division debe respetar el orden temporal: entrenas con el pasado y validas con el futuro, nunca al reves.

    Hay tambien fugas mas sutiles, que no se resuelven solo ordenando el pipeline. La pregunta clave es: cada feature que uso, estaria realmente disponible en el momento de hacer la prediccion? Una variable que se rellena despues del evento que intentamos predecir es una bomba de relojeria. Revisar feature por feature su disponibilidad temporal real es tedioso, pero es lo que separa un modelo honesto de uno que se enganara a si mismo.

    Como pueden aplicar esto los equipos hoy

    Lo primero y mas barato: encapsular todo el preprocesado dentro de un pipeline que se ajuste solo con el conjunto de entrenamiento. Herramientas como los Pipeline de scikit-learn estan disenadas justo para esto, y eliminan de un plumazo la mayoria de fugas por transformacion prematura. Si tu codigo hace fit del escalador antes del split, ya tienes un problema.

    Segundo, montar una checklist de revision de features que incluya una sola pregunta por variable: estaria disponible en el momento exacto de la prediccion? Esto evita la fuga de datos mas dificil de detectar, la que ningun split arregla. En proyectos con series temporales, usa validacion con corte cronologico y desconfia de cualquier metrica que parezca demasiado buena.

    En cuanto al ROI, el calculo es directo: el coste de prevenir una fuga es unas horas de revision de pipeline; el coste de no hacerlo es desplegar un modelo que rinde la mitad de lo prometido y perder la confianza del negocio. Que evitar: prisas en la fase de validacion, copiar codigo de notebooks de ejemplo sin entender el orden de operaciones, y aceptar metricas espectaculares sin preguntarte por que lo son.

    Analisis Blixel

    Conviene desconfiar de las metricas demasiado redondas. Cuando un modelo presenta una precision casi perfecta en validacion, lo sano no es celebrarlo sino sospechar. En la inmensa mayoria de los casos que hemos visto, ese numero brillante esconde informacion que se ha colado donde no debia. El problema de fondo es cultural, no tecnico: muchos equipos optimizan la metrica de validacion como si fuera el objetivo final, cuando solo es un proxy imperfecto del rendimiento real en produccion.

    Lo interesante es que prevenir estas fugas no requiere infraestructura cara ni perfiles ultra especializados. Requiere disciplina de proceso y un poco de paranoia sana. Una PYME con un solo data scientist puede hacerlo igual de bien que un gran equipo, siempre que interiorice el orden correcto: dividir, ajustar con train, aplicar al resto, y revisar la disponibilidad temporal de cada feature. Es mas cuestion de metodo que de presupuesto.

    Donde si vemos margen de mejora es en la automatizacion de estas comprobaciones. Demasiadas organizaciones dependen de que un humano se acuerde de revisar el pipeline. Integrar tests automaticos que detecten fit sobre el dataset completo, o validaciones de coherencia temporal en el CI, convierte la buena practica en algo que no depende de la memoria de nadie. Ese es el siguiente paso de madurez para cualquier equipo que se tome en serio sus modelos.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Amazon prueba Alexa+ en India con soporte para hindi

    Amazon prueba Alexa+ en India con soporte para hindi

    El soporte para hindi en Alexa+ ya está en pruebas: Amazon ha empezado a enviar invitaciones por email a usuarios de India para unirse a un programa beta de su asistente conversacional con IA generativa antes del 22 de junio. El movimiento apunta a un mercado de más de 600 millones de hablantes de hindi, un público que rara vez habla en un solo idioma. La novedad no es solo geográfica: pone a prueba si un asistente de IA generativa puede manejar conversaciones reales donde el hindi y el inglés se mezclan en la misma frase.

    Que ha pasado y por que importa

    Amazon está probando el soporte para hindi en Alexa+ en India mediante un programa beta cerrado. Según la información disponible, la compañía envía invitaciones por correo electrónico para que los usuarios se unan antes del 22 de junio. Alexa+ es la versión renovada del asistente, construida sobre IA generativa, que Amazon anunció en 2025 y que llegó a todos los usuarios de Estados Unidos en febrero de 2026. La incorporación del hindi es el primer paso documentado de su expansión a mercados no angloparlantes.

    India no es un territorio nuevo para Amazon en este terreno. La empresa lanzó Alexa con inglés en el país en 2017 y añadió compatibilidad con hindi en 2019. Lo que cambia ahora es la base tecnológica: Alexa+ no funciona con comandos predefinidos, sino con modelos generativos que entienden lenguaje natural. El reto es que los hablantes de hindi suelen mezclar su idioma con el inglés dentro de una misma conversación, un patrón conocido como code-switching que los sistemas anteriores gestionaban con dificultad.

    Implicaciones tecnicas de la IA conversacional multilingue

    El soporte para hindi en Alexa+ es un caso práctico de uno de los problemas más difíciles de la IA conversacional: el manejo del code-switching. No basta con que el modelo entienda hindi e inglés por separado; tiene que reconocer cuándo el usuario salta de uno a otro a mitad de frase, mantener el contexto y responder de forma coherente. Esto exige datos de entrenamiento que reflejen el habla real, no transcripciones limpias de un solo idioma.

    Para Amazon, India funciona como banco de pruebas de hasta qué punto Alexa+ puede generalizar más allá del inglés estadounidense. El reconocimiento de voz con acentos regionales, las variaciones dialectales y la mezcla de idiomas son obstáculos que un asistente basado en reglas no resolvía bien. Un sistema de IA generativa multilingüe tiene más margen, pero también más riesgo de errores impredecibles. La fase beta cerrada sugiere que Amazon prioriza recoger ejemplos reales de conversación antes de un despliegue amplio, una estrategia razonable cuando el producto depende de cómo habla la gente y no de un guion fijo.

    La leccion para empresas: el code-switching no es un caso borde

    Cualquier empresa española que despliegue un asistente o chatbot de IA conversacional para clientes hará bien en fijarse en este detalle. Aquí no se mezcla hindi con inglés, pero sí ocurre con catalán, gallego, euskera y castellano, y con anglicismos constantes en sectores técnicos. Tratar la mezcla de idiomas como un caso raro es un error: para buena parte de los usuarios es la forma normal de hablar.

    La acción concreta: al evaluar un proveedor de IA conversacional, prueba el sistema con conversaciones reales mezcladas, no con frases de manual en un solo idioma. Mide cómo responde cuando el usuario cambia de lengua a media frase o usa términos en inglés. Antes de invertir, ejecuta una beta cerrada con clientes reales, como hace Amazon, en lugar de lanzar directamente a toda la base. Lo que debes evitar es asumir que un modelo entrenado mayoritariamente en inglés rendirá igual en tu idioma o en mezclas: el rendimiento puede caer de forma notable y solo lo detectarás probándolo con datos que se parezcan a tus usuarios.

    Analisis Blixel

    Que una multinacional empiece por India y no por un mercado europeo dice mucho sobre dónde está el valor: el idioma deja de ser un detalle de localización para convertirse en el verdadero campo de batalla de los asistentes de IA. El inglés estaba resuelto; lo difícil es todo lo demás. Y el hindi, con su mezcla habitual con el inglés, es precisamente el tipo de problema sucio que distingue una demo pulida de un producto que funciona en la calle.

    Para las PYMEs españolas el mensaje es práctico. La tentación de adoptar el primer chatbot que entiende bien el inglés en una demo es alta, pero el rendimiento real depende de cómo hablan tus clientes, no de cómo habla un guion. España es un país plurilingüe y con anglicismos por todas partes; un asistente que tropieza al mezclar idiomas genera fricción justo donde querías reducirla. La estrategia de Amazon —beta cerrada, recogida de conversaciones reales, despliegue gradual— no es exclusiva de gigantes: es exactamente lo que debería hacer cualquier empresa antes de poner una IA conversacional frente a sus clientes. La diferencia es de escala, no de método. Conviene desconfiar de las promesas de soporte multilingüe que no se han probado con habla real, y exigir métricas sobre code-switching concretas antes de firmar nada. El idioma es donde estos sistemas se rompen, y donde se gana o se pierde la confianza del usuario.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Ampersend deja que los agentes IA paguen solos

    Ampersend deja que los agentes IA paguen solos

    Los pagos autonomos para agentes IA dejan de ser teoria con el sistema de Ampersend, que ha construido una capa de enrutamiento sobre Amazon Bedrock AgentCore Payments para que un agente pague por si mismo el acceso a modelos de lenguaje. Hasta ahora, cualquier equipo que quisiera dar a un agente la capacidad de contratar y pagar servicios externos tenia que montar su propia facturacion, gestion de credenciales y orquestacion. Ampersend resuelve ese trabajo de fontaneria con una arquitectura concreta basada en el protocolo x402 y liquidacion en USDC sobre la red Base.

    Que ha pasado y por que importa

    Ampersend ha desarrollado una capa de enrutamiento que permite a los agentes IA pagar automaticamente por servicios de modelos de lenguaje. El sistema se apoya en Amazon Bedrock AgentCore Payments y en el protocolo x402, un estandar de pagos pensado para transacciones entre maquinas. La pieza clave es que los pagos autonomos para agentes IA dejan de exigir que cada desarrollador construya desde cero la facturacion, la gestion de credenciales y la orquestacion de pagos.

    El diseno usa un patron de pago de dos saltos. En el primer salto, el agente paga a Ampersend con presupuestos limitados a 0,05 dolares por sesion. En el segundo, Ampersend liquida de forma automatica con proveedores upstream como BlockRun, utilizando USDC en la red Base. Ese tope por sesion es relevante: acota el gasto y reduce el riesgo de que un agente descontrolado vacie un presupuesto.

    El contexto ayuda a entender el movimiento. El sector lleva meses hablando de agentes que actuan de forma autonoma, pero casi siempre chocan con un muro practico: no pueden pagar nada por si mismos. Sin una via de pago maquina a maquina, un agente depende de credenciales humanas y limites manuales. Resolver ese cuello de botella es lo que hace interesante esta propuesta.

    Implicaciones tecnicas de los pagos autonomos para agentes IA

    Tecnicamente, la propuesta separa dos responsabilidades que antes se mezclaban. El agente solo necesita saber que dispone de un presupuesto y de un endpoint que cobra mediante x402; no tiene que conocer las cuentas, claves ni contratos con cada proveedor upstream. Esa abstraccion es la que convierte los pagos autonomos para agentes IA en algo manejable: la complejidad de liquidacion queda encapsulada en la capa de enrutamiento de Ampersend.

    El uso de USDC sobre la red Base apunta a transacciones de bajo importe y baja friccion. Cuando hablamos de presupuestos de 0,05 dolares por sesion, los modelos de pago tradicionales con tarjetas y comisiones fijas no encajan; las microtransacciones en stablecoin tienen mas sentido para liquidar consumos pequenos y frecuentes entre servicios.

    El patron de dos saltos tambien tiene una lectura de control. Al interponerse entre el agente y el proveedor final, Ampersend puede aplicar limites, registrar consumo y cortar el flujo si algo se sale de presupuesto. Para equipos que temen entregar capacidad de gasto a un sistema autonomo, esa intermediacion con tope explicito por sesion es un mecanismo de contencion que reduce parte del riesgo operativo.

    Como pueden aplicar esto las empresas hoy

    Si tu equipo ya esta experimentando con agentes sobre Amazon Bedrock, lo accionable aqui es evitar construir tu propia tuberia de pagos cuando existe una capa que la encapsula. Antes de adoptarla, evalua tres cosas: el volumen real de transacciones que vas a generar, si el modelo de microtransacciones en USDC encaja con tu contabilidad, y como vas a auditar el gasto de cada agente. El tope de 0,05 dolares por sesion es un buen punto de partida para pruebas controladas sin exponerte a sustos.

    Que evitar: lanzar agentes con capacidad de pago a produccion sin limites claros ni trazabilidad. El atractivo de los pagos autonomos para agentes IA es tambien su riesgo, porque delega decisiones de gasto en software. Empieza con presupuestos minimos, un solo proveedor upstream y registros completos de cada liquidacion. Sobre ROI, el calculo no esta en ahorrar el coste de los modelos, sino en el tiempo de ingenieria que te ahorras al no construir facturacion, credenciales y orquestacion. Para una PYME con un equipo pequeno, ese ahorro de semanas de desarrollo es la variable que de verdad mueve la balanza.

    Analisis Blixel

    Delegar dinero a un programa siempre da vertigo, y con razon. La idea de que un agente contrate y pague servicios sin intervencion humana suena bien en una demo y mal a las tres de la madrugada cuando algo entra en bucle. Por eso lo que mas nos convence de esta arquitectura no es la promesa de autonomia, sino el tope de 0,05 dolares por sesion y la intermediacion en dos saltos. Esos limites son lo que separa un experimento responsable de una factura sorpresa.

    Dicho esto, conviene no confundir disponibilidad tecnica con madurez. Que se pueda montar un flujo de pago maquina a maquina no significa que la mayoria de empresas lo necesiten ya. El caso de uso real hoy es estrecho: agentes que consumen modelos o servicios de terceros de forma intensiva y donde montar la facturacion a mano no compensa. Para todo lo demas, sigue siendo prematuro.

    El uso de stablecoin sobre Base es coherente con microtransacciones, pero anade una capa cripto que muchos equipos financieros de PYME no querran tocar todavia por cuestiones contables y regulatorias. Nuestra recomendacion es clara: si encaja en tu caso, pruebalo en un entorno acotado, con un solo proveedor y registros exhaustivos. Trata la autonomia de pago como una funcion peligrosa que se activa poco a poco, no como un interruptor general. La infraestructura esta; el sentido comun para usarla lo pones tu.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Buscar en imagenes aereas a escala con IA multimodal

    Buscar en imagenes aereas a escala con IA multimodal

    La busqueda en imagenes aereas con IA multimodal acaba de dar un salto practico: una nueva tecnologia permite rastrear grandes volumenes de fotografia satelital y aerea por su contenido visual, no por etiquetas manuales. En lugar de revisar miles de mosaicos uno a uno, un equipo puede pedir «paneles solares en tejados industriales» o «zonas inundadas tras una crecida» y obtener resultados ordenados por relevancia. La propuesta combina procesamiento de imagen satelital con motores de busqueda avanzada y abre la puerta a un analisis geoespacial a gran escala que hasta ahora exigia equipos especializados y semanas de trabajo.

    Que ha pasado y por que importa

    Se ha presentado una tecnologia de IA multimodal disenada para hacer buscables enormes catalogos de imagenes aereas y satelitales. El nucleo del sistema es la capacidad de indexar el contenido visual de cada imagen y permitir consultas eficientes sobre ese contenido a escala. Es decir, no se busca por nombre de archivo ni por coordenadas, sino por lo que aparece en la propia escena. Eso convierte la busqueda en imagenes aereas con IA multimodal en una herramienta operativa para encontrar patrones concretos dentro de coberturas de territorio inmensas.

    La diferencia frente al enfoque tradicional es notable. El analisis geoespacial clasico se apoyaba en etiquetado manual, reglas de clasificacion rigidas o modelos entrenados para una unica categoria. Aqui el planteamiento es mas flexible: el mismo indice sirve para consultas distintas sin reentrenar desde cero cada vez. Para sectores que dependen de teledeteccion (agricultura, seguros, gestion de catastrofes, urbanismo o energia) el cuello de botella nunca fue capturar imagenes, sino encontrar la informacion util dentro de ellas. Ahi es donde esta tecnologia ataca el problema real.

    Implicaciones tecnicas de la busqueda en imagenes aereas con IA multimodal

    Tecnicamente, hacer buscable la fotografia aerea a escala obliga a resolver dos retos a la vez: representar el contenido de cada imagen de forma comparable y consultar ese espacio de representaciones de manera eficiente sobre millones de elementos. La combinacion de procesamiento de imagen satelital con capacidades de busqueda avanzada apunta a un esquema donde las imagenes se convierten en representaciones que se pueden recuperar por similitud, lo que permite responder consultas sin recorrer el archivo entero cada vez.

    El caracter multimodal es lo que aporta versatilidad. Que el sistema entienda tanto imagen como otras modalidades de consulta significa que un usuario puede expresar lo que busca sin redibujar una mascara ni programar un detector especifico. Para el analisis geoespacial a gran escala esto reduce la dependencia de pipelines a medida y de personal con conocimiento profundo de teledeteccion. La busqueda en imagenes aereas con IA multimodal se acerca asi al modo en que ya buscamos texto: describes lo que necesitas y el sistema devuelve coincidencias relevantes en lugar de un volcado completo de datos.

    Como pueden aplicar esto las empresas hoy

    Antes de plantearse adoptar la busqueda en imagenes aereas con IA multimodal, conviene tener claro el caso de uso. Tiene sentido directo para aseguradoras que valoran danos tras un evento climatico, empresas de energia que inventarian instalaciones solares o eolicas, consultoras de urbanismo que detectan cambios de uso del suelo o agrotech que monitoriza parcelas. Si tu negocio ya compra imagenes satelitales y las revisa a mano, el ROI es facil de estimar: cuenta las horas que dedica tu equipo a localizar lo que importa y comparalas con una consulta automatizada.

    Que evitar: no compres capacidad de analisis geoespacial sin un volumen de imagenes que lo justifique, porque a baja escala el coste de integracion no compensa. Empieza con un piloto acotado a una region y a una pregunta concreta, mide precision sobre un conjunto que ya conozcas y solo entonces amplia. Y no confundas «buscable» con «infalible»: estos sistemas devuelven candidatos por relevancia, asi que para decisiones criticas necesitas una validacion humana sobre los resultados antes de actuar.

    Analisis Blixel

    El verdadero valor de esta clase de herramientas no esta en la imagen, sino en la pregunta. Durante anos el sector geoespacial ha presumido de cobertura: petabytes de territorio capturados cada dia. Pero capturar nunca fue el problema; el problema era que casi nadie podia interrogar ese archivo sin un equipo de teledeteccion detras. Que ahora se pueda consultar por contenido cambia quien tiene acceso a la informacion, y eso suele importar mas que cualquier metrica de rendimiento.

    Dicho esto, hay que ser realista. La promesa de «busca cualquier cosa en cualquier imagen» choca con la fisica de los datos: resolucion limitada, nubes, sombras, escenas ambiguas. Un sistema asi acertara mucho en lo evidente y fallara justo en los casos raros, que a menudo son los que de verdad interesan. Para una PYME que evalua adoptarlo, la pregunta honesta no es si la tecnologia funciona, sino si el problema de negocio justifica pagar por consultar imagenes en lugar de seguir con un proveedor que entrega informes ya cocinados.

    Nuestra recomendacion es pragmatica: trata esto como un buscador, no como un oraculo. Sirve para reducir un archivo enorme a un punado de candidatos relevantes en minutos, y eso ya es un ahorro tangible. Lo que decidas hacer con esos candidatos sigue siendo trabajo humano, y conviene que lo siga siendo mientras la precision no este verificada en tu propio dominio.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Docomo confia en Nokia para automatizar su red con IA

    Docomo confia en Nokia para automatizar su red con IA

    La automatizacion de red con IA acaba de sumar un aval de peso: NTT Docomo, el mayor operador movil de Japon, ha activado una plataforma de Nokia desplegada en nube publica que utiliza inteligencia artificial para optimizar la calidad de su red. El movimiento confirma una tendencia clara en el sector de las telecomunicaciones, donde los operadores buscan reducir la intervencion manual en la gestion del trafico y la cobertura. No es un experimento aislado, sino otro paso de Docomo en una estrategia de automatizacion sostenida que ahora apuesta por software de proveedor sobre infraestructura cloud en lugar de desarrollos internos cerrados.

    Que ha pasado y por que importa

    NTT Docomo ha puesto en marcha una plataforma de Nokia que se ejecuta en la nube publica y que aplica inteligencia artificial para optimizar la calidad de la red. El objetivo declarado es avanzar en la automatizacion de las operaciones, una linea de trabajo que el operador japones ya venia explorando. Al elegir una solucion de Nokia desplegada en cloud en lugar de mantener todo el control sobre hardware propio, Docomo opta por un modelo mas flexible y escalable para la gestion de su red.

    El detalle relevante es doble. Por un lado, la automatizacion de red con IA pasa de ser un argumento de marketing a una implantacion real en uno de los operadores mas exigentes del mundo, con decenas de millones de clientes. Por otro, la eleccion de la nube publica como base de ejecucion marca distancia con el enfoque tradicional de las telcos, que durante decadas han preferido infraestructura propietaria y aislada por motivos de control y latencia. Que un operador del tamano de Docomo confie su optimizacion de red a una plataforma cloud de un proveedor externo envia una senal al resto del sector.

    Implicaciones tecnicas y de mercado

    La automatizacion de red con IA en este contexto persigue ajustar parametros de cobertura, capacidad y calidad de servicio de forma continua, sin que un equipo humano tenga que intervenir en cada cambio de carga o incidencia. Las redes moviles actuales generan un volumen de telemetria que ningun equipo puede procesar manualmente en tiempo util, y ahi es donde los modelos de IA aportan valor: detectan patrones, anticipan degradaciones y reconfiguran recursos antes de que el usuario note una caida de servicio. Ejecutar todo esto en nube publica reduce la necesidad de provisionar hardware especifico y permite escalar capacidad de computo segun demanda.

    Para el mercado, el acuerdo refuerza a Nokia en un segmento donde compite por demostrar que su software de automatizacion es competitivo frente a rivales como Ericsson y a las propuestas de los hyperscalers. Ganar a un cliente de referencia como Docomo tiene valor comercial mas alla del contrato concreto: funciona como caso de uso verificable. Para los operadores que aun dudan entre desarrollo interno y software de proveedor, este despliegue inclina la balanza hacia la externalizacion controlada de la inteligencia de red.

    Que significa este movimiento para el mercado

    Para los competidores de Nokia, perder o ganar contratos de automatizacion de red con IA en operadores tier 1 marca la diferencia entre liderar o quedar relegado en la proxima decada de redes. Ericsson, Samsung y los proveedores cloud que empujan hacia el RAN abierto observan de cerca: cada despliegue de referencia condiciona las decisiones de compra del resto del sector. Para los proveedores cloud, que un operador del peso de Docomo ejecute funciones criticas de red en nube publica valida un mercado que las telcos habian resistido durante anos por motivos de control y soberania de datos.

    Para los compradores —el resto de operadores— el mensaje es que la automatizacion deja de ser un proyecto experimental para convertirse en una decision de aprovisionamiento concreta, con proveedor, modelo de despliegue y caso de referencia. Quien evalue una migracion similar debe vigilar la dependencia de proveedor, los costes recurrentes del modelo cloud frente al CAPEX tradicional y la portabilidad de los datos de telemetria. La pregunta ya no es si automatizar la red con IA, sino con quien y bajo que condiciones contractuales.

    Analisis Blixel

    Conviene leer este anuncio sin el entusiasmo habitual del sector. Que un operador japones de primer nivel mueva la optimizacion de su red a una plataforma de un proveedor en nube publica es, sobre todo, una declaracion de confianza en un modelo que las telcos llevaban anos resistiendo. El detalle que merece atencion no es la IA en si —llevan tiempo prometiendola— sino la decision de ejecutarla fuera del perimetro propio. Eso implica aceptar cierta dependencia de Nokia y del proveedor cloud a cambio de flexibilidad y escalado. Es un trade-off legitimo, pero no gratuito.

    La puntuacion de calidad de esta noticia es moderada por una razon: el anuncio describe la activacion de una plataforma, no resultados medidos. No hay cifras publicas de mejora de calidad, ahorro operativo ni reduccion de incidencias. Hasta que esos datos aparezcan, lo prudente es tratarlo como una apuesta estrategica con potencial, no como una victoria consumada. Para cualquier empresa que observe estos movimientos como termometro del mercado, la leccion es clara: la externalizacion de inteligencia operativa hacia proveedores cloud avanza incluso en sectores conservadores. Quien dependa de redes o infraestructura critica hara bien en empezar a evaluar que partes de su operacion puede automatizar con software de terceros y cuales conviene mantener bajo control directo. La direccion del sector esta marcada; la velocidad y las condiciones son lo que cada organizacion debe negociar.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.