
Categoría: IA Aplicada

  • Shopify deja que los agentes de IA paguen solos

    Shopify deja que los agentes de IA paguen solos

    Los agentes de IA basados en navegador ya pueden completar compras de principio a fin en las tiendas Shopify, no solo buscar productos y llenar el carrito. La plataforma ha abierto el ultimo tramo del proceso, el pago, a los asistentes automatizados que actuan en nombre de un comprador. El movimiento llega mientras otros grandes retailers cierran esa puerta, y coloca a Shopify en el lado opuesto del debate sobre hasta donde debe llegar la automatizacion en el comercio online. Para las tiendas que venden con esta plataforma, cambia una parte concreta de como los clientes, humanos o no, cierran una transaccion.

    Que ha pasado y por que importa

    Shopify ha habilitado que los agentes de IA basados en navegador puedan completar compras en las tiendas de sus comerciantes, superando la limitacion anterior en la que estos asistentes solo podian buscar articulos y anadirlos al carrito. La novedad se apoya en tres herramientas nuevas: get_checkout, update_checkout y complete_checkout. La primera permite al agente inspeccionar el estado del pedido, la segunda modificarlo y la tercera finalizarlo. Cada finalizacion requiere autorizacion del comprador, de modo que la compra no se cierra sin una senal explicita de la persona que esta detras del agente.

    El contexto es lo que da peso al anuncio. Mientras Shopify abre la fase de pago a los agentes, otros retailers como Amazon bloquean activamente que estos completen transacciones en sus plataformas. Esa diferencia de criterio convierte la decision en algo mas que una funcion tecnica: define a Shopify como plataforma abierta al comercio automatizado en un momento en que el resto del sector todavia no ha decidido su postura. Para los comercios, significa que las compras iniciadas por un agente dejan de quedarse a medias en el carrito y pueden completarse dentro del propio flujo de la tienda.

    Implicaciones tecnicas del checkout para agentes

    Que los agentes de IA puedan completar compras mediante get_checkout, update_checkout y complete_checkout no es un detalle menor de implementacion. Separar la operacion en inspeccionar, modificar y finalizar da al desarrollador control granular sobre cada paso del pedido. Un agente puede leer el estado del checkout, ajustar cantidades o datos de envio y solo entonces cerrar la compra, en lugar de disparar una accion opaca de todo o nada. Ese diseno reduce el riesgo de pedidos erroneos y facilita auditar que hizo el agente en cada fase.

    La exigencia de autorizacion del comprador en el paso final es la pieza de seguridad que sostiene todo el sistema. Sin ella, un agente con acceso a metodos de pago podria cerrar compras sin supervision, con el consiguiente problema de confianza y de responsabilidad. Al mantener a la persona en el circuito para el ultimo clic, Shopify traslada la decision de compra a quien asume el gasto, mientras deja al agente el trabajo repetitivo de comparar, configurar y preparar el pedido. Para los equipos tecnicos que ya trabajan con agentes en el navegador, estas tres herramientas ofrecen puntos de integracion claros sobre los que construir automatizaciones de compra sin reinventar el flujo de pago de cada tienda.

    Como pueden aplicar esto las empresas hoy

    Si vendes en Shopify, lo primero es entender que tu tienda pasa a ser accesible para compradores que operan a traves de un agente, no solo para personas navegando a mano. Conviene revisar que la ficha de producto, el stock y las opciones de envio esten bien estructurados, porque un agente que usa get_checkout y update_checkout dependera de datos limpios para no cometer errores en el pedido. Merece la pena probar el flujo completo con un agente de navegador antes de asumir que funciona sin friccion. En el lado de compras B2B, la posibilidad de que un agente de IA complete compras recurrentes de forma automatizada puede reducir tiempo en reaprovisionamientos rutinarios, siempre con la autorizacion final como control de gasto. Lo que conviene evitar es delegar decisiones de compra sensibles sin definir limites claros de importe y de que puede cerrar el agente por su cuenta. El valor real esta en automatizar lo repetitivo, no en quitar a la persona del control sobre lo que paga.

    Analisis Blixel

    Abrir el pago a los asistentes automatizados no es una funcion mas: es una apuesta de plataforma sobre hacia donde va el comercio online. Shopify decide que prefiere ser el sitio donde los agentes pueden operar de verdad, y no solo mirar escaparates, justo cuando Amazon opta por lo contrario. Esa divergencia dice mucho. Quien controla la infraestructura de compra tiene interes en que las transacciones ocurran dentro de su terreno, y permitir agentes es una forma de no quedarse fuera cuando cada vez mas gente delegue tareas de compra en software. El diseno con tres herramientas separadas y autorizacion humana al final es sensato: reparte el trabajo tedioso a la maquina y guarda la decision economica para la persona. El riesgo no esta en la tecnologia, sino en la prisa de quienes automaticen compras sin poner limites de gasto ni revisar los datos que consume el agente. Para un comercio, la pregunta util no es si esto es el futuro, sino si sus clientes ya usan agentes y si su tienda esta lista para atenderlos sin fallos en el pedido. La mayoria todavia no lo esta, y ese es el trabajo real de los proximos meses: datos ordenados, pruebas del flujo completo y reglas claras sobre que puede cerrar un agente. Quien lo prepare bien llegara antes que la competencia a una demanda que aun es minoritaria pero crece.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • vLLM-Omni lleva la voz en tiempo real a SageMaker

    vLLM-Omni lleva la voz en tiempo real a SageMaker

    Las aplicaciones de voz en tiempo real han sido durante anos un dolor de cabeza tecnico: latencia alta, arquitecturas fragiles y una factura de infraestructura que asusta. Amazon acaba de mover ficha con vLLM-Omni, una extension del framework vLLM que corre sobre SageMaker AI y permite desplegar modelos multimodales capaces de procesar voz sin que la empresa tenga que montar y mantener su propio stack de inferencia. La promesa es directa: menos plomeria, mas producto. En esta primera parte de la serie, Amazon detalla el enfoque y como encaja en un flujo de trabajo real.

    Que ha pasado y por que importa

    Amazon ha presentado vLLM-Omni, una extension del popular framework vLLM orientada a desarrollar aplicaciones de voz en tiempo real mediante modelos multimodales dentro de SageMaker AI. vLLM es conocido por optimizar la inferencia de modelos de lenguaje de gran escala, y esta variante amplia ese trabajo hacia cargas que combinan texto y audio. La idea central es que las empresas puedan integrar procesamiento de voz avanzado en sus productos sin construir ni operar una infraestructura de inferencia compleja por su cuenta.

    El contexto ayuda a entender el movimiento. vLLM se ha convertido en una de las capas de inferencia mas usadas por su rendimiento y su manejo eficiente de memoria en GPU. Al portar ese enfoque a un servicio gestionado como SageMaker AI, Amazon reduce la barrera de entrada para equipos que quieren capacidades de voz pero no tienen especialistas en MLOps. Que Amazon lo publique como una serie por partes indica que hay materia tecnica suficiente y que las aplicaciones de voz en tiempo real dejan de ser un proyecto de laboratorio para convertirse en algo desplegable.

    Implicaciones tecnicas para desarrolladores

    Para un equipo de desarrollo, lo relevante de las aplicaciones de voz en tiempo real es la latencia extremo a extremo. Al apoyarse en vLLM, vLLM-Omni hereda las optimizaciones de inferencia que hacen viable responder con la rapidez que exige una conversacion natural. Correr sobre SageMaker AI aporta el resto: aprovisionamiento gestionado, escalado y una operacion que no depende de que alguien del equipo vigile GPUs a las tres de la madrugada.

    El uso de modelos multimodales es el segundo punto clave. En lugar de encadenar un sistema de transcripcion, un LLM y un sintetizador de voz como piezas separadas, un modelo multimodal puede reducir saltos entre componentes, y con ello latencia y puntos de fallo. Esto no elimina la complejidad, pero la concentra en un unico servicio gestionado. Para los equipos que ya trabajan con vLLM en local, la curva de aprendizaje es mas suave: los conceptos de inferencia se mantienen y el salto principal es operativo. Las aplicaciones de voz en tiempo real construidas asi encajan en asistentes de atencion, agentes telefonicos y herramientas de accesibilidad.

    Como pueden aplicar esto las empresas hoy

    Antes de lanzarse, conviene delimitar el caso de uso. Las aplicaciones de voz en tiempo real tienen sentido cuando la interaccion por voz aporta valor medible: reducir tiempo de atencion telefonica, automatizar respuestas repetitivas o mejorar accesibilidad. Si el caso se resuelve con un chat de texto, la voz solo anade coste. El primer paso practico es un piloto acotado: un flujo concreto, un volumen limitado de llamadas y metricas claras de latencia y satisfaccion.

    En terminos de ROI, la ventaja de SageMaker AI es no invertir de entrada en hardware ni en un equipo de MLOps dedicado; se paga por el uso del servicio gestionado. Aun asi, hay que vigilar el coste de inferencia a escala, que puede dispararse con volumenes altos de audio. Que evitar: desplegar directamente a produccion sin medir latencia real con usuarios, y subestimar el trabajo de integracion con los sistemas de telefonia o CRM existentes. Para una PYME, empezar con vLLM-Omni en un caso unico y bien acotado es mas sensato que intentar cubrir toda la atencion al cliente de golpe.

    Analisis Blixel

    El verdadero cuello de botella de la voz nunca fue el modelo, sino la operacion. Montar un pipeline de audio de baja latencia, mantenerlo estable y escalarlo sin que la factura de GPU se descontrole es lo que ha frenado a la mayoria de las empresas medianas. Por eso el valor de esta propuesta no esta tanto en el modelo multimodal como en trasladar la carga operativa a un servicio gestionado. Ahi es donde una PYME gana tiempo real.

    Dicho esto, conviene no confundir facilidad de despliegue con facilidad de exito. Que sea sencillo arrancar un endpoint no significa que la experiencia de voz sea buena: el diseno conversacional, el manejo de interrupciones y el comportamiento ante ruido siguen siendo trabajo humano y no vienen resueltos por el framework. Tambien queda por ver el coste real a escala, un punto que los servicios gestionados tienden a maquillar en los ejemplos iniciales. Nuestra recomendacion es tratar esto como lo que es: una capa de infraestructura solida que reduce riesgo tecnico, no una varita magica. Un piloto medido, con numeros de latencia y coste por interaccion sobre la mesa, dira mucho mas que cualquier demo. Si esos numeros cuadran, vLLM-Omni puede ser el atajo que muchas empresas esperaban para hacer voz sin convertirse en una empresa de infraestructura.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Nova Act automatiza el monitoreo sintetico en AWS

    Nova Act automatiza el monitoreo sintetico en AWS

    El monitoreo sintetico con Amazon Nova Act llega para automatizar una de las tareas mas repetitivas de cualquier equipo de desarrollo: comprobar que una aplicacion web funciona como debe, las veinticuatro horas, sin que nadie tenga que hacer clic manualmente. Amazon ha presentado Nova Act, un modelo de IA de su familia Nova capaz de simular interacciones reales de usuario sobre una web y detectar fallos antes de que lleguen al cliente. Se integra directamente con los servicios de AWS, lo que reduce la friccion para quienes ya trabajan en ese entorno.

    Que ha lanzado Amazon y por que importa

    Nova Act es un modelo de IA disenado para automatizar tareas de monitoreo sintetico en aplicaciones web. En lugar de scripts rigidos que hay que reescribir cada vez que cambia un boton o un flujo, el modelo simula el comportamiento de un usuario navegando por la interfaz: rellenar formularios, iniciar sesion, recorrer un checkout o verificar que una pagina carga correctamente. El monitoreo sintetico con Amazon Nova Act se orienta especialmente a equipos de desarrollo y DevOps que necesitan validar sus sistemas de forma continua sin intervencion manual.

    El modelo forma parte de la familia Nova de Amazon y se integra directamente con los servicios de AWS, de modo que la implementacion sobre infraestructuras ya existentes es mas sencilla. Para las organizaciones que operan en AWS, esto significa poder anadir capacidades de verificacion automatica sin montar una arquitectura paralela ni depender de herramientas externas. El monitoreo sintetico no es nuevo, pero apoyarlo en un modelo de IA capaz de interpretar la interfaz cambia la forma de mantener esos controles a lo largo del tiempo.

    Implicaciones tecnicas para equipos DevOps

    La diferencia practica del monitoreo sintetico con Amazon Nova Act frente a las soluciones tradicionales de synthetic monitoring esta en el mantenimiento. Los flujos basados en selectores CSS o XPath se rompen con cualquier rediseno; un modelo que interpreta la interaccion de usuario tolera mejor esos cambios de interfaz. Eso reduce el trabajo de mantenimiento de la suite de pruebas, que suele ser el coste oculto de cualquier estrategia de monitoreo continuo.

    La integracion nativa con AWS abre la puerta a encadenar el monitoreo con servicios de observabilidad, alarmas y pipelines de despliegue que muchos equipos ya tienen configurados. Un check sintetico que falla puede disparar una alerta o bloquear un despliegue automaticamente. Conviene, eso si, ser realista: cualquier herramienta basada en IA introduce variabilidad, y las validaciones criticas deben contrastarse para evitar falsos positivos. El monitoreo sintetico con Amazon Nova Act suma capacidad de automatizacion, pero no elimina la necesidad de definir bien que se considera un fallo y que umbrales de tolerancia acepta cada aplicacion.

    Como pueden aplicar esto las empresas hoy

    Para una PYME que ya opera en AWS, el primer paso sensato es identificar los flujos criticos de negocio: el login, el proceso de pago, el formulario de contacto o alta. Ahi es donde un fallo silencioso cuesta dinero, y donde el monitoreo sintetico con Amazon Nova Act aporta valor inmediato sin necesidad de cubrir toda la aplicacion. Empezar por dos o tres recorridos clave permite evaluar el ROI antes de ampliar la cobertura.

    En terminos de coste, hay que considerar el modelo de consumo de AWS y la frecuencia de ejecucion: un check cada pocos minutos multiplica el gasto frente a uno cada hora. Conviene calibrar esa frecuencia segun la criticidad real de cada flujo. Que evitar: intentar sustituir de golpe toda la bateria de pruebas manuales o de integracion. El monitoreo sintetico verifica que el sistema en produccion responde, no reemplaza los tests unitarios ni el QA funcional. Para equipos pequenos sin DevOps dedicado, empezar con un solo flujo bien definido y medir cuantos incidentes se detectan antes que el usuario es la mejor forma de justificar la inversion.

    Analisis Blixel

    Llevamos anos viendo como los equipos abandonan sus suites de pruebas end-to-end porque el mantenimiento se come cualquier beneficio: un rediseno menor rompe veinte scripts y nadie tiene tiempo de arreglarlos. Ahi es donde una herramienta que interpreta la interfaz en lugar de depender de selectores fragiles puede marcar una diferencia genuina, no cosmetica. Ese es el problema real que Amazon intenta atacar, y es un problema que merece la pena resolver.

    Dicho esto, hay que separar la promesa del despliegue real. La integracion nativa con AWS es una ventaja para quien ya vive en ese ecosistema, pero tambien un factor de dependencia que conviene tener presente antes de apoyar procesos criticos sobre un unico proveedor. Y la variabilidad propia de un modelo de IA obliga a disenar los checks con margen: un falso positivo que despierta al equipo de guardia a las tres de la manana erosiona la confianza en la herramienta mas rapido de lo que se tarda en configurarla. Nuestra recomendacion es pragmatica: probarlo en un flujo real, medir falsos positivos durante un par de semanas y decidir con datos. La automatizacion del monitoreo tiene sentido cuando reduce trabajo repetitivo sin anadir ruido. Si acaba generando mas alertas que incidentes reales, el problema no es la IA, es como se configuro. Empezar pequeno sigue siendo la estrategia mas sensata.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Google prueba comprar en Flipkart desde Gemini

    Google prueba comprar en Flipkart desde Gemini

    La opcion de comprar desde Gemini en India ya se esta probando: Google ha empezado a mostrar a algunos usuarios un boton de compra que conecta directamente con Flipkart, permitiendo llegar al checkout sin abandonar la interfaz de IA. La prueba, activa en Gemini y en AI Mode, marca un salto desde la simple busqueda de productos hacia la transaccion comercial completa. Por ahora se limita a categorias concretas como smartphones y electronica, con una expansion prevista para octubre, justo antes de la temporada festiva de compras en India, uno de los picos de consumo mas fuertes del mercado indio.

    Que ha pasado y por que importa

    Google esta probando una funcion que permite a un grupo reducido de usuarios en India comprar productos de Flipkart directamente desde Gemini y AI Mode. En lugar de limitarse a recomendar articulos o enlazar a resultados de busqueda, la interfaz muestra un boton de compra que lleva al proceso de pago sin salir del entorno conversacional. La prueba esta acotada a productos especificos, principalmente smartphones y electronica de consumo, y a una muestra limitada de usuarios.

    El movimiento importa porque cambia el rol del asistente: pasa de ser un buscador aumentado a un canal de venta. La opcion de comprar desde Gemini en India encaja en la estrategia de Google de extender sus servicios de IA mas alla de la busqueda hacia transacciones reales, un terreno donde compite de forma directa con OpenAI y sus capacidades de comercio electronico. India es un banco de pruebas logico: mercado enorme, adopcion movil masiva y una alianza con Flipkart, uno de los mayores operadores de e-commerce del pais.

    Implicaciones tecnicas y de mercado

    Integrar el checkout dentro de la conversacion obliga a resolver problemas que van mas alla del lenguaje. Comprar desde Gemini en India requiere conectar el catalogo de Flipkart, sincronizar precios y stock en tiempo real, gestionar pagos y mantener la trazabilidad del pedido, todo sin que el usuario perciba una ruptura entre la IA y la tienda. El reto no es que el modelo entienda la peticion, sino que la infraestructura comercial responda con fiabilidad.

    Para el mercado, el patron es claro: quien controle la capa donde se toma la decision de compra controla el margen. Si el usuario resuelve toda la operacion dentro del asistente, el trafico deja de pasar por buscadores tradicionales, comparadores y marketplaces por separado. Esto reordena la relacion entre plataformas de IA, retailers y pasarelas de pago. La opcion de comprar desde Gemini en India tambien presiona a competidores como OpenAI a acelerar sus propias integraciones de compra, convirtiendo el comercio conversacional en el nuevo campo de batalla tras la busqueda.

    Como pueden aplicar esto las empresas hoy

    Aunque la prueba de comprar desde Gemini en India es de Google y Flipkart, la leccion para una PYME con tienda online es concreta: los asistentes de IA empiezan a ser un canal de venta, no solo de consulta. Lo accionable ahora es asegurarse de que tu catalogo esta estructurado y accesible: feeds de producto limpios, precios y stock actualizados, y datos de producto legibles por maquinas. Sin eso, tu inventario no aparecera cuando estos canales se abran a mas comercios.

    Evita dos errores. El primero, invertir en integraciones cerradas antes de que existan APIs publicas estables; hoy esto es un piloto acotado, no un estandar. El segundo, descuidar la ficha de producto: descripciones claras, atributos completos y disponibilidad real son lo que un asistente necesita para recomendar y vender. La accion de ROI mas sensata a corto plazo es ordenar tus datos de producto y monitorizar como evolucionan estas integraciones antes de comprometer presupuesto en un canal que aun esta en fase de prueba.

    Analisis Blixel

    El verdadero cambio aqui no es tecnologico, es de poder. Cuando la decision de compra ocurre dentro del asistente, el retailer deja de ser el destino y pasa a ser el proveedor de un catalogo que otro controla. Flipkart gana visibilidad inmediata, si, pero cede el punto de contacto con el cliente justo donde se decide la conversion. Es un trato que puede compensar mientras la IA aporte trafico incremental, y volverse incomodo el dia que ese trafico dependa por completo de las reglas de Google.

    Que el piloto arranque en India y apunte a octubre no es casualidad: es un mercado donde probar rapido, con volumen y sin el escrutinio regulatorio que tendria en Europa. Para las empresas espanolas, la lectura util es de timing. Esto llegara, pero no manana ni con estas condiciones. Precipitarse a integrar cualquier cosa seria un error tan grande como ignorar la tendencia. Lo razonable es preparar la infraestructura de datos de producto ahora, porque esa inversion sirve para SEO, para feeds de shopping y para cualquier canal futuro, y esperar a que las reglas de juego se estabilicen. La pregunta que toda tienda deberia hacerse no es si vender dentro de un asistente, sino cuanto control esta dispuesta a ceder a cambio de aparecer donde el cliente ya esta preguntando.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Synthesia crea el primer avatar interactivo de una periodista

    Synthesia crea el primer avatar interactivo de una periodista

    El avatar digital interactivo de una periodista, capaz de responder preguntas en tiempo real sobre uno de sus articulos, es la ultima demostracion publica de Synthesia. La startup combino modelos de voz, texto y video para crear una representacion digital que sostiene una conversacion automatizada, sin guion cerrado. No es un video pregrabado: es una interfaz que escucha, procesa y contesta. La compania, valorada en 4.000 millones de dolares este ano, quiere llevar esta capacidad al terreno corporativo. Aqui separamos lo que ya funciona de lo que todavia es escaparate.

    Que ha pasado y por que importa

    Synthesia construyo el primer avatar digital interactivo de una periodista, entrenado especificamente para responder preguntas sobre un articulo concreto. La diferencia con sus productos anteriores es clave: hasta ahora Synthesia generaba videos donde un avatar leia un texto fijo. Ahora el avatar mantiene un intercambio bidireccional, integrando reconocimiento de voz, generacion de texto y sintesis de video sincronizada con el rostro y la voz del original.

    La empresa reporto mas de 100 millones de dolares en ingresos recurrentes anuales y alcanzo una valoracion de 4.000 millones este ano. Esas cifras situan a Synthesia entre los actores consolidados del video generado por IA, un segmento que hasta hace poco se veia como un experimento de laboratorio.

    El contexto ayuda a entender el movimiento. Synthesia nacio ofreciendo avatares para formacion interna y videos corporativos, un caso de uso comodo porque no exigia interaccion. El salto a la conversacion en tiempo real amplia el mercado potencial hacia atencion al cliente y soporte, terrenos donde la latencia y la coherencia de las respuestas dejan de ser un detalle y pasan a ser el producto entero.

    Implicaciones tecnicas del avatar digital interactivo

    Un avatar digital interactivo en tiempo real es un problema de orquestacion, no de un solo modelo. Hay que transcribir la voz del usuario, generar una respuesta textual coherente y limitada al dominio entrenado, convertirla en audio con la voz clonada y renderizar el video del rostro sincronizado con ese audio, todo con una latencia baja para que la conversacion no resulte incomoda. Cada eslabon anade retardo y cada retardo rompe la ilusion de dialogo natural.

    El detalle de que el avatar este entrenado para responder sobre un articulo concreto no es menor. Acota el dominio, reduce el riesgo de respuestas inventadas y hace el sistema evaluable. Un avatar de proposito general que responda cualquier cosa hereda todos los problemas de alucinacion de los modelos de lenguaje, ademas de ponerles cara y voz reconocibles, lo que agrava el impacto reputacional de un error.

    Para las empresas esto define el limite realista de hoy: el avatar digital interactivo funciona bien cuando el conocimiento esta acotado y verificado. Fuera de ese perimetro, la fiabilidad cae. La consecuencia practica es que estos sistemas encajan mejor como capa conversacional sobre una base de conocimiento cerrada que como sustituto de un experto humano abierto a cualquier pregunta.

    Como pueden aplicar esto las empresas hoy

    El caso mas maduro sigue siendo la formacion corporativa: un avatar que explica procedimientos internos y responde dudas sobre un manual concreto tiene el dominio acotado y bajo riesgo. El segundo candidato es la atencion al cliente de primer nivel, siempre que las respuestas se limiten a documentacion controlada y exista escalado a persona real. Antes de invertir, calcula el ROI comparando el coste por interaccion del avatar frente al del canal actual, incluyendo el trabajo de mantener actualizada la base de conocimiento, que no es gratis.

    Que evitar: desplegar un avatar digital interactivo sobre informacion que cambia a diario sin un proceso de actualizacion claro, o usar la cara de un empleado sin consentimiento explicito y por escrito sobre uso, duracion y revocacion. La clonacion de voz y rostro plantea cuestiones legales y laborales que conviene cerrar con el departamento juridico antes que con el proveedor. Empieza con un piloto medible en un caso acotado y decide con datos, no con la demo.

    Analisis Blixel

    Ponerle rostro y voz a una IA conversacional resuelve un problema de percepcion y crea otro de responsabilidad. Cuando quien responde es una cara humana reconocible, el usuario baja la guardia y otorga a la respuesta una credibilidad que un chatbot de texto nunca recibiria. Esa confianza es precisamente el riesgo: un error dicho por una persona convincente pesa mas que el mismo error escrito en un cuadro de chat gris.

    Por eso el enfoque de Synthesia de entrenar el avatar para un dominio cerrado nos parece el correcto, y tambien la senal de que la tecnologia todavia no esta lista para el uso abierto que promete el marketing. Los 100 millones en ingresos recurrentes confirman que hay mercado real en el video corporativo, no que la conversacion en tiempo real ya sea un producto masivo fiable.

    Para una PYME espanola el consejo es sobrio: esto no sustituye a tu equipo de soporte, lo complementa en las preguntas repetitivas y documentadas. El valor esta en liberar tiempo humano para lo que de verdad requiere criterio. Y hay una linea roja que no debe cruzarse por ahorro: clonar la imagen de un empleado exige consentimiento formal y reversible. La tecnologia impresiona; la gobernanza es lo que decidira si aporta o se convierte en un pasivo reputacional.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Meta lanza gafas para sordos por 150 dolares

    Meta lanza gafas para sordos por 150 dolares

    Las gafas inteligentes de Meta para discapacidad auditiva fueron una de las sorpresas del evento Connect 2026. La compania presento dos modelos distintos: unas gafas solo de audio, sin camara, pensadas para esquivar el debate sobre privacidad, y otras disenadas especificamente para amplificar el sonido a personas con perdida auditiva. El dato que llama la atencion es el precio: 150 dolares, frente a los hasta 1.600 dolares que puede costar un audifono convencional. Meta apuesta por acercar la accesibilidad a un rango de precio que hasta ahora era impensable en este mercado.

    Que ha presentado Meta y por que importa

    En Connect 2026, Meta mostro dos lineas de gafas inteligentes con enfoques muy diferentes. El primer modelo prescinde por completo de la camara e integra seis microfonos junto al agente de IA Muse. La ausencia de camara es una decision de diseno deliberada: elimina de raiz gran parte de la controversia sobre grabacion no consentida que ha perseguido a este tipo de dispositivos desde sus primeras versiones.

    El segundo modelo, el mas relevante en terminos sociales, esta pensado para personas con discapacidad auditiva. Amplifica el sonido del entorno y ofrece dos modos de escucha: enfoque direccional, para centrarse en una conversacion concreta, y omnidireccional, para captar todo el ambiente. Su precio de 150 dolares lo posiciona como una alternativa economica frente a los audifonos tradicionales, cuyo coste puede alcanzar los 1.600 dolares.

    El sector de los audifonos ha estado historicamente marcado por precios elevados y barreras de acceso. Que un fabricante de electronica de consumo entre con un producto a una fraccion del coste cambia las reglas del juego, aunque queda por ver si el rendimiento clinico esta a la altura de los dispositivos medicos homologados.

    Implicaciones tecnicas y de mercado

    El array de seis microfonos es la pieza clave de ambos productos. La captacion multimicrofono permite el beamforming, es decir, aislar y amplificar fuentes de sonido concretas segun su direccion. Esa misma tecnologia es la que habilita el modo de enfoque direccional en el modelo para discapacidad auditiva. La integracion del agente Muse anade una capa de procesamiento por IA que va mas alla de la simple amplificacion, aunque Meta no detallo el alcance exacto de sus funciones auditivas.

    La decision de lanzar unas gafas sin camara marca un giro estrategico. Meta reconoce implicitamente que la privacidad ha sido un freno a la adopcion. Al ofrecer un dispositivo centrado solo en audio, amplia el publico potencial a quienes rechazaban llevar una camara en la cara. Las gafas inteligentes para discapacidad auditiva, por su parte, entran en un terreno regulatorio delicado: dependiendo del mercado, los dispositivos de amplificacion auditiva pueden requerir certificaciones especificas si se comercializan como producto sanitario en lugar de electronica de consumo.

    Que lecciones deja para las empresas

    La leccion aqui no es superficial. Meta demuestra que el precio de referencia de un mercado no es intocable: un audifono no cuesta 1.600 dolares por una ley fisica, sino por la estructura del sector. Cuando entra un actor con escala y otra logica de costes, el suelo de precio se hunde. Para cualquier empresa que opere en un mercado con margenes historicamente altos y poca competencia tecnologica, esto es una advertencia concreta.

    La segunda leccion es de diseno de producto: eliminar la camara no fue un recorte, sino una respuesta directa a la objecion principal de los usuarios. Escuchar cual es la barrera real de adopcion y disenar el producto en torno a ella, aunque implique quitar funciones, suele funcionar mejor que anadir mas. Las gafas inteligentes para discapacidad auditiva tambien ensenan el valor de segmentar: en lugar de un producto para todos, Meta ha creado uno especifico para una necesidad clara y desatendida.

    Analisis Blixel

    Que un audifono pueda costar 150 dolares y no 1.600 no es un milagro tecnologico, es una cuestion de quien controla la cadena de valor. Durante decadas el sector auditivo ha vivido de margenes que poco tenian que ver con el coste real de los componentes. La entrada de Meta con hardware de consumo revienta esa ecuacion, y eso, en si mismo, es una buena noticia para millones de personas con perdida auditiva que nunca pudieron permitirse un dispositivo homologado.

    Dicho esto, conviene no confundir amplificacion con solucion clinica. Un audifono medico se ajusta a la curva audiometrica de cada persona; una gafa que amplifica sonido direccional es otra cosa. Habra que ver los datos reales de rendimiento antes de recomendarla como sustituto. Lo que si es innegable es el mensaje estrategico: el modelo sin camara admite abiertamente que la privacidad frenaba la adopcion de las gafas inteligentes, algo que Meta llevaba anos ignorando. Renunciar a la camara para ganar usuarios es una jugada mas madura de lo que parece. Para las PYMEs espanolas, el aprendizaje es doble: los precios de tu sector pueden no ser tan solidos como crees, y a veces el mejor producto es el que quita, no el que anade. Meta no ha inventado nada nuevo aqui, pero ha aplicado sentido comun a dos problemas viejos.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Meta abre el acceso anticipado a las novedades de Muse

    Meta abre el acceso anticipado a las novedades de Muse

    El programa de acceso anticipado de Muse ya esta en marcha. Meta ha abierto la puerta a quienes quieran probar antes que nadie las funciones que presento en Connect 2026 para su aplicacion de IA. La mecanica es sencilla: el usuario solicita el acceso mediante un prompt especifico dentro de la propia app. Con este movimiento, Meta busca recoger feedback rapido de los usuarios mas avanzados, esos que saltan entre varias aplicaciones y agentes, y usar esa informacion para afinar un producto que compite en un mercado cada vez mas saturado.

    Que ha anunciado Meta y por que importa

    El programa de acceso anticipado de Muse da entrada a un paquete de funciones nuevas presentadas en la conferencia Connect 2026. La primera es un avatar digital pensado para videollamadas, que permite proyectar una version generada por IA del usuario. La segunda son mas integraciones comerciales, orientadas a conectar la app con servicios y transacciones. La tercera es una expansion de la aplicacion para Mac, capaz de completar tareas directamente en el ordenador. Y la cuarta es la compatibilidad con las gafas de IA de Meta mediante comandos de voz, llevando el asistente fuera del movil y del escritorio.

    El detalle relevante no es solo el catalogo de funciones, sino la estrategia de despliegue. En lugar de un lanzamiento masivo, Meta prefiere una entrada escalonada. Los usuarios que soliciten el acceso anticipado suelen ser entusiastas de IA que ya prueban multiples herramientas, un perfil ideal para detectar fallos y comparar con la competencia. Ese feedback temprano ayuda a Meta a corregir antes de abrir el grifo al gran publico.

    Implicaciones tecnicas del acceso anticipado de Muse

    El programa de acceso anticipado de Muse revela hacia donde apunta Meta: un asistente que no vive en una sola pantalla. La expansion a Mac para completar tareas en el ordenador acerca a Muse al terreno de los agentes que operan sobre el sistema, no solo conversan. La compatibilidad por voz con las gafas de IA de Meta suma un canal manos libres que redefine cuando y como se usa el asistente. Juntas, estas piezas dibujan un producto multiplataforma: movil, escritorio y wearable bajo la misma capa de IA.

    El avatar digital para videollamadas y las nuevas integraciones comerciales apuntan a dos direcciones distintas. El primero explora la identidad visual generada por IA en comunicaciones en tiempo real, un terreno tecnicamente exigente por la latencia y el realismo. Las integraciones comerciales, en cambio, buscan que Muse se convierta en un punto de contacto para acciones con valor economico. Que Meta priorice el feedback de usuarios avanzados dentro del programa de acceso anticipado de Muse indica que aun quedan aristas por pulir antes del despliegue general.

    Como pueden aplicar esto las empresas hoy

    Para una empresa, el programa de acceso anticipado de Muse ofrece una via barata de exploracion: designar a una o dos personas para probar las funciones y evaluar si el avatar digital, la app de Mac o las gafas encajan en flujos reales. Antes de apostar recursos, conviene medir si la expansion a Mac para completar tareas ahorra tiempo tangible en operaciones repetitivas frente a herramientas ya instaladas. Cuidado con dos cosas: la dependencia de un ecosistema controlado por Meta y el manejo de datos en las integraciones comerciales, que exige revisar terminos y privacidad. El ROI no esta en adoptar todo, sino en identificar la funcion concreta que resuelve un cuello de botella real. Un programa en fase temprana implica cambios frecuentes y fallos, asi que no es momento de construir procesos criticos encima. Sirve para aprender y decidir, no para desplegar en produccion.

    Analisis Blixel

    Dar acceso primero a los usuarios que ya viven rodeados de agentes es una jugada calculada, no un gesto de generosidad. Esos perfiles detectan fallos que un usuario medio ignoraria y comparan al instante con la competencia, lo que convierte el feedback en un activo estrategico gratuito. Meta no esta regalando funciones: esta comprando informacion de calidad a cambio de exclusividad temporal.

    La parte interesante es la ambicion multiplataforma. Un asistente que salta del movil al Mac y de ahi a unas gafas por voz apunta a la idea de un agente omnipresente, y ahi es donde estara la verdadera batalla en los proximos anos. La expansion a escritorio para completar tareas es el movimiento con mas recorrido: es donde la IA deja de conversar y empieza a trabajar. El avatar para videollamadas, en cambio, suena mas a escaparate que a necesidad urgente, y las integraciones comerciales huelen a monetizacion antes que a utilidad para el usuario.

    Para las PYMEs espanolas el consejo es de sentido comun: mirar con curiosidad, probar sin prisa y no atarse. Estas funciones estan en fase temprana y cambiaran. La pregunta util no es si Muse es impresionante, sino si alguna de sus piezas resuelve un problema concreto que hoy cuesta tiempo o dinero. Si la respuesta es no, la novedad puede esperar.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Amazon acelera un 40% el entrenamiento MoE en EKS

    Amazon acelera un 40% el entrenamiento MoE en EKS

    El entrenamiento distribuido MoE en Amazon EKS acaba de recibir un empujon concreto: Amazon ha combinado modelos Mixture of Experts con Elastic Fabric Adapter (EFA) y la libreria DeepEP sobre Kubernetes gestionado, y reporta un incremento del 40% en rendimiento frente a configuraciones tradicionales. No es una promesa de laboratorio, sino una arquitectura desplegable que ataca el cuello de botella real de quien entrena modelos grandes: la comunicacion entre nodos. Para equipos que trabajan con aprendizaje por refuerzo y modelos MoE, esto se traduce en menos tiempo de GPU ociosa y facturas de cloud mas contenidas.

    Que ha pasado y por que importa

    Amazon ha implementado una arquitectura de aprendizaje por refuerzo con modelos Mixture of Experts (MoE) sobre su servicio Amazon EKS, el Kubernetes gestionado de AWS. La clave esta en dos piezas de infraestructura: Elastic Fabric Adapter (EFA), que ofrece red de baja latencia entre instancias, y DeepEP, una libreria de comunicacion optimizada para las operaciones de expert parallelism propias de los modelos MoE. La combinacion permite entrenar modelos mas grandes y complejos con mayor eficiencia computacional, segun Amazon, con un 40% mas de rendimiento respecto a configuraciones convencionales.

    El contexto ayuda a entender el numero. Los modelos MoE activan solo una fraccion de sus parametros por cada token, lo que los hace atractivos en coste de inferencia, pero desplazan el problema al entrenamiento: enrutar tokens hacia los expertos correctos genera un trafico intenso de comunicacion all-to-all entre GPUs. Cuando ese trafico no esta optimizado, las GPUs pasan mas tiempo esperando datos que calculando. Ahi es donde EFA y DeepEP hacen su trabajo, y donde nace la mejora del entrenamiento distribuido MoE en Amazon EKS.

    Implicaciones tecnicas del entrenamiento distribuido MoE en Amazon EKS

    La eleccion de EKS como base no es menor. Ejecutar aprendizaje por refuerzo con MoE sobre Kubernetes gestionado significa que los equipos pueden orquestar workloads de entrenamiento con las mismas herramientas que ya usan para el resto de su stack: escalado de nodos, tolerancia a fallos, y reproducibilidad. EFA aporta el transporte de red saltando el kernel del sistema operativo para reducir latencia, algo critico cuando cientos de GPUs intercambian gradientes y activaciones de expertos en cada paso de entrenamiento.

    DeepEP cierra el circulo optimizando especificamente la dispersion y agregacion de tokens entre expertos, que es la operacion que mas sufre en el entrenamiento distribuido MoE en Amazon EKS. El 40% de mejora no sale de un hardware mas rapido, sino de aprovechar mejor el que ya hay: mas utilizacion efectiva de GPU por euro invertido. Para cargas de aprendizaje por refuerzo, donde el bucle de entrenamiento alterna generacion, evaluacion y actualizacion de politica, cada punto de eficiencia se acumula a lo largo de miles de iteraciones. Quien haya visto la factura de un cluster de entrenamiento sabe que ese 40% se nota en la linea de gasto.

    Como pueden aplicar esto las empresas hoy

    Sea realista sobre a quien aplica esto. El entrenamiento distribuido MoE en Amazon EKS interesa a empresas que ya entrenan o afinan modelos grandes propios, no a quien solo consume APIs de terceros. Si su caso es RAG sobre un modelo comercial, esta arquitectura no le aporta nada directo. Si en cambio entrena modelos MoE o hace aprendizaje por refuerzo con feedback (RLHF o similares), el primer paso es medir su utilizacion de GPU actual: si esta por debajo del 50%, el cuello de botella es de comunicacion y aqui hay margen real. Antes de migrar, calcule el coste total incluyendo las instancias con EFA habilitado, que no son las mas baratas. Evite adoptar MoE solo porque esta de moda: si un modelo denso le sirve, la complejidad operativa de MoE no compensa. Y no subestime la curva de configuracion de EKS, EFA y DeepEP juntos; conviene una prueba de concepto acotada antes de comprometer presupuesto de un ciclo de entrenamiento completo.

    Analisis Blixel

    La mayoria de las mejoras que anuncian los grandes proveedores de cloud son incrementales y estan bien: la eficiencia de infraestructura no necesita titulares grandilocuentes para importar. Un 40% de rendimiento adicional sin cambiar de hardware es exactamente el tipo de optimizacion que decide si un proyecto de entrenamiento sale rentable o se queda en un experimento caro. Dicho esto, conviene poner el dato en su sitio. Ese 40% depende del punto de partida, del tamano del modelo y del patron de comunicacion concreto; comparar contra una configuracion tradicional no optimizada es un baremo comodo. La pregunta util no es cuanto sube el rendimiento, sino cuanto baja su coste por experimento util. Nos gusta que la pieza se apoye en Kubernetes estandar en lugar de en un entorno propietario cerrado, porque reduce el riesgo de quedar atrapado en un solo proveedor, aunque EFA sigue siendo especifico de AWS. Para la mayoria de PYMEs espanolas esto es todavia un tema de segunda linea: pocas entrenan modelos MoE desde cero. Pero para las que ofrecen productos de IA con modelos propios, la eficiencia del entrenamiento distribuido deja de ser un detalle tecnico y pasa a ser una ventaja de margen. Ahi es donde este tipo de arquitectura marca la diferencia entre iterar rapido o quedarse mirando la factura del cluster.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Proaction sube ventas un 60% usando Codex de OpenAI

    Proaction sube ventas un 60% usando Codex de OpenAI

    El caso de uso de Codex de OpenAI en la empresa Proaction pone cifras sobre la mesa: un 60% de incremento en ventas y mas de 75 horas de trabajo manual ahorradas. No es magia ni un titular vacio, sino el resultado de aplicar automatizacion a tareas repetitivas de programacion y analisis de datos. Los numeros redondos siempre invitan al escepticismo, pero lo interesante aqui no es el porcentaje, sino el patron: donde encaja realmente una herramienta como Codex y que tipo de trabajo deja de hacer una persona cuando la incorpora al flujo diario.

    Que ha pasado y por que importa

    Proaction implemento Codex de OpenAI para automatizar parte de sus procesos de ventas y de desarrollo. Segun los datos reportados por la propia compania, la adopcion se tradujo en un aumento del 60% en las ventas y en un ahorro de mas de 75 horas de trabajo manual. La herramienta se aplico sobre dos frentes concretos: tareas repetitivas de programacion y analisis de datos.

    El dato relevante no es solo el crecimiento comercial, sino la naturaleza del ahorro. Setenta y cinco horas equivalen a casi dos semanas laborales de una persona a jornada completa. Ese tiempo, antes dedicado a escribir codigo rutinario o a cruzar datos manualmente, queda liberado para trabajo de mayor valor. En una PYME donde cada perfil tecnico hace de todo, recuperar ese margen tiene un impacto directo en la capacidad de ejecucion.

    Codex es el modelo de OpenAI orientado a generar y completar codigo a partir de instrucciones en lenguaje natural. Su encaje natural son los flujos de desarrollo, pero el caso de Proaction muestra que el analisis de datos y el soporte a procesos comerciales tambien entran en su radio de accion cuando esas tareas dependen de scripts, consultas o transformaciones repetibles.

    Implicaciones tecnicas de este caso de uso de Codex de OpenAI

    El punto clave del caso de uso de Codex de OpenAI es que el valor aparece cuando la automatizacion ataca trabajo repetible y bien definido. Escribir consultas de datos, generar informes recurrentes, preparar scripts de integracion o limpiar datasets son tareas donde un asistente de codigo reduce el tiempo de ejecucion sin sacrificar demasiada supervision humana. No es lo mismo que delegar decisiones de negocio: es acelerar la parte mecanica.

    El incremento del 60% en ventas no se explica solo por la herramienta, sino por lo que permite el tiempo recuperado. Cuando un equipo pequeno deja de invertir 75 horas en tareas manuales, esas horas se redirigen a prospeccion, seguimiento comercial o mejora de producto. La correlacion es logica, pero conviene no confundir causa directa con efecto compuesto: Codex libera capacidad, y esa capacidad es la que genera ventas.

    Para un equipo tecnico, la lectura practica es que la integracion de Codex funciona mejor como copiloto dentro de un flujo ya existente que como reemplazo total de un rol. La supervision sigue siendo necesaria, sobre todo en analisis de datos donde un error silencioso puede propagarse a decisiones comerciales.

    Como pueden aplicar esto las empresas hoy

    Antes de replicar el caso de uso de Codex de OpenAI, conviene identificar donde se van las horas. Haz un inventario honesto de tareas repetitivas: informes que alguien genera cada semana, consultas de datos que se repiten, scripts que se copian y adaptan una y otra vez. Ahi es donde una herramienta como Codex rinde de verdad, no en proyectos ambiguos sin proceso definido.

    Para evaluar el ROI, mide dos cosas antes de empezar: cuantas horas dedica tu equipo a esas tareas y cual es su coste. Si automatizas 75 horas al mes, el calculo es directo. Empieza con un piloto acotado, una sola tarea repetible, y valida la calidad del resultado antes de escalar. Lo que hay que evitar es lanzar la automatizacion sobre procesos criticos sin revision humana: en analisis de datos, un resultado plausible pero erroneo cuesta mas que la hora que ahorra. Tampoco esperes un 60% de ventas por defecto; ese numero depende de que hagas con el tiempo liberado, no de la herramienta en si.

    Analisis Blixel

    Los porcentajes redondos en los casos de exito piden matices, y este no es una excepcion. Vincular un aumento de ventas del 60% directamente a una herramienta de generacion de codigo es un salto argumental que conviene desmontar: Codex no vende, libera tiempo, y es ese tiempo el que, bien reinvertido, puede acabar en mas ventas. La distincion importa porque cualquier empresa que compre la herramienta esperando el mismo resultado sin cambiar como usa las horas recuperadas se va a llevar una decepcion.

    Dicho esto, el dato solido y verificable es el ahorro de 75 horas. Ese es el tipo de metrica sobre la que merece la pena construir una decision. Automatizar trabajo repetible de programacion y analisis de datos es uno de los usos mas maduros y menos arriesgados de la IA actual, precisamente porque el resultado se puede revisar y el coste de error es contenible si hay supervision. Para una PYME con un equipo tecnico reducido, recuperar dos semanas de trabajo al mes es una palanca real.

    La recomendacion es pragmatica: fijate en las horas, no en el porcentaje de ventas. Empieza pequeno, mide antes y despues, y manten a una persona revisando la salida. La automatizacion que funciona es la aburrida y bien medida, no la que promete transformar el negocio en un titular.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Datacor lleva el analytics de alquiler a QuickSight

    Datacor lleva el analytics de alquiler a QuickSight

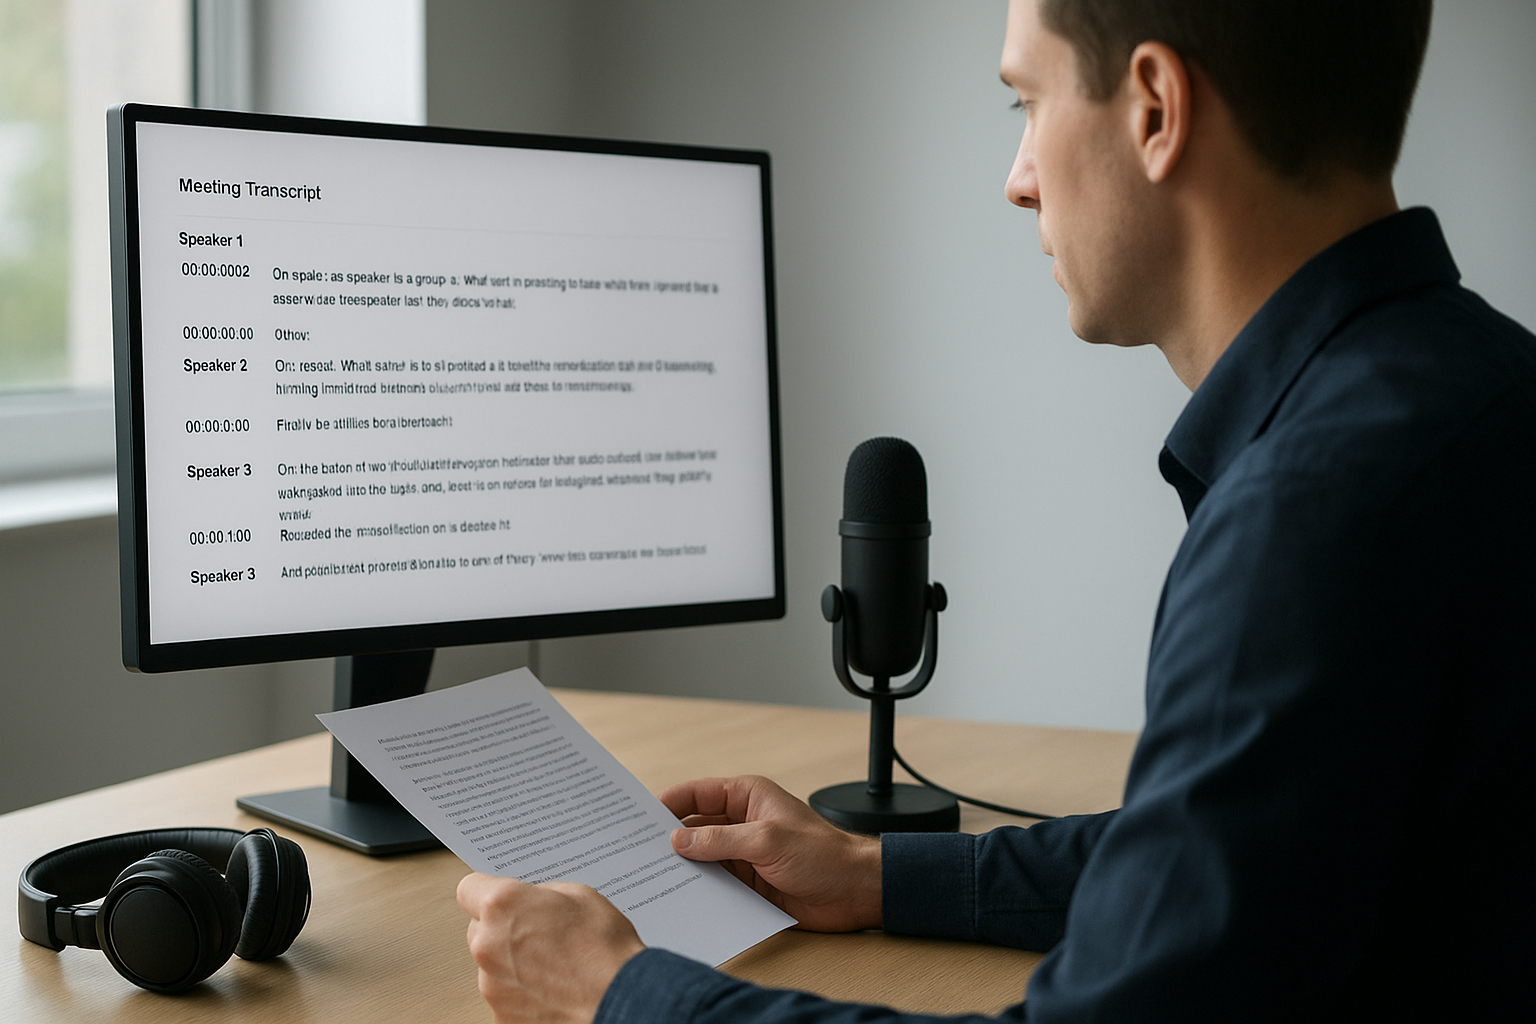
    La plataforma de analytics de alquiler autoservicio que Datacor ha construido sobre Amazon QuickSight marca un cambio concreto en como las empresas del sector rental consultan sus datos. En lugar de esperar a que un equipo tecnico prepare informes, los responsables operativos acceden a metricas en tiempo real directamente. Es el tipo de movimiento poco vistoso pero util: no promete milagros, resuelve un cuello de botella real. Y encaja con una tendencia que llevamos anos viendo en business intelligence: acercar los datos a quien toma las decisiones, sin intermediarios.

    Que ha pasado y por que importa

    Datacor ha implementado una plataforma de analytics de alquiler autoservicio usando Amazon QuickSight para gestionar los datos de alquiler de equipos. La idea central es que las empresas del sector rental accedan a metricas en tiempo real sin depender de equipos tecnicos para cada consulta. QuickSight aporta capacidades de visualizacion nativas en la nube que se integran directamente con otros servicios de AWS, lo que reduce la friccion tipica de montar cuadros de mando desde cero.

    El detalle relevante es el modelo autoservicio. En muchas empresas de alquiler de maquinaria y equipos, la informacion sobre utilizacion de flota, disponibilidad o rentabilidad por activo vive en sistemas que solo el departamento de IT sabe interrogar. Cada pregunta de negocio se convierte en un ticket. Al trasladar ese acceso a QuickSight, Datacor elimina ese paso intermedio. El contexto importa: el sector rental trabaja con margenes ajustados y decisiones operativas que dependen de saber, hoy, que equipo esta parado y cual esta generando ingresos.

    Implicaciones tecnicas de esta plataforma de analytics de alquiler

    La eleccion de QuickSight como base de esta plataforma de analytics de alquiler autoservicio tiene logica arquitectonica. Al ser un servicio nativo de AWS, la integracion con otras piezas del ecosistema de datos de Amazon evita construir conectores propios y mantener pipelines fragiles. Para un proveedor de software como Datacor, que sirve a multiples clientes del sector rental, esto significa un coste de mantenimiento mas predecible y una escalabilidad que no depende de aprovisionar servidores de informes.

    El modelo de tiempo real es el otro punto tecnico a vigilar. Las metricas actualizadas sirven de poco si la latencia entre el dato operativo y su visualizacion es alta. QuickSight, con su motor de calculo en memoria, esta pensado para responder consultas interactivas sobre volumenes considerables sin obligar al usuario a esperar. El reto habitual en estos despliegues no es la herramienta, sino la calidad y el modelado del dato de origen: si los datos de alquiler estan mal estructurados, el autoservicio amplifica los errores en lugar de esconderlos.

    Como pueden aplicar esto las empresas hoy

    Cualquier PYME del sector rental que ya use AWS deberia mirar este caso con atencion, pero sin ilusiones. Antes de replicar una plataforma de analytics de alquiler autoservicio, conviene auditar el estado real de los datos: si la utilizacion de flota se registra a mano o en hojas de calculo dispersas, ninguna herramienta lo arreglara. El primer paso es consolidar el origen del dato, no comprar licencias. Una vez limpio el dato, empezar con dos o tres cuadros de mando de alto valor (utilizacion por equipo, rentabilidad por contrato, disponibilidad) da mas ROI que un despliegue completo de golpe. Para evaluar el retorno, mide el tiempo que hoy pierde tu equipo generando informes manuales y el coste de decisiones tardias por falta de datos. Lo que hay que evitar: montar decenas de paneles que nadie consulta y confundir tener graficos con tener informacion accionable. Empezar pequeno, medir uso real y ampliar solo lo que la gente usa.

    Analisis Blixel

    Hay una trampa recurrente en el autoservicio de datos: se vende como democratizacion, pero sin gobernanza acaba siendo un caos de metricas contradictorias donde cada departamento defiende su propio numero. El valor de un despliegue como el de Datacor no esta en QuickSight, que es una pieza intercambiable, sino en el trabajo previo de definir que significa cada indicador y de dejar el dato limpio antes de abrirlo a todo el mundo. Ese es el 80% del esfuerzo y el que casi nadie presume. Para el sector rental, donde la rentabilidad depende de saber al instante que activo esta ocioso, tener metricas en tiempo real es una ventaja tangible, no una moda. Pero el riesgo es real: dar acceso libre a datos mal modelados genera mas reuniones para discutir cifras que decisiones tomadas. La recomendacion honesta para una PYME es no empezar por la herramienta. Empieza por acordar cinco preguntas de negocio que hoy no puedes responder rapido, asegura que el dato para contestarlas existe y es fiable, y solo entonces elige con que lo visualizas. La tecnologia de business intelligence lleva madura muchos anos; lo que sigue fallando es la disciplina de datos. Casos como este funcionan cuando la organizacion trata el analytics como un habito operativo, no como un proyecto de IT que se entrega y se olvida.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • WhisperX en SageMaker: transcribir y saber quien habla

    WhisperX en SageMaker: transcribir y saber quien habla

    La transcripcion con etiquetas de hablante deja de ser un problema de integracion casera: Amazon Web Services ha llevado WhisperX a SageMaker AI para convertir audio en texto identificando quien dice cada frase. En reuniones, llamadas de soporte o conferencias, el sistema no solo pasa la voz a texto, sino que separa las intervenciones de cada participante. Para equipos que hasta ahora encadenaban Whisper con scripts propios de diarizacion, esto reduce friccion. Y para quien nunca dio el paso, baja la barrera de entrada a un caso de uso muy concreto y demandado.

    Que ha pasado y por que importa

    AWS ha implementado WhisperX sobre su plataforma SageMaker AI para ofrecer transcripcion automatica con identificacion de hablantes individuales. La transcripcion con etiquetas de hablante combina dos piezas: el modelo Whisper de OpenAI, que se encarga de convertir el audio en texto, y una capa de diarizacion que separa las voces de las distintas personas presentes en la grabacion. El resultado es un texto ordenado en el que cada intervencion queda atribuida a un interlocutor.

    La utilidad practica es directa. Procesar grabaciones de reuniones para generar actas, analizar llamadas de atencion al cliente o revisar conferencias son tareas donde saber quien habla cambia por completo el valor del texto. Un acta sin atribucion es un muro de palabras; una con hablantes identificados es un documento accionable. WhisperX ya existia como proyecto de codigo abierto y se habia convertido en la opcion habitual para anadir diarizacion a Whisper. Que ahora se ofrezca empaquetado sobre SageMaker significa que el trabajo de despliegue, escalado y gestion de infraestructura queda dentro de un servicio gestionado, en lugar de recaer en el equipo de datos.

    Implicaciones tecnicas de la diarizacion en SageMaker

    La transcripcion con etiquetas de hablante suma un paso adicional al pipeline tradicional. Whisper resuelve el reconocimiento del habla; la diarizacion resuelve la pregunta de cuantas voces hay y a quien pertenece cada segmento. WhisperX articula ambas fases y ademas mejora el alineamiento temporal de las palabras, lo que produce marcas de tiempo mas precisas por intervencion. Esa precision es lo que hace que el texto resultante sea navegable y no una masa continua.

    Ejecutar esto en SageMaker AI tiene consecuencias concretas. El procesamiento de audio con diarizacion es intensivo en computo, especialmente en GPU, y la ventaja de una plataforma gestionada es poder dimensionar el endpoint segun el volumen de grabaciones sin mantener servidores propios encendidos. La transcripcion con etiquetas de hablante deja de depender de que alguien parchee versiones, resuelva dependencias y vigile la maquina. Conviene recordar sus limites: la diarizacion no es infalible. En audios con solapamiento de voces, ruido de fondo o microfonos de mala calidad, el numero de hablantes detectados puede fallar y las atribuciones pueden mezclarse. La transcripcion con etiquetas de hablante rinde mejor con audio limpio y canales separados cuando es posible.

    Como pueden aplicar esto las empresas hoy

    El caso mas rentable es el que ya genera trabajo manual repetitivo. Si tu equipo dedica horas a redactar actas de reunion o a revisar llamadas de soporte, la transcripcion con etiquetas de hablante ataca ese coste directamente. El primer paso sensato es una prueba acotada: coge una muestra real de tus grabaciones, con la calidad de audio que manejas de verdad, y mide la precision de la diarizacion antes de comprometer presupuesto. No evalues con audio de laboratorio.

    Para calcular el ROI, compara el coste por hora de audio procesado en SageMaker frente al tiempo humano que sustituye. En atencion al cliente, el valor no esta solo en el texto: esta en poder analizar despues quien dijo que, extraer motivos de contacto o alimentar un sistema de calidad. Lo que conviene evitar es tratar la salida como definitiva. Para actas legales o documentos sensibles, manten revision humana sobre las atribuciones. Y ten presente el marco de proteccion de datos: transcribir conversaciones implica tratar datos personales y, a menudo, informar y recabar consentimiento. La transcripcion con etiquetas de hablante es una herramienta, no una excusa para saltarse el RGPD.

    Analisis Blixel

    Empaquetar una herramienta open source madura dentro de un servicio gestionado no suena a titular, pero es exactamente el tipo de movimiento que mueve la aguja en las PYMEs. La distancia entre «existe un proyecto en GitHub que hace esto» y «mi equipo puede usarlo en produccion sin un ingeniero dedicado» es enorme, y ahi es donde se pierden la mayoria de las iniciativas de IA. Reducir esa distancia vale mas que muchos anuncios de modelos nuevos.

    Dicho esto, hay que gestionar expectativas. La diarizacion es la parte fragil del pipeline, y quien la venda como resuelta al cien por cien esta exagerando. En audio real de oficina espanola, con gente que se pisa al hablar y llamadas por telefono, los resultados varian. La recomendacion es tratar esta capacidad como un acelerador de trabajo humano, no como un reemplazo total. Genera el borrador, ahorra el 80 por ciento del esfuerzo, deja que una persona corrija lo que importa. El otro punto ciego es el legal: muchas empresas se lanzan a transcribir todo sin plantearse la base juridica del tratamiento. Antes de conectar el micro, conviene revisar politicas de privacidad y retencion. Con esas cautelas, es una de las aplicaciones de IA con retorno mas claro y medible que existen ahora mismo, precisamente porque ataca una tarea aburrida, costosa y facil de cuantificar.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • HEMA acaba con el salto entre portales usando MCP

    HEMA acaba con el salto entre portales usando MCP

    La integracion de MCP con Amazon Bedrock que ha puesto en marcha HEMA resuelve un problema tan comun como aburrido: los empleados perdian tiempo saltando entre portales internos para encontrar un dato de recursos humanos, un nivel de inventario o una politica corporativa. En lugar de crear otro cuadro de mando mas, la compania ha optado por centralizar el acceso a esa informacion dispersa y devolver respuestas directas. El resultado es menos navegacion, menos clics y un flujo de trabajo mas rapido para el personal que necesita datos concretos al momento.

    Que ha pasado y por que importa

    HEMA ha implementado el Model Context Protocol (MCP) junto con Amazon Bedrock para unificar el acceso a datos que hasta ahora vivian en sistemas separados: recursos humanos, inventario y otros repositorios internos. La idea central de la integracion de MCP con Amazon Bedrock es que un asistente pueda consultar esas fuentes a traves de un protocolo comun, sin que cada sistema requiera una conexion a medida. Asi, el empleado pregunta en lenguaje natural y obtiene la respuesta sin abrir cinco pestanas.

    MCP es un estandar abierto que define como un modelo de lenguaje se conecta con herramientas y fuentes de datos externas. En lugar de programar integraciones puntuales y fragiles para cada portal, MCP actua como una capa intermedia que expone cada sistema como un recurso consultable. Amazon Bedrock aporta el acceso gestionado a los modelos y la infraestructura para orquestar esas llamadas. La combinacion permite que HEMA conecte sus fuentes internas sin reconstruir su stack existente, un factor decisivo para cualquier empresa con sistemas heredados que no puede permitirse migraciones masivas.

    Implicaciones tecnicas de esta arquitectura

    La integracion de MCP con Amazon Bedrock cambia la forma de plantear los asistentes internos. El modelo tradicional consistia en volcar toda la documentacion en un indice vectorial y montar un sistema RAG cerrado. El enfoque con MCP es distinto: cada sistema mantiene su fuente de verdad y se expone como un servidor MCP que el modelo consulta cuando lo necesita. Esto reduce la duplicacion de datos y evita que las respuestas queden desactualizadas, porque la informacion se lee en origen y no de una copia estatica.

    Para un equipo tecnico, la ventaja practica es la modularidad. Anadir una nueva fuente al asistente ya no obliga a reescribir la logica de recuperacion: basta con exponer ese sistema como un recurso MCP mas. Eso baja el coste de mantenimiento y hace la arquitectura mas sostenible a medio plazo. La contrapartida es que hay que gobernar bien los permisos: si el asistente puede consultar inventario y recursos humanos, el control de acceso por rol deja de ser opcional y pasa a ser el nucleo del diseno. Sin ese gobierno, la comodidad de tener todo a un mensaje de distancia se convierte en un riesgo de exposicion de datos.

    Como pueden aplicar esto las empresas hoy

    Lo primero es identificar donde pierde tiempo la plantilla, no donde luce mejor un chatbot. La integracion de MCP con Amazon Bedrock tiene sentido cuando la informacion esta genuinamente dispersa en varios sistemas y la busqueda manual es un cuello de botella real. Empieza por dos o tres fuentes de alto uso (por ejemplo, politicas de RRHH y consulta de stock) antes de conectar todo el catalogo de sistemas. Un piloto acotado da metricas de ahorro de tiempo tangibles y evita un proyecto interminable.

    En cuanto a ROI, mide el tiempo medio que hoy cuesta encontrar un dato y multiplicalo por el volumen de consultas: ahi esta el ahorro que justifica el gasto de infraestructura. Que evitar: exponer sistemas criticos sin control de acceso por rol, y montar un asistente que responda con confianza sobre datos que no puede verificar. Define desde el dia uno que fuentes son de solo lectura, quien puede consultar que, y como se registra cada acceso. La comodidad de las respuestas directas solo compensa si la gobernanza de datos va por delante, no despues.

    Analisis Blixel

    Durante anos el discurso de los asistentes internos ha vendido humo: cajas de chat que respondian bonito pero se apoyaban en documentacion desactualizada y no sabian de que hablaban. Lo interesante del caso de HEMA no es el modelo que usa, sino la decision arquitectonica de leer los datos en origen a traves de un protocolo comun en lugar de acumular copias en un indice. Ese matiz separa un proyecto que envejece mal de uno que se mantiene.

    MCP no es magia y conviene decirlo claro: no arregla datos sucios, permisos mal definidos ni procesos rotos. Si tus sistemas internos son un caos, conectarlos a un asistente solo hace que el caos responda mas rapido. El valor aparece cuando la organizacion ya tiene sus fuentes ordenadas y lo que sobra es friccion de navegacion. Ahi es donde este enfoque brilla y donde el ahorro de tiempo se nota de verdad.

    Para una PYME espanola la leccion es doble. Primero, no hace falta reconstruir el stack para modernizar el acceso a la informacion; se puede ir sistema a sistema. Segundo, el control de acceso por rol no es un extra, es el proyecto. Quien lo trate como una fase posterior acabara con un asistente que filtra lo que no debe. Empezar pequeno, medir el ahorro real y blindar los permisos: ese es el orden sensato.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.