
Categoría: IA Aplicada

  • Harvard mete avatares de IA en su bootcamp de 699$

    Harvard mete avatares de IA en su bootcamp de 699$

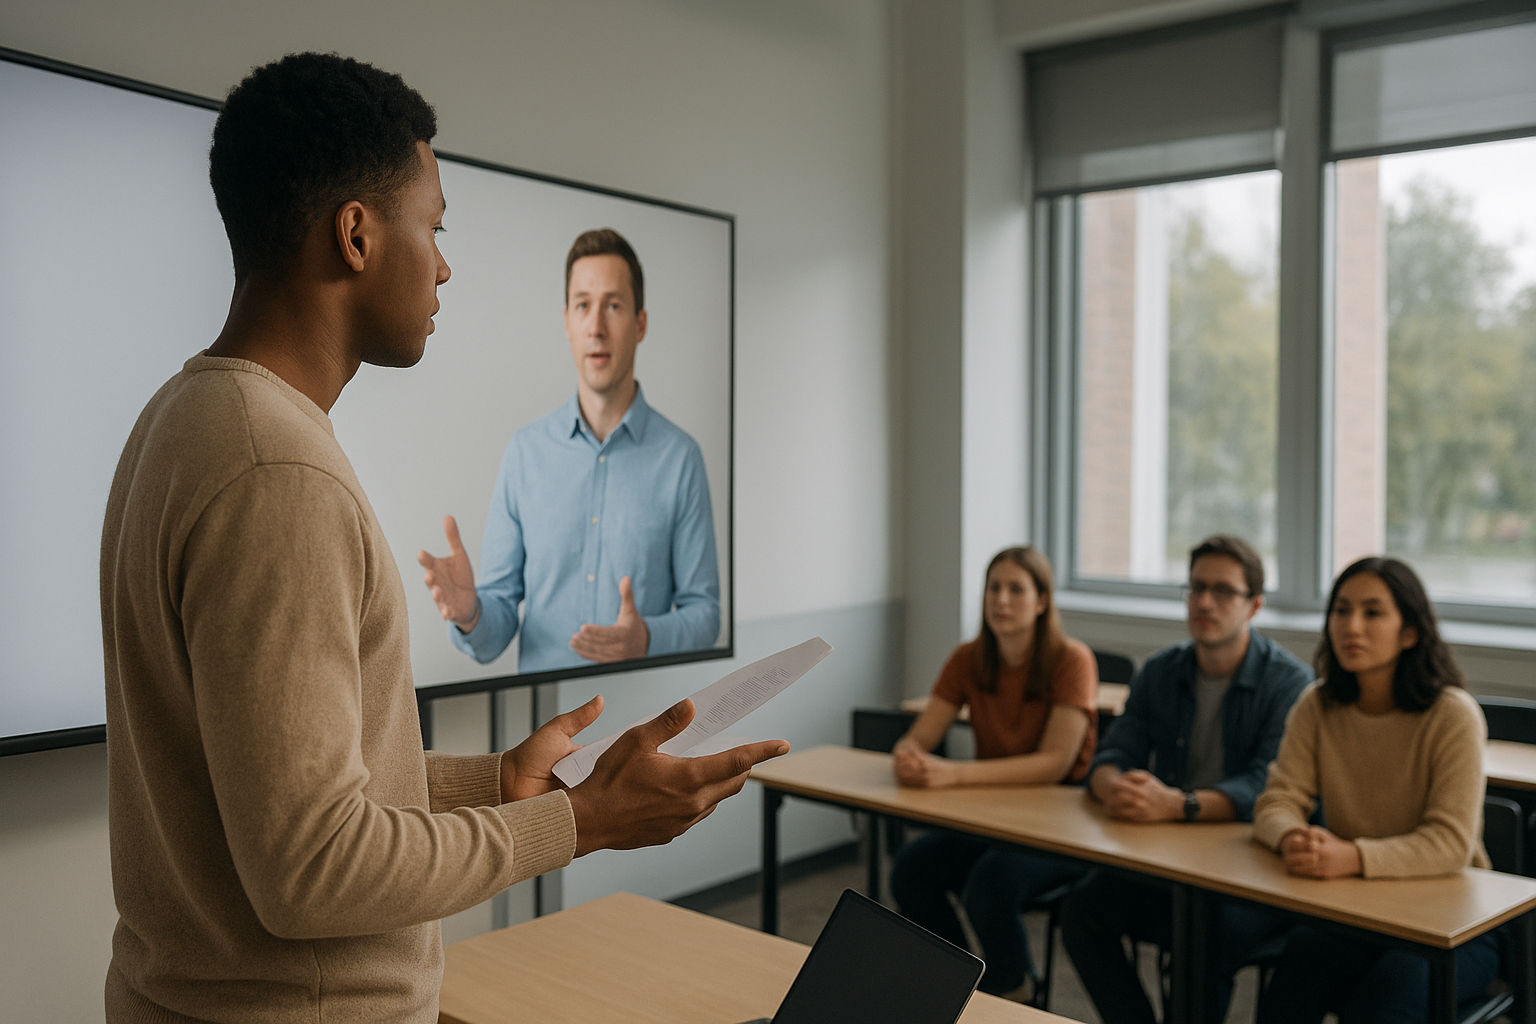
    Los avatares de IA para formacion de startups acaban de llegar a un nombre grande: Harvard Business School los ha integrado en HBS Foundry, un bootcamp de ocho semanas para emprendedores que cuesta 699 dolares. Creados con la tecnologia de HeyGen, estos avatares reproducen a los instructores reales y ofrecen feedback individual durante presentaciones y simulacros de reunion de consejo. No sustituyen a los profesores: complementan las sesiones en vivo semanales. Los participantes dicen preferirlos a un chatbot de texto, aunque admiten que verlos hablar resulta algo inquietante. Un caso pequeno, pero revelador de por donde va la formacion asistida por IA.

    Que ha pasado y por que importa

    Harvard Business School ha sumado avatares de IA a su programa HBS Foundry, un bootcamp intensivo de ocho semanas dirigido a emprendedores en fase temprana, con un precio de 699 dolares. La tecnologia detras de los avatares es de HeyGen, empresa especializada en generar video con personas sinteticas a partir de la imagen y voz de personas reales. En este caso, los avatares reproducen a los propios instructores del programa.

    La funcion concreta de estos avatares de IA es dar feedback individual a los participantes cuando ensayan presentaciones o simulan reuniones de consejo con inversores. Es decir, ocupan el hueco entre las sesiones en vivo semanales con instructores humanos, momentos en los que normalmente un alumno no tendria a quien recurrir. Segun los participantes consultados por el New York Times, esta modalidad les resulta preferible a un chatbot tradicional de texto, aunque varios reconocen que interactuar con una copia digital de su profesor puede resultar algo inquietante.

    El detalle relevante no es la marca Harvard, sino el modelo: usar avatares de IA para escalar el feedback personalizado sin renunciar del todo a la presencia humana en directo.

    Implicaciones tecnicas de este uso de avatares de IA

    Lo interesante de este despliegue de avatares de IA es que no busca reemplazar al instructor, sino multiplicar su disponibilidad. Un profesor humano no puede revisar cincuenta pitches a las once de la noche; un avatar entrenado con su estilo y criterios, si. Esto convierte la formacion en algo asincrono sin caer en el material grabado y estatico de siempre.

    Tecnicamente, HeyGen combina sintesis de video con voz clonada y un modelo de lenguaje por detras que genera las respuestas. La parte visual es sofisticada, pero el valor real depende del LLM y de como se haya acotado su conocimiento: si el avatar responde con generalidades, el efecto novedad se agota rapido. El feedback util exige que el sistema conozca el contexto del alumno, su sector y su fase.

    El comentario recurrente sobre lo inquietante del formato tampoco es menor. El llamado valle inquietante sigue vigente: un avatar hiperrealista que reproduce a una persona conocida genera mas rechazo que un chatbot que no pretende ser nadie. Es un recordatorio de que el realismo no siempre mejora la experiencia; a veces la complica.

    La leccion aprovechable para empresas y equipos

    Aqui hay algo concreto y no obvio para cualquier empresa que forme a su plantilla o a sus clientes. El acierto de Harvard no es usar avatares porque queden modernos, sino colocarlos exactamente donde el humano no llega: entre sesiones, para practica repetida y feedback inmediato. Si tu equipo comercial ensaya argumentarios, o formas a nuevos empleados en procesos, ese hueco asincrono es donde un avatar aporta, no en sustituir la clase magistral.

    La segunda leccion es la combinacion, no el reemplazo. Los alumnos siguen teniendo sesiones en vivo con instructores reales; el avatar es un anadido. Cualquier PYME que plantee IA formativa deberia mantener ese equilibrio: automatizar la practica repetitiva y reservar el criterio humano para lo estrategico. Y una advertencia derivada del propio articulo: si a usuarios de Harvard les resulta inquietante un avatar de su profesor, mide la reaccion de tu gente antes de clonar la cara del jefe. A veces un asistente de voz sin rostro o un chatbot bien disenado genera menos friccion que un doble digital hiperrealista.

    Analisis Blixel

    Clonar la cara de un profesor tiene mas de gesto de marketing que de necesidad pedagogica. El feedback util no depende de que el video se parezca al instructor, sino de la calidad del modelo que hay detras y de cuanto contexto maneja sobre cada alumno. Por eso conviene separar dos cosas que aqui van juntas: la utilidad de tener feedback asincrono ilimitado, que es real, y el envoltorio del avatar, que es cosmetico y hasta contraproducente cuando roza el valle inquietante. La primera parte es replicable por casi cualquier organizacion con un LLM bien acotado; la segunda es cara y arriesgada. Que una institucion como esta lo pruebe abiertamente ayuda a normalizar la practica de la IA formativa, y eso es positivo. Pero el precio de 699 dolares y el nombre Harvard no deberian confundir a nadie: la tecnologia de base esta al alcance de empresas mucho mas pequenas. Lo que marca la diferencia no es el avatar, sino el diseno del programa, la calidad de las instrucciones que recibe el modelo y la honestidad de reconocer que la IA aqui practica, no ensena. El dia que el realismo del video deje de sorprender, quedara la pregunta de siempre: el feedback era bueno o solo tenia buena cara.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Bedrock recorta el coste del RAG comprimiendo tokens

    Bedrock recorta el coste del RAG comprimiendo tokens

    La compresion adaptativa de consultas en Amazon Bedrock ataca uno de los dolores mas concretos de quien lleva IA generativa a produccion: la factura de tokens. La tecnica ajusta de forma automatica el contenido que se envia al modelo segun cada consulta RAG, eliminando texto innecesario antes del procesamiento. El resultado es menos tokens facturados manteniendo la precision del contexto recuperado. Para PYMEs que operan chatbots o buscadores semanticos, es una palanca de ahorro que no exige rehacer la arquitectura ni bajar la calidad de las respuestas.

    Que ha pasado y por que importa

    Amazon Bedrock ha incorporado un mecanismo de compresion que actua sobre el contexto recuperado en un flujo RAG. En lugar de arrastrar todo el fragmento de texto recuperado hacia el modelo, la compresion adaptativa de consultas evalua cada peticion y descarta lo que no aporta, reduciendo el volumen de tokens que finalmente se procesan. Como la facturacion de los modelos gestionados se calcula por token de entrada y salida, cada palabra sobrante que se elimina antes de llegar al modelo se traduce en coste que no se paga.

    El detalle relevante es que el ajuste es por consulta: no aplica una regla fija a todo, sino que adapta el recorte a lo que pide cada pregunta. Segun la funcionalidad presentada, esto permite reducir de forma notable el numero de tokens procesados sin comprometer la calidad de las respuestas. En sistemas RAG, donde el contexto recuperado suele ser el componente mas voluminoso del prompt, ahi es precisamente donde se concentra el gasto evitable.

    El contexto ayuda a entenderlo: los patrones RAG se han vuelto el estandar para conectar un LLM con datos propios de la empresa. Pero ese patron tiene un coste silencioso, porque cada consulta inyecta fragmentos largos de documentacion en el prompt. A medida que sube el trafico, el gasto en tokens crece de forma lineal, y muchos equipos descubren tarde que el mayor coste operativo no era el modelo, sino todo el contexto que le estaban enviando sin filtrar.

    Implicaciones tecnicas de la compresion adaptativa

    Tecnicamente, la compresion adaptativa de consultas se situa en la fase intermedia del pipeline RAG: despues de la recuperacion y antes de la inferencia. Ese punto es clave porque no toca ni la base de conocimiento ni el modelo, solo el material que viaja entre ambos. Para un equipo tecnico significa que la optimizacion se puede activar sobre un sistema ya en marcha sin reindexar embeddings ni cambiar de modelo, lo que reduce el riesgo de introducir regresiones en produccion.

    La compensacion habitual en estos casos es calidad frente a coste: recortar contexto de forma agresiva suele degradar las respuestas. El valor de un enfoque adaptativo esta en que el recorte depende de la consulta, de modo que preguntas que necesitan mas contexto lo conservan y las que no, se aligeran. Esto encaja bien con cargas heterogeneas, tipicas de un chatbot de soporte donde conviven dudas triviales y consultas que exigen varios documentos.

    Para el resto del stack, menos tokens de entrada tambien significa menor latencia, porque el modelo procesa prompts mas cortos. En aplicaciones interactivas como un asistente conversacional, esa reduccion de latencia mejora la experiencia tanto como el ahorro mejora el margen. La compresion adaptativa de consultas actua, por tanto, sobre dos metricas a la vez: coste por interaccion y tiempo de respuesta.

    Como pueden aplicar esto las empresas hoy

    El primer paso es medir antes de tocar nada: revisa el numero medio de tokens de entrada por consulta en tu sistema RAG actual y que porcentaje corresponde al contexto recuperado. Si el contexto pesa mas que la pregunta y la respuesta juntas, la compresion adaptativa de consultas tiene margen claro para ahorrar. Sin esa medicion previa no podras calcular el ROI ni justificar el cambio ante direccion.

    En la evaluacion, activa la compresion en un entorno de pruebas y compara respuestas con y sin ella sobre un conjunto real de consultas de tus usuarios, no ejemplos inventados. Mide dos cosas: reduccion de tokens y calidad percibida de la respuesta. Si la calidad se mantiene y los tokens bajan, el caso de negocio es directo. Lo que hay que evitar es asumir el ahorro sin validar la precision en tus propios datos, porque cada dominio se comporta distinto.

    Para una PYME con un chatbot de soporte o un buscador semantico interno, el atractivo es que no requiere un rediseno costoso: es una optimizacion incremental sobre una inversion ya hecha. El error a evitar es sobreoptimizar y recortar tanto que el asistente empiece a fallar en las consultas complejas, precisamente las que mas valor aportan al negocio.

    Analisis Blixel

    Durante meses el debate sobre IA generativa ha girado alrededor de que modelo elegir, cuando la pregunta que de verdad afecta a la cuenta de resultados es otra: cuanto contexto le estas enviando y cuanto de eso es desperdicio. La mayoria de proyectos RAG que hemos visto naufragar en produccion no lo hacen por mala calidad, sino porque la factura escala mas rapido que el valor a medida que crece el uso. Ahi es donde una optimizacion de este tipo importa mas de lo que su titular sugiere.

    Nos gusta que la mejora ataque el eslabon correcto del pipeline, el contexto recuperado, y no venda magia sobre el modelo. Es una tecnica poco vistosa y muy rentable, justo lo contrario del ruido habitual del sector. Dicho esto, mantenemos la cautela de siempre: el ahorro es real solo si se valida sobre datos propios, porque un recorte que funciona en un dominio puede empobrecer las respuestas en otro con consultas mas ambiguas. La palabra clave es adaptativo, y el riesgo esta en confiar ciegamente en que el sistema siempre acierta al decidir que sobra. Nuestra recomendacion para cualquier equipo es tratar esto como una funcionalidad que se mide, se ajusta y se vigila, no como un interruptor que se enciende y se olvida. Bien gestionada, es de las pocas optimizaciones que mejoran coste y latencia sin pedir nada a cambio en calidad.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • El calendario con IA de Linkdaze reta a Skylight

    El calendario con IA de Linkdaze reta a Skylight

    El calendario inteligente con IA de Linkdaze llega con una propuesta concreta: organizar a una familia entera desde una sola pantalla tactil en lugar de gestionar agendas individuales dispersas. El dispositivo sincroniza Google Calendar, iCloud y Outlook en una vista comun e incorpora un planificador de comidas que convierte la foto de una receta en papel o de un menu escolar en un plan digital, con lista de la compra generada de forma automatica. Se vende sin suscripcion mensual, con modelos de 15,6 y 10,1 pulgadas desde 119,99 dolares, por debajo de los 159,99 de Skylight, su competidor mas directo.

    Que ha pasado y por que importa

    Linkdaze ha presentado un calendario digital de pared con pantalla tactil pensado para el hogar. Su funcion central es la sincronizacion de multiples plataformas de agenda (Google, iCloud y Outlook) en una unica interfaz que muestra los eventos de todos los miembros de la casa. La diferencia frente a un panel de eventos basico esta en el planificador de comidas con IA: el usuario fotografia una receta impresa o el menu que llega del colegio y el sistema lo transforma en un plan de comidas digital y en una lista de la compra sin introducir los datos a mano.

    El movimiento se enmarca en la categoria de los llamados family calendars, que popularizo Skylight con dispositivos de precio elevado y, en algunos casos, funciones de pago recurrente. Linkdaze ataca ese hueco por dos flancos: precio de entrada mas bajo (119,99 frente a 159,99 dolares) y ausencia de suscripcion. Ofrece dos tamanos, 15,6 y 10,1 pulgadas, para adaptarse a cocinas o entradas de casa. Es un producto de consumo, pero el uso de vision por ordenador para digitalizar documentos cotidianos deja lecciones aprovechables mas alla del salon.

    Implicaciones tecnicas y de mercado

    La parte interesante del calendario inteligente con IA de Linkdaze no es la pantalla, sino el flujo de digitalizacion: reconocer texto en una imagen (receta o menu escolar), estructurarlo en ingredientes y fechas, y derivar una lista de la compra. Es un caso de uso de OCR mas extraccion estructurada aplicado a un problema domestico repetitivo. Ese mismo patron (foto de un documento no estructurado convertido en datos accionables) es exactamente lo que muchas empresas necesitan para albaranes, tickets o formularios en papel.

    En cuanto al mercado, la decision de eliminar la suscripcion es el argumento comercial mas agresivo. Skylight y otros rivales han apostado por ingresos recurrentes; Linkdaze responde con pago unico y precio de entrada menor. Para el comprador, cambia el calculo de coste total: un dispositivo sin cuota mensual amortiza antes aunque el hardware sea similar. El riesgo para el fabricante es sostener el desarrollo de la IA sin ingresos recurrentes, algo que habra que vigilar en actualizaciones futuras. Por ahora, la jugada demuestra que en dispositivos domesticos con IA el modelo de negocio pesa tanto como la funcion estrella.

    La leccion util para empresas que si aplica

    Mas alla del uso familiar, hay una ensenanza concreta y no obvia para una PYME. El planificador de comidas del calendario inteligente con IA de Linkdaze resuelve un problema que toda oficina conoce: convertir papel en datos sin teclearlos. La misma tecnica (fotografiar un documento y extraer campos estructurados) se aplica a facturas de proveedores, notas de gastos o pedidos manuscritos. Antes de contratar un desarrollo a medida, una empresa puede validar el flujo con herramientas de OCR e IA ya disponibles sobre un lote pequeno de documentos reales y medir la tasa de aciertos. Lo que conviene evitar es asumir que la extraccion sera perfecta: menus y recetas tienen formatos limpios, pero un albaran arrugado o una letra mala reducen la precision. La leccion practica es que este tipo de automatizacion funciona cuando el documento de entrada es razonablemente uniforme y cuando hay un humano revisando los casos dudosos. Empezar por un proceso repetitivo y acotado, medir el ahorro real de tiempo y escalar solo si los numeros acompanan es el camino sensato, igual que el que aplica el calendario inteligente con IA de Linkdaze a la lista de la compra.

    Analisis Blixel

    Lo mas revelador de este producto no es que muestre agendas en una pantalla bonita, sino que ha identificado el punto de friccion real de un hogar: nadie quiere transcribir a mano el menu del colegio o los ingredientes de una receta. Ese detalle, tecleado tantas veces, es donde la IA aporta valor tangible en lugar de humo. Es la diferencia entre meter un chatbot porque toca y automatizar una tarea que la gente odia hacer. La eliminacion de la suscripcion tambien merece aplauso: demasiados dispositivos convierten al comprador en rehen de una cuota mensual para funciones que deberian venir en el precio. El calendario inteligente con IA cumple aqui una funcion demostrativa util para cualquier empresa: la tecnologia se justifica cuando ahorra tiempo en algo concreto y medible, no cuando suena moderna. El punto debil es la sostenibilidad del modelo sin ingresos recurrentes, y la dependencia de la calidad del OCR ante documentos desordenados. Pero como ejercicio de producto es honesto. Traducido al mundo empresarial, el aprendizaje es directo: identifica la tarea manual mas repetida y aburrida de tu equipo, comprueba si una foto y un modelo pueden resolverla, y calcula el ahorro antes de firmar nada. Si el numero no sale, no la automatices. Esa disciplina, y no la etiqueta de IA, es lo que separa una compra util de un gasto vistoso.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Ramp crea Router para elegir el mejor LLM por tarea

    Ramp crea Router para elegir el mejor LLM por tarea

    La fintech Ramp ha presentado Router, su propio enrutador de modelos de IA que decide, consulta a consulta, que LLM debe atender cada peticion segun el tipo de tarea. El objetivo es doble: recortar la factura de inferencia y mejorar los tiempos de respuesta sin sacrificar calidad. La compania ya lo usa de forma interna para su plataforma de gestion de gastos empresariales. En un momento en que casi ninguna empresa depende de un unico modelo, un enrutador que reparte trabajo entre varios proveedores deja de ser un lujo tecnico y pasa a ser una pieza de arquitectura con impacto directo en el margen.

    Que ha lanzado Ramp y por que importa

    Router es un sistema interno que dirige las consultas entre distintos modelos de IA en funcion de la tarea concreta que hay que resolver. No todas las peticiones necesitan el modelo mas grande ni el mas caro: una clasificacion simple o una extraccion de datos rutinaria puede resolverse con un modelo mas ligero, mientras que un razonamiento complejo justifica uno mas potente. Ramp aplica esa logica de forma automatica, evaluando cada tarea y enviandola al LLM adecuado. El resultado que persigue la compania es reducir gastos operativos y aumentar la velocidad de respuesta.

    La decision no surge en el vacio. Ramp opera una plataforma de gestion de gastos que procesa grandes volumenes de documentos, transacciones y consultas donde la IA interviene en tareas repetitivas. Cuando el uso de modelos escala, el coste de inferencia deja de ser marginal y se convierte en una linea seria del presupuesto. Un enrutador de modelos de IA desarrollado a medida les permite controlar ese gasto sin renunciar a la calidad en los casos que si la exigen, y mantener flexibilidad frente a un mercado de proveedores que cambia cada pocos meses.

    Implicaciones tecnicas del enrutamiento de modelos

    Construir un enrutador de modelos de IA propio implica resolver varios problemas a la vez. Primero, clasificar la tarea entrante con suficiente precision para asignarla al modelo correcto, algo que a menudo se hace con un modelo pequeno y rapido que actua como clasificador previo. Segundo, gestionar la heterogeneidad: cada proveedor tiene su API, sus limites de contexto, sus latencias y sus precios. Y tercero, medir. Sin telemetria de coste por consulta, calidad de salida y tiempo de respuesta es imposible saber si el enrutador esta acertando o degradando el servicio.

    La ventaja estrategica de un enrutamiento propio es evitar el bloqueo con un unico proveedor. Si un modelo sube de precio, baja de rendimiento o queda obsoleto, la gestion de multiples LLM permite redirigir el trafico con cambios minimos. La contrapartida es el coste de mantenimiento: hay que actualizar la logica cada vez que aparece un modelo nuevo, recalibrar umbrales y vigilar que el clasificador no envie tareas criticas a modelos insuficientes. Para una empresa con el volumen de Ramp, ese esfuerzo se amortiza; para otras, la ecuacion puede ser distinta.

    Como pueden aplicar esto las empresas hoy

    La leccion practica del enrutador de modelos de IA de Ramp es clara: no pagues por un modelo premium para tareas que resuelve uno barato. Antes de construir nada, la mayoria de empresas deberia auditar su uso real de LLM y clasificar sus tareas por complejidad. Muchas descubriran que un porcentaje alto de consultas son rutinarias y podrian migrar a modelos mas economicos sin perdida perceptible. Ese analisis, sin escribir una linea de codigo de enrutamiento, ya recorta factura.

    El siguiente paso solo tiene sentido con volumen. Desarrollar un enrutador propio como el de Ramp requiere ingenieria y mantenimiento continuo; para PYMEs con trafico moderado suele salir mas a cuenta usar librerias y gateways de enrutamiento ya existentes en lugar de construir desde cero. Lo que si conviene a cualquier tamano es instrumentar el gasto: registrar coste, latencia y calidad por tipo de consulta. Sin esos datos, cualquier decision de optimizacion es a ciegas. Evita el error de optimizar coste sacrificando calidad en las tareas que sostienen la experiencia del cliente: ahi el ahorro sale caro.

    Analisis Blixel

    La idea de que una empresa necesita elegir su modelo de IA definitivo esta envejeciendo rapido. Lo que veremos cada vez mas es lo que ha hecho Ramp: tratar los LLM como una cartera de recursos intercambiables, no como una plataforma unica a la que atarse. Es una vision madura y bastante sana, porque reconoce algo que el marketing de los grandes proveedores prefiere ignorar: ningun modelo es el mejor para todo, y el mejor de este trimestre puede no serlo del siguiente.

    Dicho esto, conviene no idealizar el movimiento. Ramp construye este enrutador porque tiene el volumen, el equipo y el problema de coste que lo justifican. Trasladar esa historia como si cualquier empresa debiera fabricar su propio enrutador seria un error. La mayoria no tiene el trafico para amortizar el mantenimiento, y acabaria con una capa fragil que hay que recalibrar cada vez que sale un modelo. El valor real aqui no es la herramienta concreta, sino el habito: medir el gasto por tarea y asignar recursos con criterio. Esa disciplina es replicable a cualquier escala y es donde esta el ahorro genuino. La gestion de multiples LLM no va de tener la ingenieria mas sofisticada, sino de dejar de pagar de mas por costumbre. Ramp lo ha entendido, y esa parte si merece copiarse.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • AWS deja crear politicas de seguridad hablando

    AWS deja crear politicas de seguridad hablando

    Configurar permisos para agentes de IA suele ser un cuello de botella tecnico. Amazon quiere quitarlo del medio: ahora se pueden crear politicas de seguridad en lenguaje natural dentro de Bedrock AgentCore, sin dominar la sintaxis del lenguaje Dogwood. El desarrollador describe en texto plano que puede y que no puede hacer un agente, y el sistema traduce esa descripcion a reglas de acceso y permisos. Es un cambio pequeno en apariencia, pero afecta a quien realmente configura los agentes autonomos en produccion dentro de entornos AWS. Veamos que ha cambiado y a quien le sirve de verdad.

    Que ha pasado y por que importa

    Amazon Web Services ha anadido a su servicio Bedrock AgentCore la capacidad de generar politicas de seguridad Dogwood directamente desde descripciones escritas en lenguaje natural. Hasta ahora, definir reglas de acceso y permisos para un agente de IA exigia conocer la sintaxis especifica del lenguaje de politicas Dogwood, algo que actua como barrera para muchos equipos. Con esta funcionalidad, un desarrollador puede describir en texto plano el comportamiento permitido de un agente y el sistema traduce esa intencion a la politica correspondiente. La caracteristica forma parte del ecosistema Bedrock, la plataforma con la que AWS gestiona agentes autonomos en entornos empresariales.

    El contexto ayuda a entender la jugada. AgentCore es la pieza de AWS orientada a operar agentes de IA en produccion, y la gobernanza de permisos es uno de sus puntos criticos: un agente autonomo con reglas mal definidas puede acceder a datos o ejecutar acciones que no deberia. Reducir la friccion para escribir esas reglas ataca directamente ese riesgo operativo. El movimiento encaja con una tendencia clara: acercar la configuracion de infraestructura a quien conoce el negocio, no solo a quien domina la sintaxis. Al permitir crear politicas de seguridad en lenguaje natural, AWS baja el umbral de entrada para equipos con menos especializacion en su lenguaje de politicas.

    Implicaciones tecnicas para los equipos

    La ventaja practica es que separa la intencion de la implementacion. Antes, para expresar una regla como «este agente solo puede leer facturas, nunca modificarlas», habia que traducirla manualmente a la sintaxis Dogwood. Ahora esa frase puede ser el punto de partida y el sistema genera la politica. Esto acelera la fase de prototipado y reduce errores por desconocimiento de la sintaxis, que son especialmente peligrosos en reglas de acceso: un parentesis mal puesto puede abrir o cerrar permisos que no tocaba.

    Dicho esto, conviene la cautela habitual con la generacion automatica. Una politica de seguridad no es codigo cualquiera: define quien accede a que, y un error silencioso aqui tiene consecuencias directas. La traduccion desde lenguaje natural depende de la precision de la descripcion, y las descripciones ambiguas producen politicas ambiguas. Por eso la funcionalidad no elimina la necesidad de revisar la politica generada, sino que cambia quien puede iniciar el proceso. Crear politicas de seguridad en lenguaje natural es una ayuda para el borrador, no un sustituto de la validacion. Los equipos que traten la salida como definitiva sin auditarla estaran trasladando el riesgo, no eliminandolo. El valor real esta en combinar velocidad de generacion con un paso de revision disciplinado antes de desplegar a produccion.

    Como pueden aplicar esto las empresas hoy

    Si tu empresa ya trabaja con agentes de IA sobre Bedrock AgentCore, el primer paso es identificar quien esta escribiendo hoy las reglas de acceso y cuanto tiempo le cuesta. La funcionalidad para crear politicas de seguridad en lenguaje natural tiene sentido cuando ese trabajo lo hacen perfiles que conocen el negocio pero no la sintaxis Dogwood. Empieza por politicas de bajo riesgo y en entornos de prueba, no por las que gobiernan datos sensibles. Establece desde el principio un flujo de revision: la politica se genera desde texto, pero alguien con criterio tecnico la valida antes de aplicarla. Para evaluar el ROI, mide el tiempo de configuracion antes y despues, y el numero de errores de permisos detectados en revision. Lo que debes evitar es lo tentador: dar por buena la politica generada sin auditarla, o usarla para reglas criticas sin un segundo par de ojos. En una PYME con equipo tecnico reducido, esta funcion puede ahorrar horas de aprendizaje de sintaxis, siempre que la revision no se salte por prisa.

    Analisis Blixel

    Reducir la barrera de sintaxis es util, pero conviene no confundir facilidad con seguridad. Que cualquiera pueda describir una regla en texto plano no significa que esa regla sea correcta, y en gobernanza de agentes autonomos el margen de error es estrecho. El verdadero cuello de botella en muchas empresas no es escribir la politica, sino saber que politica hace falta. Y eso no lo resuelve la traduccion automatica desde lenguaje natural. La funcion brilla en manos de quien ya entiende el modelo de permisos y quiere ir mas rapido; en manos de quien no lo entiende, puede generar una falsa sensacion de control. Nuestra recomendacion es pragmatica: usar la generacion como acelerador del borrador, nunca como autoridad final. Todo lo que toque acceso a datos o ejecucion de acciones debe pasar por revision humana con criterio, sin excepciones. Tambien vale la pena vigilar el efecto de dependencia: cuanto mas comodo resulta describir reglas en texto, menos incentivo hay para entender que hay debajo, y ese conocimiento importa cuando algo falla en produccion. AWS acierta al bajar la friccion, porque la configuracion de permisos ha sido historicamente arida. Pero el mensaje para los equipos es claro: la comodidad de la interfaz no traslada la responsabilidad de la decision. La politica sigue siendo tuya, la escriba quien la escriba.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Stampli usa ChatGPT Work para lanzar antes al mercado

    Stampli usa ChatGPT Work para lanzar antes al mercado

    El caso de usar ChatGPT en el trabajo que presenta Stampli no habla de magia ni de sustituir equipos: habla de recortar los tiempos muertos entre tener una idea y ponerla frente a un cliente. La empresa, dedicada a la automatizacion de cuentas por pagar, ha incorporado ChatGPT Work en su flujo diario para acelerar el paso de la idea al mercado. Es un ejemplo util porque ilustra una aplicacion cotidiana de la IA generativa en un entorno corporativo, sin promesas infladas ni cifras de ciencia ficcion.

    Que ha pasado y por que importa

    Stampli ha explicado publicamente como integra ChatGPT Work en su proceso de desarrollo y lanzamiento de nuevos productos. La idea central es sencilla: reducir la friccion en las fases previas al lanzamiento, esas en las que un equipo redacta especificaciones, documenta, prepara materiales de comunicacion o valida hipotesis. Al apoyarse en ChatGPT en el trabajo, la compania afirma mejorar su eficiencia operativa y su capacidad para iterar mas rapido sobre nuevas ideas.

    El foco no esta en el producto que vende Stampli, sino en como funciona internamente. Y ahi radica el interes para otras empresas: no es una demo de laboratorio, sino un uso sostenido de una herramienta comercial disponible para cualquiera. Conviene, eso si, mantener la perspectiva. Stampli es una empresa tecnologica con equipos acostumbrados a adoptar software nuevo. El grado de mejora que describe depende tanto de la herramienta como de la madurez digital previa de sus procesos, algo que no todas las organizaciones comparten.

    Implicaciones de mercado y de producto

    El valor de usar ChatGPT en el trabajo en un contexto como este no esta en generar texto bonito, sino en comprimir las etapas administrativas y de documentacion que suelen frenar a los equipos de producto. Redactar borradores de especificaciones, resumir feedback de usuarios, preparar variantes de mensajes o esbozar planes de lanzamiento son tareas que consumen horas y que la IA generativa puede acelerar. El resultado buscado es un ciclo idea-mercado mas corto.

    Hay una lectura de mercado clara: las herramientas de IA generativa ya no son un experimento de innovacion aislado, sino parte del stack operativo de empresas de software medianas. Esto normaliza su uso y presiona a los competidores a plantearse lo mismo. La contrapartida es que el diferencial competitivo se estrecha: si todos usan las mismas herramientas para acelerar, la ventaja vuelve a estar en el criterio humano, en que ideas se eligen desarrollar y en la calidad de la ejecucion, no en la velocidad de redaccion.

    La leccion concreta para tu empresa

    Lo aprovechable del caso Stampli no es imitar su producto, sino su enfoque: aplicar ChatGPT en el trabajo a las fases de baja diferenciacion del desarrollo. Empieza por mapear donde se atasca tu equipo entre la idea y el lanzamiento, normalmente en documentacion, resumenes de reuniones, borradores de especificaciones y materiales de comunicacion. Ahi es donde usar ChatGPT en el trabajo ofrece retorno rapido y medible en horas ahorradas.

    Evita dos errores. El primero, delegar decisiones de producto o validaciones criticas a la IA: sirve para borradores y sintesis, no para elegir que construir. El segundo, subir informacion sensible sin una version corporativa que garantice el tratamiento de datos, especialmente si manejas informacion financiera como Stampli. Antes de escalar, mide con un piloto acotado: elige un flujo, cuantifica el tiempo antes y despues, y decide con datos si merece la pena extenderlo al resto del equipo.

    Analisis Blixel

    Lo interesante de estos casos no es el titular, sino lo que revelan por omision. Una empresa acelera su ciclo de producto apoyandose en una herramienta que cualquiera puede contratar hoy mismo. Eso significa que la ventaja no vive en la herramienta, sino en la disciplina de aplicarla donde de verdad hay cuello de botella. La mayoria de organizaciones que prueban la IA generativa fracasan no por la tecnologia, sino por no haber definido antes que problema resolvian.

    La documentacion, los resumenes y los borradores son terreno ideal: alto volumen, baja diferenciacion, riesgo controlado. Es ahi donde el retorno aparece rapido y sin dramas. El error habitual es intentar aplicar la IA a lo espectacular, a la decision estrategica o al lanzamiento en si, cuando el valor real esta en lo aburrido y repetitivo. Otra lectura incomoda: si tu unica ventaja iba a ser ir mas rapido, tienes un problema, porque la velocidad se democratiza en cuanto la herramienta esta al alcance de todos. La ventaja sostenible vuelve al criterio, al conocimiento del cliente y a la ejecucion. Para una PYME espanola, la conclusion es tranquilizadora y exigente a la vez: no necesitas presupuesto de gigante para empezar, pero si necesitas claridad sobre donde duele y honestidad para medir si la IA lo alivia de verdad o solo lo parece.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Seguridad inteligente para APIs FHIR con Bedrock

    Seguridad inteligente para APIs FHIR con Bedrock

    La seguridad inteligente para APIs de salud con Amazon Bedrock propone una forma distinta de proteger los datos clinicos: en lugar de reglas fijas y tablas de mapeo escritas a mano, usa modelos de lenguaje para monitorizar accesos, clasificar la sensibilidad de la informacion y redactar informes de cumplimiento en lenguaje natural. El planteamiento apunta a un problema real de cualquier organizacion sanitaria: abrir el acceso a datos de pacientes a traves de APIs FHIR sin descuidar la proteccion ni disparar la latencia. Aqui repasamos que hace, como funciona por dentro y que pueden extraer de todo esto los equipos que ya operan APIs FHIR en produccion.

    Que ha pasado y por que importa

    La propuesta describe un sistema de seguridad inteligente para APIs de salud con Amazon Bedrock construido sobre tres piezas. La primera es la deteccion de anomalias en los patrones de acceso apoyada en Structured Outputs de Bedrock, que fuerza al modelo a devolver respuestas con un formato predecible y procesable en lugar de texto libre. La segunda es la clasificacion automatica de la sensibilidad de los datos, sin depender de tablas de mapeo hardcodeadas que hay que mantener manualmente cada vez que cambia un flujo clinico. La tercera es la generacion de informes de cumplimiento en lenguaje natural, orientada a reducir el tiempo de preparacion de auditorias.

    El contexto ayuda a entender por que importa. FHIR es el estandar de interoperabilidad sanitaria que permite compartir historiales, resultados y datos de pacientes entre sistemas heterogeneos. Ese acceso abierto es justo lo que un hospital necesita para coordinar cuidados, y a la vez lo que mas riesgo introduce. La tension entre disponibilidad y proteccion es permanente, y las plantillas de reglas estaticas envejecen mal cuando los procesos clinicos evolucionan. Que la clasificacion y la deteccion se adapten solas al cambio, sin frenar las APIs, es el argumento central de esta aproximacion.

    Implicaciones tecnicas de la propuesta

    El detalle interesante para un equipo tecnico es el uso de Structured Outputs. En la seguridad inteligente para APIs de salud con Amazon Bedrock, la deteccion de anomalias no devuelve un parrafo que alguien tenga que interpretar, sino una estructura de datos que un pipeline puede consumir directamente: puntuar un acceso, escalarlo o registrarlo. Esa disciplina de formato es lo que separa un experimento vistoso de algo integrable en un sistema de monitorizacion serio, porque elimina el parseo fragil de texto libre y reduce comportamientos impredecibles del modelo.

    La clasificacion de sensibilidad sin tablas hardcodeadas tiene su cara buena y su cara delicada. La buena: menos mantenimiento y adaptacion a datos que no encajaban en categorias previstas. La delicada: cuando un modelo decide que un campo es altamente sensible, esa decision necesita trazabilidad y validacion, sobre todo en un entorno regulado. La promesa de no afectar a la latencia de las APIs tambien merece escrutinio, porque anadir inferencia al camino de un acceso puede penalizar el rendimiento si no se disena bien la separacion entre lo sincrono y lo asincrono. Son preguntas de arquitectura, no motivos para descartar el enfoque.

    Como pueden aplicar esto las empresas hoy

    Una organizacion sanitaria que ya expone APIs FHIR puede empezar de forma acotada, sin reescribir su seguridad. Lo sensato es aplicar la clasificacion automatica de sensibilidad en modo observacion sobre logs de acceso reales, comparar sus decisiones con las clasificaciones actuales y medir la tasa de discrepancias antes de darle poder de bloqueo. El mismo criterio vale para la deteccion de anomalias: primero alertas, luego automatismos. Sobre el ROI, el punto mas tangible es la generacion de informes de cumplimiento: si tu equipo dedica semanas a preparar auditorias, ahi hay un ahorro medible desde el primer trimestre.

    Que evitar. No pongas inferencia del modelo en el camino sincrono de cada peticion sin medir su impacto en latencia. No confies decisiones de bloqueo a un clasificador sin supervision humana ni registro de auditoria. Y no asumas que un informe redactado por un LLM sustituye la validacion de tu responsable de cumplimiento: es un borrador acelerado, no la firma final. Con esas cautelas, la seguridad inteligente para APIs de salud con Amazon Bedrock es un complemento util a los controles que ya tienes.

    Analisis Blixel

    Lo que de verdad cambia aqui no es que un modelo lea logs, sino que deja de hacer falta mantener a mano el mapa de que dato es sensible y por que. En sanidad ese mapa se desactualiza constantemente: llega un nuevo flujo clinico, un campo cambia de significado, un integrador anade un recurso FHIR que nadie clasifico. Las reglas estaticas siempre van por detras de la realidad, y ese desfase es precisamente donde ocurren las brechas. Delegar la clasificacion a un modelo que se adapta ataca esa raiz.

    Dicho esto, conviene no confundir automatizacion con delegacion ciega. En un sector regulado, cada decision automatica necesita quedar registrada y ser explicable ante un auditor. La parte de informes en lenguaje natural es la mas atractiva comercialmente y a la vez la que mas disciplina exige: un texto bien escrito puede dar sensacion de rigor que el contenido no siempre respalda. El valor real esta en usar el modelo para hacer el trabajo pesado (recopilar, correlacionar, redactar el 80%) y reservar el juicio final a una persona. Para una PYME sanitaria con equipo de seguridad pequeno, esa division del trabajo es la diferencia entre una herramienta que descarga presion y otra que solo desplaza el riesgo. La tecnologia esta lista; la gobernanza alrededor es lo que hay que construir con cabeza.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • La app de Meta AI para Mac ya lee tu pantalla

    La app de Meta AI para Mac ya lee tu pantalla

    La app de Meta AI para Mac llega con dos funciones que la separan de una simple ventana de chat: dictado en todo el sistema y capacidad de leer lo que hay en tu pantalla para responder preguntas sobre ese contexto. Detras esta el modelo Muse Spark. Meta apunta directamente a empresarios y responsables de marketing, permitiendo conectar cuentas de Instagram, Facebook, campanas publicitarias y Google Workspace para consultar metricas y analisis de competencia sin salir del asistente. No es un lanzamiento aislado: encaja en la apuesta declarada de Zuckerberg por vender agentes de IA a empresas.

    Que ha lanzado Meta y por que importa

    Meta ha publicado una aplicacion nativa de Meta AI para Mac cuyas dos capacidades centrales son el dictado a nivel de sistema operativo y el analisis de pantalla. El dictado global permite convertir voz en texto en cualquier aplicacion, no solo dentro del propio asistente. El analisis de pantalla usa el modelo Muse Spark para interpretar lo que el usuario esta viendo en ese momento y responder preguntas contextuales sobre ese contenido concreto. La combinacion convierte la app de Meta AI para Mac en una herramienta que trabaja sobre lo que ya tienes abierto, en lugar de exigirte copiar y pegar informacion.

    El segundo eje del lanzamiento es la integracion con datos de negocio. La aplicacion deja conectar cuentas de Instagram, Facebook, las campanas publicitarias de Meta y Google Workspace. Con esas conexiones, un empresario puede pedir metricas de rendimiento o analisis de competencia mediante consultas en lenguaje natural. Meta encuadra el movimiento dentro de su estrategia para automatizar el soporte al cliente en sus plataformas, en linea con lo declarado por Mark Zuckerberg sobre la oportunidad comercial de vender agentes de IA a empresas.

    Implicaciones tecnicas y de mercado

    El analisis de pantalla mediante Muse Spark es la pieza que mas cambia el flujo de trabajo. Un asistente que ve la pantalla elimina la friccion de describir el contexto: puedes tener abierto el panel de una campana publicitaria y preguntar directamente por lo que aparece. Esto acerca la app de Meta AI para Mac al terreno de los asistentes con conciencia de contexto, un patron que varios fabricantes persiguen en escritorio. El dictado a nivel de sistema, por su parte, es una funcionalidad transversal que compite con las herramientas de dictado nativas del propio sistema operativo.

    En el plano de mercado, lo relevante es la conexion con datos publicitarios y de redes propias. Meta controla Instagram, Facebook y su plataforma de anuncios, asi que integrar esas fuentes en la app de Meta AI para Mac le da una ventaja de datos que un asistente generico no tiene. Sumar Google Workspace amplia el alcance mas alla del ecosistema propio. La jugada refuerza la tesis de Zuckerberg: los agentes de IA vendidos a empresas como capa de consulta y automatizacion sobre datos que ya generan en las plataformas de Meta.

    Como pueden aplicar esto las empresas hoy

    Para una PYME que ya invierte en anuncios de Meta, la app de Meta AI para Mac tiene un uso inmediato: consultar el rendimiento de campanas en lenguaje natural sin pelearse con paneles complejos. Antes de adoptarla conviene evaluar tres cosas. Primero, el ROI real: si tu equipo dedica horas a extraer metricas de Instagram, Facebook y Google Workspace, un asistente que las consolida ahorra tiempo medible; si tu volumen publicitario es minimo, el ahorro sera marginal. Segundo, gobernanza de datos: conectar cuentas de negocio y correo corporativo implica dar acceso a informacion sensible, asi que revisa que datos comparte cada integracion antes de activarla. Tercero, verificacion: el analisis de competencia y las metricas que devuelva Muse Spark deben contrastarse con los paneles oficiales antes de tomar decisiones de presupuesto. Lo que conviene evitar es sustituir tu proceso de reporting por el asistente sin validar sus cifras durante las primeras semanas. Usalo como capa de consulta rapida, no como fuente unica de verdad para decisiones de inversion publicitaria.

    Analisis Blixel

    Poner un asistente a leer la pantalla y a consultar campanas por voz suena util, pero el valor real depende de un detalle poco glamuroso: la calidad de las conexiones de datos. Un asistente que interpreta metricas es tan bueno como el acceso que le des y tan fiable como lo sean sus respuestas, y ahi es donde este tipo de herramientas suele fallar cuando se enfrentan a datos reales y desordenados de una PYME. La estrategia de Meta es coherente y transparente: quiere vender agentes que vivan sobre los datos que sus propias plataformas ya generan. Eso le da una ventaja competitiva evidente, pero tambien concentra mas informacion de negocio y mas correo corporativo en manos de una sola compania. Para el usuario empresarial la pregunta no es si la funcion impresiona en una demo, sino que pasa con la privacidad de sus cuentas conectadas y cuanto puede fiarse de las cifras que recibe sin abrir el panel oficial. Recomendamos probarla con una cuenta acotada, medir el tiempo real que ahorra frente al reporting actual y no delegar decisiones de presupuesto hasta comprobar que las metricas cuadran. La comodidad del lenguaje natural es genuina; la dependencia de un unico proveedor para consultar tu negocio es el coste que hay que pesar. Adoptar con cabeza, no por novedad.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Google mete IA de estudio en Search y Gemini

    Google mete IA de estudio en Search y Gemini

    Las herramientas de estudio con IA de Google aterrizan en el buscador y en Gemini con un objetivo claro: convertirse en el sitio donde los estudiantes buscan, resumen y comprenden material academico. Google ha presentado un conjunto de funcionalidades educativas integradas tanto en Search como en su asistente Gemini, orientadas a facilitar el aprendizaje mediante recursos mejorados y asistencia conversacional. La compania no ha detallado especificaciones tecnicas concretas ni una fecha de disponibilidad general, lo que obliga a matizar cualquier expectativa sobre su alcance real en el corto plazo.

    Que ha anunciado Google y por que importa

    Google ha incorporado nuevas funciones de estudio dentro de dos de sus productos mas usados: el buscador y Gemini. La propuesta se dirige de forma explicita a estudiantes, con la idea de ofrecer acceso a recursos educativos mejorados y a un asistente de IA capaz de acompanar el proceso de aprendizaje. El movimiento encaja en una tendencia que la compania viene reforzando: llevar capacidades generativas a tareas cotidianas donde ya tiene una posicion dominante, como la busqueda de informacion.

    El interes de estas herramientas de estudio con IA de Google no esta solo en el usuario final. Empresas del sector educativo y desarrolladores que construyen aplicaciones academicas observan con atencion como el buscador mas usado del mundo empieza a resolver directamente consultas de estudio que antes derivaban trafico hacia plataformas externas. Conviene, eso si, ser prudentes: sin documentacion tecnica publica ni fecha de lanzamiento confirmada, el anuncio funciona mas como declaracion de intenciones que como producto plenamente evaluable.

    El contexto ayuda a entenderlo. En los ultimos meses varias tecnologicas han competido por posicionar sus asistentes como companeros de aprendizaje, y la educacion se ha convertido en un campo de prueba habitual para la IA generativa por su volumen de usuarios jovenes y su tolerancia a experimentar con formatos nuevos.

    Implicaciones para el sector educativo y los desarrolladores

    Cuando el buscador integra funciones de estudio, cambia el punto de entrada del estudiante. Muchas consultas academicas que hoy terminan en una plataforma de apuntes, un servicio de resumenes o una aplicacion de refuerzo podrian resolverse dentro del propio ecosistema de Google. Para las empresas edtech, esto plantea una cuestion de dependencia estrategica: competir con quien controla el canal de descubrimiento es dificil, y diferenciarse exige aportar valor que la IA generalista no cubre, como acompanamiento pedagogico, correccion humana o contenido curricular verificado.

    Para los desarrolladores, las herramientas de estudio con IA de Google marcan una referencia de expectativas. El listón sobre lo que un estudiante considera util sube: resumir, explicar y generar preguntas de practica pasa a ser funcionalidad basica, no diferencial. La ventaja competitiva se desplaza hacia la integracion con planes de estudio concretos, la trazabilidad de fuentes y la fiabilidad del contenido, precisamente donde los asistentes generalistas siguen siendo debiles. La ausencia de detalles tecnicos impide, por ahora, saber si Google abrira estas capacidades via API o las mantendra cerradas en sus productos.

    Que puede aprender una empresa de este movimiento

    La leccion accionable aqui no es «anade IA a tu producto educativo», sino algo mas concreto: cuando una plataforma dominante absorbe la funcionalidad basica de un sector, el negocio sostenible se construye sobre lo que esa plataforma no puede ofrecer bien. Para una empresa que trabaja con contenido academico, formacion interna o e-learning, esto significa priorizar tres cosas que Google no resuelve de serie: contexto curricular especifico, verificacion de fuentes y seguimiento longitudinal del alumno. Una herramienta que solo resume texto competira directamente con las herramientas de estudio con IA de Google y perdera. Una que estructura un itinerario, valida respuestas frente a material oficial y detecta lagunas de aprendizaje tiene defensa. Antes de invertir en funciones generativas genericas, conviene auditar que aporta realmente el producto frente a un asistente gratuito. Si la respuesta es «lo mismo pero de pago», el problema no se arregla con mas IA.

    Analisis Blixel

    Un anuncio sin especificaciones tecnicas ni fecha de lanzamiento merece cautela, y este lo es. Google comunica una direccion antes que un producto terminado, algo habitual cuando el objetivo es marcar territorio frente a la competencia mas que resolver un problema concreto hoy. Dicho esto, el patron de fondo es real y tiene consecuencias: el buscador esta dejando de ser un directorio de enlaces para convertirse en un lugar donde las respuestas se elaboran dentro. Para el sector educativo eso no es un detalle menor, es un cambio de reglas.

    Lo que nos preocupa no es la IA en la educacion, sino la homogeneizacion. Cuando millones de estudiantes reciben explicaciones generadas por el mismo modelo, con los mismos sesgos y las mismas simplificaciones, se pierde diversidad de fuentes y capacidad critica. Aqui esta la oportunidad para las empresas que no quieran limitarse a replicar lo gratuito: el valor futuro estara en el rigor, no en la comodidad. Verificar, contextualizar y adaptar al curriculo real es dificil de automatizar y, precisamente por eso, es defendible. Nuestra recomendacion a quien opera en formacion o edtech es sencilla: no compitas con Google en generalidad, compite en profundidad. Y no construyas nada critico sobre una funcionalidad de la que ni siquiera existe documentacion publica.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Replit integra GPT-5.6 Luna para crear software

    Replit integra GPT-5.6 Luna para crear software

    La integracion de GPT-5.6 Luna en Replit para crear software abre la creacion de aplicaciones a un publico mas amplio. La plataforma ha anunciado la expansion del acceso a sus herramientas de desarrollo apoyandose en este modelo, con el objetivo de que mas usuarios construyan aplicaciones y programas de forma mas accesible y eficiente. Para quien ya trabajaba con Replit no es un cambio menor, y para quien nunca ha programado puede ser la primera puerta de entrada real. Aqui explicamos que ha cambiado, que implica a nivel tecnico y como una empresa puede aprovecharlo hoy sin quemar presupuesto.

    Que ha pasado y por que importa

    Replit ha anunciado que amplia el acceso a sus herramientas de creacion de software mediante la integracion de GPT-5.6 Luna. En la practica, esto significa que la capacidad de generar y editar aplicaciones dentro de la plataforma deja de estar reservada a un grupo reducido y se extiende a mas usuarios. El argumento central de la compania es doble: mayor accesibilidad para quien no domina el codigo y mayor eficiencia para quien ya programa. La integracion de GPT-5.6 Luna en Replit se posiciona asi como una capa de asistencia que acompana todo el ciclo, desde la idea inicial hasta el producto ejecutable.

    Replit lleva anos construyendo un entorno de desarrollo en el navegador que elimina la friccion de configurar maquinas locales. Ese enfoque siempre atrajo a estudiantes, aficionados y equipos pequenos que necesitaban prototipar rapido. Sumar un modelo de lenguaje al flujo de trabajo es la continuacion logica de esa filosofia: bajar la barrera tecnica. La novedad ahora no es que exista asistencia de IA, sino que el acceso se amplia a mas gente, lo que convierte a la plataforma en una opcion a considerar para perfiles que antes la descartaban por falta de conocimientos tecnicos.

    Implicaciones tecnicas de la integracion

    La integracion de GPT-5.6 Luna en Replit tiene consecuencias concretas en como se trabaja. Un modelo dentro del propio entorno puede generar codigo a partir de instrucciones en lenguaje natural, sugerir correcciones y ayudar a montar la estructura de una aplicacion sin salir de la pantalla. Eso comprime el tiempo entre la idea y el primer prototipo funcional, que es donde suele atascarse quien no tiene experiencia. La eficiencia prometida se traduce en menos tiempo dedicado a tareas repetitivas y en menos dependencia de conocer la sintaxis exacta de un lenguaje.

    Ahora bien, conviene ser realista. Un asistente que genera codigo no elimina la necesidad de revisarlo. El codigo producido por IA puede funcionar en una demo y fallar en produccion, arrastrar problemas de seguridad o generar dependencias dificiles de mantener. La ampliacion del acceso democratiza la creacion, pero no la responsabilidad sobre lo que se despliega. Cuanta mas gente pueda crear software con la integracion de GPT-5.6 Luna en Replit, mas importante sera entender que la supervision humana sigue siendo el cuello de botella que garantiza calidad. La herramienta acelera; no sustituye el criterio.

    Como pueden aplicar esto las empresas hoy

    Para una PYME, el uso mas inmediato de la integracion de GPT-5.6 Luna en Replit es el prototipado rapido. Antes de encargar un desarrollo caro a una consultora, un equipo interno puede montar una version minima de la herramienta que necesita (un panel interno, un formulario conectado a una base de datos, una utilidad puntual) y validar si resuelve el problema real. Eso ahorra dinero al evitar invertir en algo que quiza nadie usara. Para evaluar el ROI, mide el tiempo que hoy tardas en tener un prototipo frente al que tardarias con esta plataforma, no la promesa de marketing.

    Que evitar: no confundas prototipo con producto final. Lo que salga de aqui necesita revision de seguridad y pruebas antes de tocar datos de clientes. Tampoco pongas a un perfil sin ninguna base tecnica a desplegar aplicaciones criticas sin supervision; la accesibilidad no significa ausencia de riesgo. El escenario sensato es un empleado con nociones minimas que prototipa y un tecnico que revisa antes de publicar. Empieza con un caso pequeno y de bajo riesgo, mide resultados y decide despues si escalar.

    Analisis Blixel

    Democratizar la creacion de software suena bien en un titular, pero el matiz esta en que crear no es lo mismo que mantener. Cuando cualquiera puede generar una aplicacion en minutos, el problema se desplaza: ya no es escribir el codigo, es decidir si ese codigo debe existir, quien lo actualiza y quien responde cuando falla. Replit acierta al bajar la barrera de entrada, y ese movimiento tiene valor real para equipos pequenos que llevan anos dependiendo de terceros para cualquier utilidad interna. El riesgo aparece cuando la facilidad se confunde con solidez. Hemos visto a empresas acumular herramientas hechas a medias que nadie documenta y que se vuelven una carga en cuanto la persona que las creo se marcha. La asistencia por IA amplifica ese patron si no hay disciplina. Nuestra recomendacion es concreta: usar estas plataformas para prototipar y validar ideas rapido, y mover a un flujo revisado y mantenible todo lo que vaya a produccion o toque datos sensibles. La accesibilidad es una ventaja competitiva solo si va acompanada de criterio sobre que construir y que dejar de construir. Lo demas es deuda tecnica disfrazada de productividad. Quien entienda esa diferencia sacara partido; quien la ignore acumulara problemas mas rapido que antes.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • El fallo de la IA para descubrir farmacos

    El fallo de la IA para descubrir farmacos

    Los modelos de IA para descubrimiento de farmacos arrastran un problema que rara vez se admite en voz alta: se entrenan con datos que no reflejan la biologia humana real. La startup Vivodyne acaba de poner el dedo en la llaga al abrir lo que llama el mayor centro de datos humanos del mundo cerca de San Francisco. Su tesis es incomoda para buena parte del sector: si alimentas un modelo con datos de pruebas en animales o celulas aisladas, obtendras predicciones que fallan cuando llegan al paciente. La solucion que proponen es generar datos causales a partir de tejido vivo humano cultivado en laboratorio.

    Que ha pasado y por que importa

    Vivodyne ha inaugurado una instalacion que opera laboratorios roboticos llamados HIVE, capaces de cultivar 20 tipos de tejido humano distintos. El objetivo no es fabricar un farmaco concreto, sino producir a escala industrial los datos biologicos humanos que, segun la empresa, faltan en los modelos de IA actuales. La compania sostiene que la mayoria de estos modelos dependen de datos procedentes de ensayos con animales o de celulas individuales, ninguno de los cuales representa fielmente como responde un tejido humano vivo.

    Los datos que aporta la propia empresa son concretos: afirma que sus tejidos hepaticos alcanzan un 94% de precision predictiva frente a ensayos humanos en toxicidad, y que su capacidad de generacion de datos ya duplica el rendimiento de todos los ensayos con animales realizados en Estados Unidos. El planteamiento invierte la logica habitual del sector, que suele centrarse en algoritmos mas grandes. Vivodyne apunta al eslabon anterior: la calidad y la relevancia biologica de los datos de los que se aprende.

    El contexto ayuda a entender la apuesta. Durante decadas, el descubrimiento de farmacos ha usado modelos animales como paso previo a los ensayos clinicos, pese a su limitada capacidad para predecir la respuesta humana. La llegada de la IA prometia acelerar ese proceso, pero un modelo solo es tan bueno como los datos que lo alimentan. Si esos datos proceden de sistemas biologicos que no son humanos, el problema de fondo persiste.

    Implicaciones tecnicas de un cambio en la fuente de datos

    La aportacion tecnica clave de los datos biologicos humanos que defiende Vivodyne es la nocion de causalidad. No se trata solo de tener mas datos, sino datos que capturen como un compuesto afecta a tejido humano real, no correlaciones extraidas de sistemas sustitutos. Para los modelos de IA para descubrimiento de farmacos, esto podria significar predicciones de toxicidad y eficacia mas fiables antes de invertir en ensayos clinicos caros y largos.

    La escala robotica es el segundo elemento diferencial. Cultivar 20 tipos de tejido humano de forma reproducible y automatizada es lo que permite generar volumen suficiente para entrenar o afinar modelos. Un dato aislado de tejido humano tiene valor limitado; miles de puntos de datos consistentes y comparables cambian la ecuacion. El cuello de botella historico en biologia no ha sido la falta de algoritmos, sino la dificultad de producir datos humanos relevantes a gran escala.

    Conviene mantener el escepticismo sano. Las cifras de precision, como ese 94% en toxicidad hepatica, proceden de la propia empresa y aun no cuentan con validacion independiente amplia ni con un historial de farmacos aprobados que hayan seguido este camino de principio a fin. El salto entre un tejido cultivado y un organismo humano completo, con su sistema inmune, su metabolismo y sus interacciones entre organos, sigue siendo enorme. Los datos biologicos humanos mejoran la foto, pero no la completan.

    Cuando y para quien sera relevante esto

    El impacto de esta apuesta no se sentira de forma inmediata ni uniforme. Los primeros beneficiarios seran las farmaceuticas y las biotech que ya invierten en descubrimiento asistido por IA y que buscan reducir la altisima tasa de fracaso en fases clinicas. Para ellas, disponer de datos de tejido humano en las etapas preclinicas puede traducirse en descartar antes compuestos toxicos, algo con un valor economico directo. Ese segmento puede empezar a evaluar estos datos a corto plazo, pero la validacion real llegara solo cuando existan farmacos que hayan recorrido el ciclo completo apoyados en este enfoque, un proceso que se mide en anos.

    Para el ecosistema de IA mas amplio, la leccion es transversal y llega antes: la calidad y la representatividad de los datos de entrenamiento importan mas que el tamano del modelo. Las empresas que construyen IA vertical en cualquier dominio critico haran bien en preguntarse si sus datos reflejan de verdad el fenomeno que quieren predecir. Los datos biologicos humanos son un caso extremo de ese principio general. Para pacientes y sistemas sanitarios, el beneficio potencial (farmacos mas seguros y desarrollados mas rapido) es real pero lejano, y dependera de que las cifras prometidas resistan el escrutinio regulatorio y clinico.

    Analisis Blixel

    Durante anos hemos escuchado que la IA iba a acelerar la medicina, como si el algoritmo fuera la pieza que faltaba. La realidad es mas terca: un modelo entrenado con datos de raton predice, en el mejor de los casos, como responderia un raton. El merito de este planteamiento es que ataca el problema donde de verdad esta, en el sustrato biologico del que aprende la maquina, y no en la enesima arquitectura de red neuronal. Eso es honesto y poco habitual en un sector adicto a las metricas de computo.

    Dicho esto, toca aplicar el filtro que aplicamos a todo. Las cifras que maneja la empresa son suyas y estan por validar de forma independiente. Un 94% de precision en toxicidad hepatica suena excelente, pero el higado es solo un organo, y la toxicidad sistemica de un farmaco emerge de interacciones que un tejido aislado no reproduce. El riesgo aqui no es que la tecnologia no funcione, sino que se venda como una bala de plata cuando es, en realidad, una mejora incremental muy valiosa en una parte del pipeline. Para directivos que evaluan IA en dominios criticos, la moraleja es clara y aplicable fuera de la biotecnologia: antes de comprar el modelo mas potente del mercado, pregunta de que datos aprende y si esos datos se parecen a tu realidad. Esa pregunta, aburrida y poco glamurosa, decide mas proyectos que cualquier benchmark.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • ChatGPT Ads llega a Europa: que cambia para tu empresa

    ChatGPT Ads llega a Europa: que cambia para tu empresa

    La publicidad en ChatGPT en Europa ya es una realidad: OpenAI ha ampliado su programa ChatGPT Ads a varios paises europeos despues de estrenarlo en Estados Unidos. El movimiento abre la puerta a que empresas del continente coloquen mensajes comerciales dentro del asistente conversacional mas usado del mundo. Todavia faltan datos oficiales sobre que paises concretos entran y en que fechas, pero el cambio marca un giro claro en el modelo de negocio de OpenAI y obliga a los equipos de marketing a mirar un canal que hasta ahora no existia. Conviene entender que hay confirmado y que no antes de mover un solo euro de presupuesto.

    Que ha pasado y por que importa

    OpenAI ha extendido su programa de anuncios ChatGPT Ads a territorio europeo tras el lanzamiento inicial en Estados Unidos. En la practica, esto significa que las empresas europeas empiezan a tener acceso a formatos publicitarios dentro de la propia interfaz de ChatGPT, integrados en la experiencia de conversacion con la IA. La publicidad en ChatGPT en Europa supone que un producto que nacio como asistente de pago y freemium incorpora ingresos por anuncios, algo que refuerza su sostenibilidad economica a largo plazo.

    El detalle relevante es lo que aun no sabemos. El anuncio no concreta que paises europeos estan incluidos ni las fechas exactas del despliegue. Tampoco se han publicado formatos, precios, sistema de puja ni metricas de rendimiento. Por eso conviene tratar esta noticia como una senal de direccion, no como un canal listo para invertir. Para el mercado europeo, con normativas de privacidad y publicidad mas estrictas, cada uno de esos detalles pendientes determinara si el canal es viable o queda limitado a mercados concretos.

    Implicaciones tecnicas y de mercado

    La llegada de la publicidad en ChatGPT en Europa introduce un formato distinto al de los buscadores tradicionales. Aqui el usuario no escribe una consulta y recibe diez enlaces con anuncios arriba: mantiene una conversacion. Eso plantea preguntas abiertas sobre como se insertan los anuncios sin romper la utilidad de la respuesta, como se marca lo que es publicidad y como se mide la atribucion cuando el punto de contacto es un dialogo y no un clic clasico.

    Para el mercado, el impacto es doble. Por un lado, OpenAI diversifica ingresos y compite de forma mas directa con el negocio publicitario de Google y Meta, que llevan anos monetizando la atencion. Por otro, los anunciantes europeos se enfrentan a un canal nuevo sujeto al RGPD y a la normativa de publicidad de la UE, lo que condicionara segmentacion, uso de datos y transparencia. La incognita real es el inventario: sin datos de alcance por pais ni de coste, es imposible calcular retorno. La publicidad en ChatGPT en Europa tiene potencial, pero hoy es mas una hipotesis de canal que una linea presupuestaria.

    Como pueden aplicar esto las empresas hoy

    Lo primero es no correr. La publicidad en ChatGPT en Europa no tiene todavia paises confirmados ni formatos publicos, asi que la accion sensata es preparacion, no inversion. Designa a alguien de marketing para que monitorice los anuncios oficiales de OpenAI y confirme si tu pais esta dentro del despliegue antes de asignar presupuesto.

    Mientras tanto, hay trabajo util que hacer. Revisa como aparece tu marca cuando un usuario pregunta por tu sector en ChatGPT: esa visibilidad organica sera la base sobre la que despues encaje cualquier anuncio. Ordena tus datos de cliente y tu cumplimiento RGPD, porque cualquier segmentacion en la UE dependera de ello. Y define desde ya que metrica considerarias exito en un canal conversacional, distinta del CPC clasico. Que evitar: firmar presupuestos sobre expectativas, replicar sin mas la creatividad de buscadores y tratar el anuncio como un banner. Cuando lleguen precios e inventario reales, decidiras con numeros; hasta entonces, prepara el terreno sin gastar.

    Analisis Blixel

    Meter anuncios en un asistente que la gente usa precisamente porque va al grano es una apuesta delicada. El valor de ChatGPT esta en respuestas directas y sin ruido; si la monetizacion contamina esa experiencia, OpenAI arriesga lo unico que le diferencia. El equilibrio entre ingresos y utilidad sera el verdadero campo de batalla, y aun no sabemos de que lado caera.

    Para las empresas espanolas, el consejo es de calma. Que un canal exista no significa que convenga estar en el desde el minuto uno. Los early adopters pagan la curva de aprendizaje: formatos inmaduros, metricas confusas y precios sin referencia de mercado. En un entorno conversacional, ademas, nadie tiene aun un manual de buenas practicas fiable. Tiene mas sentido observar los primeros meses, ver que funciona para otros y entrar cuando haya datos de retorno reales.

    El contexto europeo anade una capa extra. El RGPD y la normativa de publicidad de la UE obligaran a OpenAI a moldear el producto pais por pais, y eso puede traducirse en menos segmentacion o mas restricciones que en Estados Unidos. Es una buena noticia para el usuario y un reto para el anunciante. Nuestra recomendacion: prepara datos, cumplimiento y visibilidad organica ahora, y reserva la inversion para cuando OpenAI publique cifras. La prisa aqui no es una ventaja competitiva, es un riesgo.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.