
Categoría: IA Aplicada

  • Ninth Wave agiliza el onboarding bancario con IA

    Ninth Wave agiliza el onboarding bancario con IA

    El onboarding financiero con IA que ha construido Ninth Wave sobre Amazon Bedrock apunta a un problema concreto: incorporar clientes en servicios financieros abiertos sigue siendo lento, manual y caro. La compania ha montado un sistema que automatiza la verificacion de documentos y la validacion de datos usando modelos de lenguaje preentrenados de Bedrock. El objetivo declarado es reducir los tiempos de espera y descargar de trabajo repetitivo a los equipos de cumplimiento. No es magia ni promesa a futuro: es una implementacion en produccion que conviene mirar con calma antes de copiarla.

    Que ha pasado y por que importa

    Ninth Wave ha desarrollado un sistema de incorporacion de clientes para servicios financieros abiertos apoyado en las capacidades de IA de Amazon Bedrock. La pieza central es el procesamiento de documentos: extraer, leer y validar la informacion que un cliente aporta al darse de alta, sin que un analista tenga que revisar cada campo a mano. Segun la implementacion, esto permite a las empresas financieras automatizar y acelerar los flujos de verificacion y onboarding de nuevos usuarios.

    El onboarding financiero con IA importa porque el alta de clientes es uno de los cuellos de botella mas caros del sector. Cada minuto que un usuario pasa esperando aprobacion es friccion que se traduce en abandono. En finanzas abiertas, donde la propuesta es conectar cuentas y compartir datos entre entidades con permiso del usuario, la velocidad de incorporacion es parte del producto, no un tramite secundario. Amazon Bedrock entra aqui como capa de modelos gestionados: en lugar de entrenar un modelo propio, la empresa consume LLMs ya disponibles para leer documentos y contrastar datos financieros.

    Implicaciones tecnicas de la arquitectura

    La decision tecnica de fondo es usar modelos preentrenados a traves de un servicio gestionado en vez de construir el pipeline de IA desde cero. Amazon Bedrock ofrece acceso a varios LLMs mediante API, lo que evita el coste de infraestructura de GPU y de mantenimiento de modelos. Para un caso de onboarding financiero con IA, eso significa que el esfuerzo se concentra en la integracion, la gobernanza del dato y las reglas de negocio, no en el machine learning en si.

    El punto delicado es la validacion. Un LLM extrae texto de un documento con soltura, pero validar datos financieros exige precision y trazabilidad: en cumplimiento no basta con una respuesta plausible, hace falta poder auditar por que se aprobo o rechazo un alta. Aqui es donde un sistema serio de onboarding financiero con IA necesita capas de verificacion determinista sobre la salida del modelo, controles de alucinacion y registro de decisiones. Bedrock aporta el motor de lenguaje, pero la responsabilidad regulatoria sigue siendo de la entidad. Quien monte algo asi debe asumir que el modelo es un asistente que acelera, no un juez que decide solo.

    Como pueden aplicar esto las empresas hoy

    Una PYME que gestione altas con papeleo puede sacar una leccion directa de este caso, aunque no opere en banca. El patron reutilizable es el mismo: procesamiento de documentos con un LLM gestionado para extraer datos, seguido de reglas propias que validan y deciden. Empieza por un proceso acotado y medible, como verificar facturas, contratos o formularios de alta, donde puedas comparar el tiempo antes y despues.

    En cuanto al ROI, el ahorro real esta en horas de revision manual, no en efectos vagos de experiencia de cliente. Mide cuantos documentos procesa una persona al dia y cuanto cuesta cada error. Lo que hay que evitar es soltar el modelo sin red: nunca dejes que un LLM apruebe o rechaze automaticamente decisiones con impacto legal o economico sin una capa de verificacion y un humano en los casos dudosos. Empieza en modo copiloto, mide la tasa de acierto durante semanas y solo despues automatiza los tramos donde la precision sea consistente. Un onboarding financiero con IA bien montado ahorra tiempo; uno mal montado te crea un problema de cumplimiento.

    Analisis Blixel

    Lo interesante de este caso no es la tecnologia, es la disciplina de no reinventar la rueda. Ninth Wave podria haber intentado entrenar modelos propios y perderse meses en infraestructura; en su lugar consume LLMs gestionados y dedica el esfuerzo a lo que de verdad diferencia, que es la logica de verificacion y el encaje regulatorio. Ese orden de prioridades es el que casi siempre falla en los proyectos que vemos: empresas fascinadas con el modelo y despreocupadas por la gobernanza del dato.

    El punto que ninguna nota de prensa subraya lo suficiente es que en finanzas la responsabilidad no se externaliza. Puedes apoyarte en un proveedor cloud para el motor de lenguaje, pero si un alta fraudulenta pasa el filtro, la sancion la recibe la entidad, no el modelo. Por eso cualquier automatizacion de verificacion debe nacer con trazabilidad y capacidad de auditoria desde el primer dia, no como parche posterior. La tentacion de automatizar el 100 por cien para presumir de cifras es real y peligrosa. El valor esta en automatizar el tramo aburrido y predecible, y reservar el criterio humano para lo ambiguo. Quien entienda esa frontera sacara partido; quien la ignore acabara limpiando decisiones automaticas que nadie puede explicar. La IA en procesos criticos se juzga por lo que hace cuando se equivoca, no por lo rapida que es cuando acierta.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Amazon Quick llega al escritorio en Mac y Windows

    Amazon Quick llega al escritorio en Mac y Windows

    El asistente de IA empresarial de Amazon Quick da un paso importante: ya está disponible de forma general como aplicación de escritorio para macOS y Windows. Hasta ahora vivía sobre todo en móvil y navegador, y llevarlo al ordenador cambia el patrón de uso diario de mucha gente. Amazon suma además un feed de actividades en móvil que junta email, calendario, CRM y mensajería en una sola vista priorizada. La promesa central no es solo comodidad: es mantener los datos dentro del entorno controlado de la empresa en lugar de dejarlos escapar por herramientas no aprobadas.

    Que ha lanzado Amazon y por que importa

    Amazon Quick pasa a disponibilidad general con dos novedades concretas. La primera es la aplicación de escritorio nativa para macOS y Windows, que lleva el asistente al lugar donde los profesionales pasan la mayor parte de la jornada. La segunda es un feed de actividades en la versión móvil que consolida email, calendario, CRM y mensajería en una vista única y priorizada, en lugar de obligar al usuario a saltar entre aplicaciones para reconstruir el contexto de su día.

    El asistente de IA empresarial de Amazon Quick funciona sobre AWS y llega con certificaciones de cumplimiento relevantes: HIPAA, FedRAMP, SOC 2 e ISO 27001. Esto no es un detalle menor para sectores como sanidad, sector público o finanzas, donde el cumplimiento normativo condiciona qué herramientas se pueden desplegar. Amazon también incorpora trazabilidad completa a través de Amazon CloudWatch y AWS CloudTrail, de forma que cada interacción queda registrada y auditable. El mensaje comercial es claro: dar a los empleados un asistente potente sin ceder el control sobre dónde acaban los datos corporativos.

    Implicaciones tecnicas y el problema del shadow AI

    La jugada de fondo del asistente de IA empresarial de Amazon Quick es atacar el llamado shadow AI: el uso de herramientas de IA no aprobadas por parte de empleados que, buscando productividad, pegan información sensible en servicios de terceros sin ningún control. Ese fenómeno es hoy uno de los mayores dolores de cabeza para los equipos de seguridad, porque ocurre de forma invisible y difícil de rastrear. Al ofrecer un asistente que vive dentro del perímetro de AWS, Amazon intenta darle a las empresas una alternativa oficial que compita en comodidad con las herramientas de consumo.

    Técnicamente, la combinación de certificaciones (HIPAA, FedRAMP, SOC 2, ISO 27001) con auditoría vía CloudWatch y CloudTrail permite que los equipos de TI justifiquen el despliegue ante compliance y respondan a auditorías con registros concretos. El feed de actividades, por su parte, apunta a un patrón cada vez más común: los asistentes ya no son un chat aislado, sino una capa que lee tu contexto de trabajo (correo, agenda, CRM) y lo organiza. La app de escritorio reduce la fricción de tener que abrir el navegador, un factor que en la práctica decide si una herramienta se usa a diario o se abandona.

    Como pueden aplicar esto las empresas hoy

    Para una empresa que ya opera sobre AWS, el asistente de IA empresarial de Amazon Quick es una opción a evaluar antes de firmar con proveedores externos, porque reduce el número de terceros con acceso a datos sensibles. El primer paso sensato es un piloto acotado: un departamento con datos regulados (por ejemplo atención al cliente o un equipo con historiales sensibles) donde el argumento de cumplimiento pese de verdad. Mida dos cosas: adopción real (¿la gente lo abre a diario tras instalar la app de escritorio?) y reducción efectiva del shadow AI, revisando si baja el uso de herramientas no aprobadas.

    Qué evitar: no lo despliegue como sustituto universal sin comprobar que se integra con su CRM y correo actuales, porque el feed de actividades solo aporta valor si conecta con sus fuentes reales. Y no dé por hecho el ROI: el ahorro no viene del asistente en sí, sino de evitar fugas de datos y del tiempo recuperado al no saltar entre aplicaciones. Cuantifique ambos antes de escalar. Si su stack no está en AWS, el coste de integración puede diluir la ventaja.

    Analisis Blixel

    El verdadero campo de batalla ya no es qué modelo responde mejor, sino quién controla el contexto de trabajo del empleado. Amazon lo tiene claro: no vende un chatbot, vende una capa que se cuela en el correo, el calendario y el CRM, y que además queda anclada al ordenador con una app nativa. Esa es una decisión de producto muy consciente, porque la comodidad es lo que gana la guerra contra el shadow AI, no los discursos sobre seguridad. Un empleado usa la herramienta oficial solo si es tan cómoda como la que se descargaría por su cuenta.

    La baza de cumplimiento (HIPAA, FedRAMP, SOC 2, ISO 27001) es sólida y sincera para sectores regulados, y la trazabilidad vía CloudTrail y CloudWatch es exactamente lo que pide un responsable de seguridad. Pero conviene no confundir certificaciones con garantías mágicas: la trazabilidad sirve si alguien revisa los registros, no por existir. El riesgo real para el comprador es el bloqueo: cuanto más contexto viva dentro de AWS, más caro es salir. Para quien ya está en ese ecosistema, es una evolución lógica y bienvenida. Para quien no, es una invitación a profundizar una dependencia que conviene calcular con calma. La conveniencia siempre tiene un precio, y aquí se paga en integración.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Amazon automatiza los cuestionarios RFI con Quick Automate

    Amazon automatiza los cuestionarios RFI con Quick Automate

    La automatizacion de cuestionarios RFI con Amazon Quick Automate apunta a un dolor concreto de cualquier empresa que gestiona licitaciones: rellenar y procesar los mismos formularios una y otra vez. Amazon ha publicado una guia para construir flujos de trabajo end-to-end que gestionan los procesos de Request for Information dentro del ecosistema de servicios de automatizacion de AWS. La promesa es directa: menos horas manuales recopilando datos de proveedores y una forma estandarizada de tratar cuestionarios repetitivos. Aqui repasamos que ofrece realmente, sus limites y a quien le compensa mirarlo.

    Que ha publicado Amazon y por que importa

    Amazon ha documentado como montar un flujo de trabajo completo para cuestionarios RFI usando Quick Automate, el servicio de la casa orientado a automatizar procesos empresariales repetitivos. Un RFI (Request for Information) es la fase previa en muchas compras y licitaciones: la empresa pide informacion a varios proveedores para comparar capacidades antes de avanzar a una propuesta formal. Cuando se manejan decenas de estos procesos, la recopilacion y el tratamiento de respuestas consume tiempo administrativo considerable.

    La guia describe la creacion de un flujo end-to-end que cubre desde la entrada de la informacion hasta su procesamiento estandarizado, sin depender de que una persona copie y pegue datos entre documentos. La automatizacion de cuestionarios RFI con Amazon Quick Automate se integra en el conjunto de herramientas de AWS dirigidas a optimizar tareas administrativas. El contexto es claro: los grandes proveedores cloud llevan tiempo empujando funciones que sacan la automatizacion de manos de los equipos de IT y la acercan a perfiles de negocio y compras, donde vive el problema real.

    Implicaciones tecnicas y de mercado

    Lo interesante de la automatizacion de cuestionarios RFI con Amazon Quick Automate no es la tecnologia en si, sino donde se coloca. Un flujo end-to-end bien montado elimina los puntos de friccion tipicos: recepcion dispersa de respuestas, formatos incoherentes y reentrada manual de datos. Estandarizar la recopilacion de informacion de proveedores permite comparar sobre la misma base y reduce errores de transcripcion, que en un proceso de licitacion pueden tener coste real.

    En el plano de mercado, esta pieza encaja en la estrategia de AWS de cubrir procesos de negocio completos y no solo ofrecer bloques de infraestructura. Para empresas ya asentadas en AWS, mantener el flujo RFI dentro del mismo entorno evita integraciones externas y simplifica gobernanza de datos. El reverso es la dependencia: cuanto mas se automatiza dentro de un unico proveedor, mas cuesta salir. Conviene medir si el ahorro operativo compensa ese amarre, sobre todo en organizaciones con estrategias multi-cloud o con requisitos de portabilidad. La documentacion tecnica facilita el arranque, pero no elimina el trabajo de disenar bien el proceso antes de automatizarlo.

    Como pueden aplicar esto las empresas hoy

    Si tu empresa lanza o responde muchos RFI, el primer paso no es tecnico sino de proceso: mapea cuantos cuestionarios gestionas al mes, cuanto tiempo consume cada uno y donde estan los cuellos de botella. Solo con esos numeros puedes estimar el ROI de la automatizacion de cuestionarios RFI con Amazon Quick Automate. Si gestionas dos licitaciones al ano, no compensa; si son varias al mes con equipos dedicados, el ahorro es tangible.

    Empieza automatizando un unico flujo bien acotado antes de escalar a todo el area de compras. Estandariza primero el formato de los cuestionarios: automatizar un proceso caotico solo produce caos mas rapido. Evita el error clasico de replicar digitalmente un procedimiento manual defectuoso en lugar de rediseñarlo. Valora tambien el coste real: licencias, tiempo de configuracion y formacion del equipo de compras que usara el flujo. Para PYMEs sin equipo AWS interno, lo sensato es apoyarse en un partner para la puesta en marcha y quedarse con el mantenimiento una vez el flujo funciona.

    Analisis Blixel

    Hay una tentacion clara con cada anuncio de automatizacion: pensar que la herramienta resuelve el problema. No lo hace. Un flujo de trabajo para RFI es tan bueno como el proceso que hay detras, y la mayoria de departamentos de compras arrastran procedimientos improvisados que nadie ha documentado nunca. Digitalizar eso sin ordenarlo antes es tirar dinero con mas eficiencia.

    Dicho esto, el caso de uso es de los honestos. Los RFI son repetitivos, estructurados y con alto volumen en empresas medianas y grandes: exactamente el tipo de tarea donde la automatizacion aporta sin humo. No estamos ante nada rompedor tecnicamente, y esa es precisamente su virtud. Es fontaneria empresarial util, no un salto de gigante.

    El punto que nos preocupa es el de siempre con AWS: la comodidad de tenerlo todo dentro se paga con dependencia. Para una empresa ya volcada en su nube, adelante. Para quien esta empezando y valora su libertad de movimiento, conviene pensar dos veces antes de meter tambien los procesos de negocio en el mismo saco. Nuestra recomendacion es pragmatica: mide el volumen real de RFI que gestionas, arregla el proceso antes de automatizarlo y automatiza solo lo que de verdad te quita horas cada semana. Si no cumples esas tres condiciones, este anuncio no es para ti todavia.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Codex y ChatGPT para buscar antibioticos nuevos

    Codex y ChatGPT para buscar antibioticos nuevos

    El descubrimiento de farmacos con IA vuelve a estar en el foco tras conocerse que un investigador ha combinado Codex y ChatGPT para rastrear moleculas antimicrobianas potenciales. El metodo automatiza el analisis de estructuras quimicas y predice propiedades de compuestos que nadie habia explorado a fondo. No es un laboratorio farmaceutico con presupuesto millonario: es una persona usando herramientas de IA generativa de proposito general para atacar un problema que suele costar anos y mucho dinero. Ese detalle es justo lo que merece atencion, mas alla del titular sobre nuevos antibioticos.

    Que ha pasado y por que importa

    Un investigador ha desarrollado un flujo de trabajo que une dos herramientas conocidas: Codex, orientado a generar y ejecutar codigo, y ChatGPT, como motor de razonamiento y consulta. El objetivo es identificar moleculas antimicrobianas candidatas mediante el analisis automatizado de estructuras quimicas. El planteamiento usa modelos de lenguaje para procesar bases de datos quimicas y predecir que compuestos, aun sin estudiar, podrian tener propiedades antibacterianas.

    El contexto explica el interes. El desarrollo de nuevos antibioticos es lento, caro y poco rentable para la industria, mientras la resistencia bacteriana avanza y deja sin efecto tratamientos que antes funcionaban. Cualquier metodo que estreche el embudo inicial (decidir que compuestos vale la pena sintetizar y probar) tiene valor. Aqui, el descubrimiento de farmacos con IA no reemplaza el laboratorio: acota el espacio de busqueda antes de gastar recursos fisicos.

    Conviene matizar el alcance. Se trata de una prediccion computacional de candidatos, no de moleculas validadas en ensayos. La distancia entre un compuesto senalado por un modelo y un farmaco aprobado es enorme: sintesis, pruebas in vitro, toxicidad, ensayos clinicos. El merito esta en el metodo y en quien lo ejecuta, no en un antibiotico listo para usar.

    Implicaciones tecnicas de usar LLM en quimica

    Tecnicamente, lo interesante es el uso de modelos de lenguaje generalistas para una tarea que tradicionalmente pedia modelos especializados en quimica y bibliotecas dedicadas. Codex genera el codigo que consulta y filtra bases de datos quimicas, y ChatGPT actua como capa de razonamiento para interpretar estructuras y priorizar candidatos. Es un ejemplo de orquestacion: cada herramienta hace una parte y el investigador conecta el flujo. El descubrimiento de farmacos con IA se apoya menos en un unico modelo magico y mas en encadenar capacidades.

    La contrapartida son las limitaciones. Los LLM alucinan, y en quimica una alucinacion puede ser una molecula inexistente, una propiedad inventada o una interpretacion erronea de una estructura. Sin validacion experimental posterior, las predicciones son hipotesis, no resultados. La calidad depende por completo de las bases de datos usadas y de como se disenen las comprobaciones. Un flujo asi necesita filtros, verificacion cruzada y criterio humano experto en cada paso; de lo contrario produce ruido con apariencia de rigor.

    Que puede aprender una empresa de este caso

    La leccion accionable no es «pon ChatGPT a buscar antibioticos», sino como una persona resuelve un problema tecnico costoso combinando herramientas genericas en lugar de esperar una plataforma vertical carisima. Si en tu empresa hay tareas que dependen de cruzar bases de datos, filtrar candidatos y priorizar segun reglas complejas, el patron es replicable: usar un modelo para generar el codigo de consulta y otro (o el mismo) para razonar sobre los resultados.

    El detalle no obvio es el orden de trabajo. Este caso funciona porque el experto sabe que pregunta hacer y como validar la respuesta. Trasladado a una PYME: la IA generativa acorta la fase de exploracion, pero no sustituye el conocimiento de dominio ni el paso de verificacion. Antes de invertir en una herramienta especializada, merece la pena probar si un flujo con modelos de proposito general y buenos datos ya cubre el 80% del problema. Empieza por una tarea acotada, mide aciertos frente a un metodo manual y no dejes ninguna salida del modelo sin comprobar por una persona que entienda el terreno.

    Analisis Blixel

    Lo mas valioso de esta historia se pierde si solo miramos el titular sobre antibioticos. Un individuo, sin la infraestructura de una farmaceutica, ha montado un flujo funcional encadenando herramientas que cualquiera puede usar. Ese es el cambio real: la barrera de entrada para explorar problemas complejos ha bajado, y con ella la excusa de «no tenemos medios». Ahora bien, hay que ser honestos con lo que esto es y lo que no es. Predecir candidatos no es descubrir un farmaco. Entre la lista que escupe un modelo y una pastilla en la farmacia hay anos de sintesis, ensayos y regulacion, y la inmensa mayoria de candidatos se caen por el camino. Vender esto como «IA que crea antibioticos» es exactamente el tipo de exageracion que resta credibilidad al sector. Para las empresas el mensaje es doble. Por un lado, animarse: combinar modelos generalistas con datos propios y criterio experto rinde mas de lo que parece y cuesta poco empezar. Por otro, prudencia: sin validacion posterior, un flujo asi genera confianza falsa. La IA acelera la parte de hipotesis, que suele ser la mas tediosa, pero traslada la responsabilidad a quien comprueba. Quien entienda esa division del trabajo sacara partido. Quien espere que el modelo decida solo acabara persiguiendo resultados que no existen.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Poner los datos a trabajar ya no es cosa de expertos

    Poner los datos a trabajar ya no es cosa de expertos

    La idea de poner los datos a trabajar sin depender de un equipo de analistas lleva anos rondando el discurso corporativo, y por fin empieza a acercarse a la realidad operativa. La combinacion de interfaces en lenguaje natural, agentes capaces de consultar bases de datos y herramientas de autoservicio esta bajando la barrera tecnica. Pero conviene separar lo que ya funciona de lo que sigue siendo aspiracional. Este analisis repasa que significa realmente democratizar el acceso a la informacion, quien se beneficia primero y que expectativas es sensato tener antes de invertir tiempo y presupuesto en ello.

    Que esta pasando y por que importa

    Durante decadas, consultar los datos de una empresa exigia conocer SQL, entender el modelo de datos y esperar a que un analista tuviera hueco en su cola de peticiones. Ese cuello de botella dejaba a la mayoria de los trabajadores fuera de sus propios numeros. La promesa actual de poner los datos a trabajar pasa por eliminar ese intermediario tecnico: preguntar en lenguaje natural y recibir una respuesta con su grafico correspondiente.

    El cambio importa porque redistribuye quien puede tomar decisiones informadas. Un responsable de tienda, un jefe de compras o un comercial dejan de depender de un informe semanal para consultar lo que necesitan en el momento. La informacion se vuelve accionable cuando llega a quien decide, no cuando llega tarde a un correo.

    El antecedente es claro: las herramientas de business intelligence llevan anos prometiendo autoservicio, pero en la practica seguian requiriendo formacion especifica. Lo nuevo no es el concepto, sino que la capa de lenguaje natural empieza a hacer viable esa promesa para perfiles no tecnicos, siempre que los datos de base esten razonablemente ordenados.

    Implicaciones tecnicas de democratizar el acceso

    Poner los datos a trabajar de forma masiva no es solo un problema de interfaz. Detras de cada consulta en lenguaje natural hay retos serios: la calidad de los datos, la coherencia de las definiciones y la gobernanza de quien puede ver que. Una respuesta convincente generada sobre datos sucios es mas peligrosa que no tener respuesta, porque transmite falsa confianza.

    El segundo reto es la interpretacion. Un sistema que traduce preguntas a consultas puede acertar en la sintaxis y equivocarse en la semantica: confundir dos metricas parecidas, aplicar el filtro temporal incorrecto o ignorar un caso limite. Sin trazabilidad de como se llego al numero, el usuario no tiene forma de detectar el error.

    Por eso, poner los datos a trabajar de manera fiable exige capas que muchas veces se ignoran en las demos: un catalogo de metricas definidas, control de accesos por rol y la posibilidad de auditar cada respuesta. La tecnologia de consulta avanza rapido, pero la fontaneria de datos que la sostiene sigue siendo el factor que separa un despliegue util de uno decorativo.

    Cuando y para quien sera relevante esto

    El horizonte realista es escalonado. Las organizaciones que ya tienen sus datos centralizados y con definiciones consistentes pueden empezar a poner los datos a trabajar en autoservicio de forma inmediata; para ellas la capa de lenguaje natural es un anadido natural. Son la minoria.

    La mayoria de PYMEs vive en un estado intermedio: datos repartidos entre hojas de calculo, un ERP, una herramienta de facturacion y varios SaaS que no se hablan entre si. Para estas empresas el beneficio no llegara con comprar una herramienta de consulta, sino primero con ordenar y conectar sus fuentes. Ese trabajo previo, poco glamuroso, es el que determina si la democratizacion funciona o se queda en una pantalla bonita que nadie usa.

    Los primeros beneficiarios claros son los equipos operativos con preguntas repetitivas y bien acotadas: ventas por periodo, stock por producto, morosidad por cliente. Los casos ambiguos o estrategicos seguiran necesitando criterio humano. Conviene empezar por lo concreto y medir uso real antes de ampliar.

    Analisis Blixel

    Hay una trampa recurrente en este tipo de anuncios: se vende el interfaz brillante y se oculta el trabajo aburrido que lo hace funcionar. Democratizar el acceso a la informacion es un objetivo legitimo y valioso, pero el orden de los factores importa. Ninguna capa de lenguaje natural arregla unos datos mal definidos; solo hace mas rapido llegar a la conclusion equivocada.

    Nuestra recomendacion es incomoda porque va contra el impulso de comprar herramienta primero. Antes de habilitar consultas para toda la plantilla, merece la pena invertir en tres cosas: definiciones unicas de las metricas clave, control de accesos serio y una fuente de datos consolidada aunque sea modesta. Con esa base, incluso una herramienta sencilla rinde. Sin ella, la mas avanzada genera ruido y desconfianza.

    Tambien conviene gestionar expectativas internas. Poner la informacion en manos de todos no elimina la necesidad de criterio; la traslada. Los usuarios necesitan saber que puede fallar una respuesta automatica y como verificarla. Formar en lectura critica de datos es tan importante como desplegar la tecnologia.

    La direccion es correcta y el momento, oportuno. Pero el valor no esta en el titular sobre democratizar el dato, sino en la disciplina de preparar el terreno. Las empresas que lo entiendan sacaran ventaja real; las que compren la promesa sin la base acumularan decepcion y una suscripcion mas.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • El iPhone plegable imprime su bisagra con IA en 3D

    El iPhone plegable imprime su bisagra con IA en 3D

    La fabricacion con IA e impresion 3D deja de ser un experimento de laboratorio para entrar en la produccion masiva de un dispositivo de consumo. Apple ha presentado el iPhone Duo, su primer telefono plegable, cuya pieza mas critica —la bisagra— se disena y fabrica mediante algoritmos de inteligencia artificial combinados con impresion 3D de alta resolucion. El objetivo declarado es la durabilidad: cada bisagra se ajusta de forma individual a su carcasa. No es marketing sobre un chip mas rapido, sino un cambio en como se produce el hardware. Y ahi hay lecciones concretas para cualquier fabricante.

    Que ha hecho Apple y por que importa

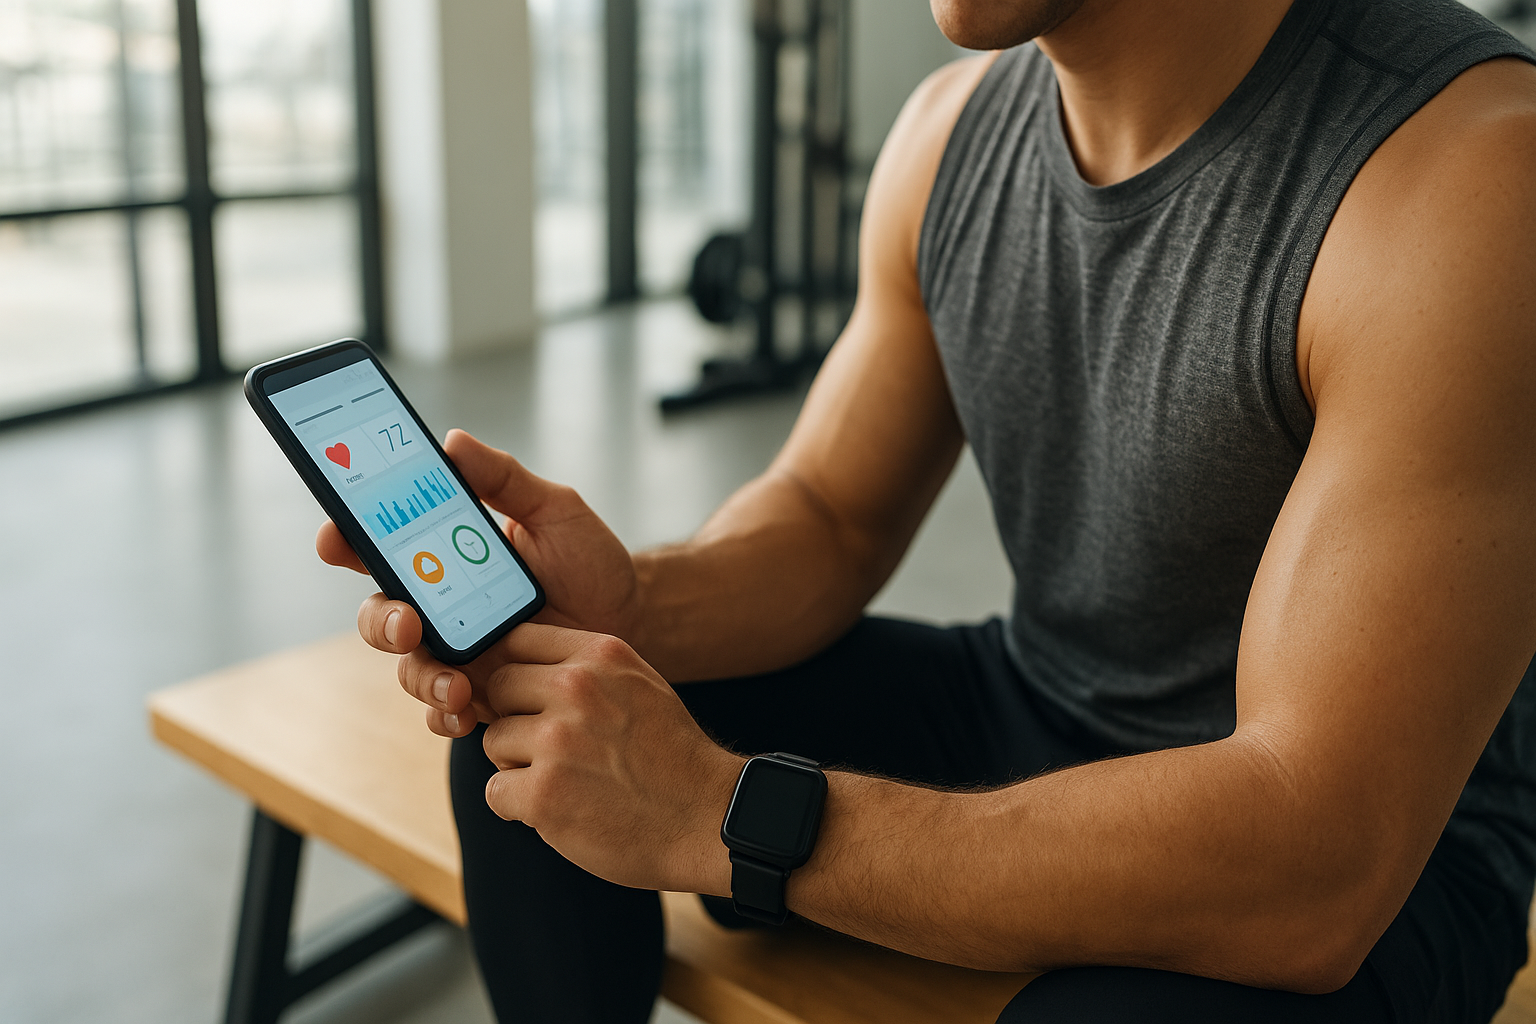
    La fabricacion con IA e impresion 3D se aplica aqui a un problema real de ingenieria: las bisagras de los plegables sufren tension mecanica constante y son el punto de fallo mas habitual en esta categoria de dispositivos. Segun Johny Srouji, director de hardware de Apple, el proceso usa escaneo laser confocal para medir cada carcasa e imprime hasta 25 microcapas de fotopolimero personalizado sobre la pieza. El sistema elimina las ondulaciones residuales del material y garantiza una alineacion perfecta en cada unidad fabricada, no en un prototipo ideal.

    El matiz clave es la personalizacion unidad a unidad. En manufactura tradicional se fabrica una pieza estandar y se descartan las que no cumplen tolerancias. Aqui, la IA lee las variaciones reales de cada carcasa concreta y adapta la impresion a ellas. Los plegables llevan anos arrastrando problemas de fiabilidad en las bisagras, con pliegues visibles y mecanismos que se degradan. Que Apple ataque ese punto desde el proceso de produccion, y no solo desde el diseno, indica donde esta ahora la ventaja competitiva en hardware.

    Implicaciones tecnicas del proceso

    La fabricacion con IA e impresion 3D combina tres tecnologias que hasta hace poco vivian separadas: metrologia de alta precision (el escaneo laser confocal), modelado algoritmico que decide como compensar cada variacion, y fabricacion aditiva capaz de depositar microcapas de fotopolimero con control micrometrico. La suma convierte un defecto habitual —que no hay dos carcasas identicas— en una entrada del sistema, no en un problema a corregir despues.

    El impacto va mas alla del telefono. Un proceso que mide, calcula y fabrica adaptandose a cada pieza reduce el desperdicio y la tasa de rechazo, dos costes que en produccion a gran escala son enormes. Las 25 microcapas de fotopolimero personalizado sugieren un control de tolerancias que la mecanizacion convencional no alcanza sin encarecerse. Para el sector, la senal es clara: la fabricacion con IA e impresion 3D empieza a ser viable en volumen alto, no solo en piezas unicas o series cortas. El cuello de botella deja de ser el molde estandar y pasa a ser la calidad del dato de medicion y del modelo que lo interpreta.

    Que puede aprender una PYME industrial de esto

    La leccion util no es imprimir bisagras, sino el principio detras del proceso: medir cada pieza real y adaptar la fabricacion a sus variaciones en lugar de forzarla a un estandar unico. Un taller de mecanizado o un fabricante de componentes puede aplicar esta logica sin el presupuesto de Apple. El primer paso barato es la metrologia: incorporar escaneo 3D o palpadores a la inspeccion para generar datos reales de dispersion de cada lote. Con ese dato, un modelo sencillo ya puede detectar patrones de desviacion antes de que se conviertan en piezas rechazadas.

    La impresion 3D de fotopolimero para produccion sigue siendo cara y lenta para muchos volumenes, asi que no conviene copiar el metodo, sino la estrategia: usar IA para reducir la tasa de rechazo en el proceso que ya se tiene. Antes de invertir, mide cuanto pierdes hoy en piezas defectuosas y reprocesos; ese numero define si el retorno existe. Lo que hay que evitar es comprar una impresora 3D industrial esperando que resuelva sola un problema de calidad que en realidad es de medicion y control.

    Analisis Blixel

    Lo interesante de este anuncio no es que exista otro plegable mas en el mercado, sino donde ha decidido Apple poner la inteligencia artificial: en la fabrica, no en la pantalla. Mientras casi toda la conversacion sobre IA gira en torno a chatbots y asistentes, la aplicacion mas rentable a corto plazo para la mayoria de empresas industriales sigue siendo esta, la que optimiza un proceso fisico y reduce costes medibles. Es menos vistoso y mucho mas util.

    La trampa habitual es leer noticias asi y concluir que hay que comprar impresoras 3D. No es eso. El valor esta en el circuito completo: medir la realidad, modelarla y actuar sobre ella. Ese bucle es reproducible a escalas mucho mas modestas, y ahi es donde una PYME manufacturera espanola puede ganar terreno sin competir con presupuestos de multinacional. El requisito previo, casi siempre ignorado, es tener datos de calidad sobre el propio proceso. Sin metrologia decente no hay modelo que valga.

    Tambien conviene ser realista con los plazos. Apple lleva anos y miles de millones puliendo su cadena de fabricacion; una empresa mediana no replica eso en un trimestre. Pero puede empezar por lo pequeno y medible: identificar el defecto que mas dinero cuesta, instrumentar esa fase y aplicar analitica antes de saltar a fabricacion aditiva. La tecnologia de consumo, una vez mas, senala el camino que la industria puede recorrer con recursos proporcionados a su tamano.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Apple calcula tu ‘edad de salud’ desde el iPhone

    Apple calcula tu ‘edad de salud’ desde el iPhone

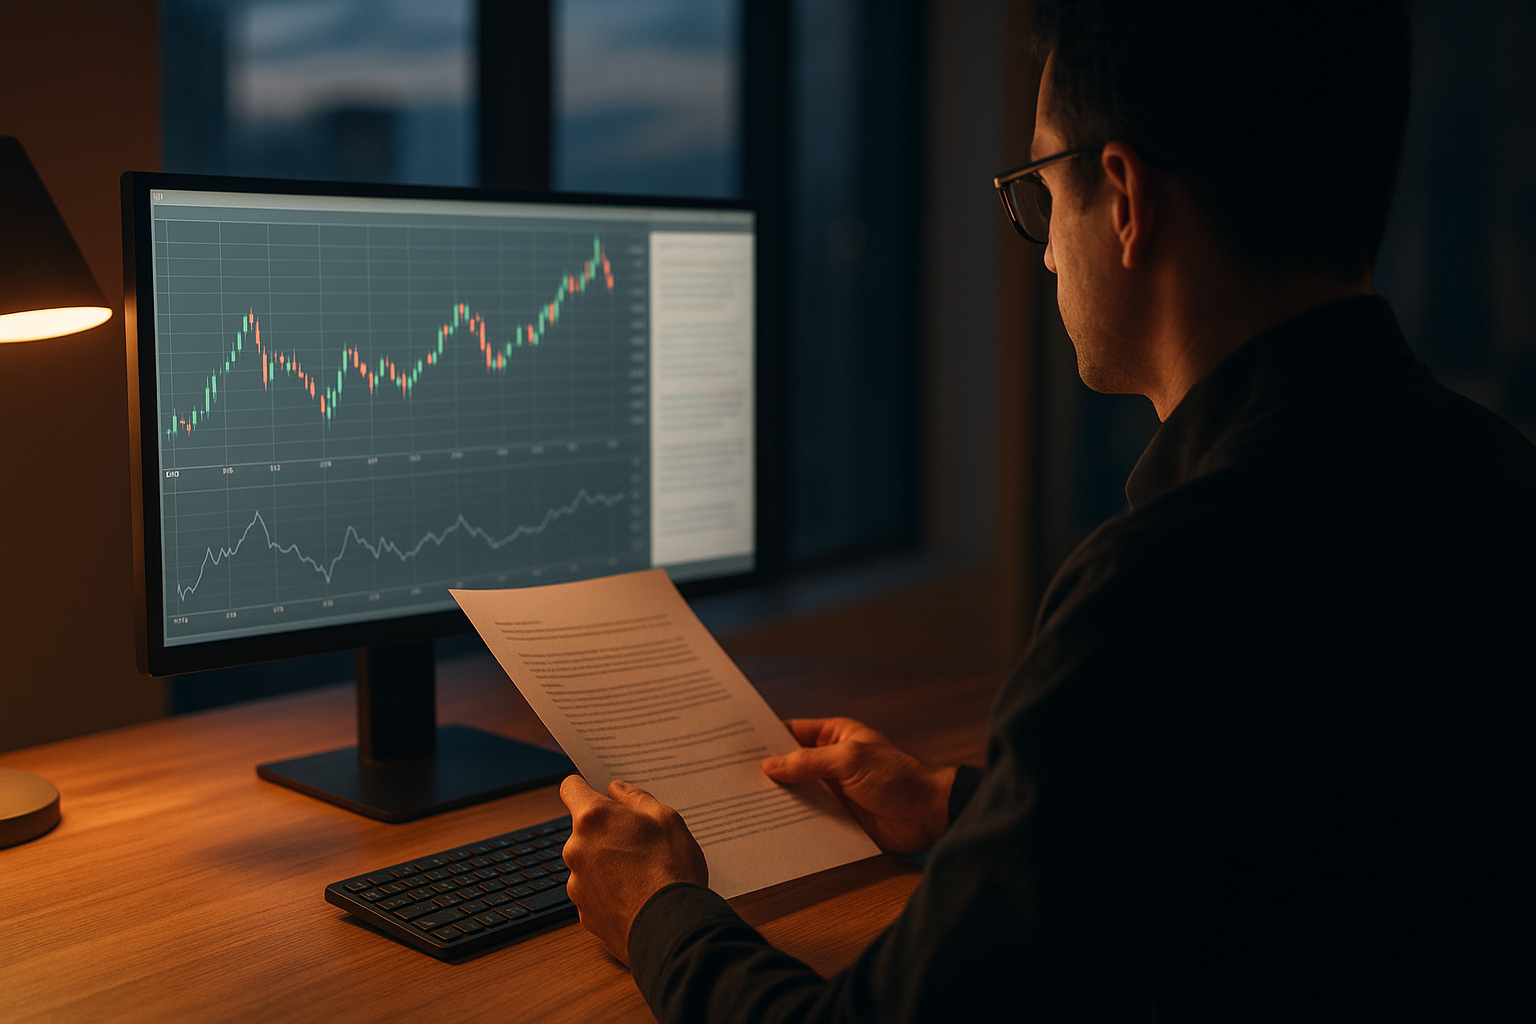
    La nueva edad de salud en Apple Health llega para traducir un monton de datos biometricos dispersos en una sola cifra que cualquiera entiende. Apple ha rediseñado su app Health para calcular automaticamente una ‘edad de salud’ y una puntuacion de preparacion fisica a partir de los sensores del iPhone y el Apple Watch. La funcion se estrenara en la proxima version de iOS para dispositivos compatibles. Mas alla del gadget para consumidores, la jugada abre la puerta a que desarrolladores de apps medicas y empresas del sector integren estas metricas en sus propios productos.

    Que ha anunciado Apple y por que importa

    Apple ha actualizado su aplicacion Health con dos funciones centrales: el calculo automatico de la ‘edad de salud’ del usuario y una puntuacion de preparacion fisica, ambas basadas en datos biometricos recogidos por los sensores del dispositivo. La ‘edad de salud’ compara el estado del usuario con parametros de referencia y devuelve una cifra que puede coincidir o no con la edad cronologica real. La puntuacion de preparacion fisica resume el nivel de forma en un indicador unico. Todo ello estara disponible en la proxima version de iOS, limitado a iPhone compatibles con los sensores de salud necesarios.

    El movimiento consolida el ecosistema de salud digital que Apple lleva anos construyendo alrededor de Health y del Apple Watch. Desde el ritmo cardiaco hasta el sueño o la actividad fisica, la compañia acumula categorias de datos que hasta ahora vivian en graficas separadas. Con la nueva edad de salud en Apple Health, esos datos se sintetizan en metricas comprensibles. Para el sector, la relevancia no esta tanto en la cifra como en la infraestructura: HealthKit ya permite que apps de terceros lean y escriban informacion sanitaria con permiso del usuario.

    Implicaciones tecnicas para desarrolladores y sector salud

    La actualizacion permite que empresas del sector salud y desarrolladores de apps medicas integren metricas mas avanzadas en sus productos apoyandose en el ecosistema de Apple. En la practica, una app de seguimiento de pacientes, un servicio de teleconsulta o una plataforma de bienestar corporativo pueden consumir estas señales agregadas en lugar de calcularlas por su cuenta. Eso reduce el trabajo de modelado propio y homogeniza la lectura de datos entre aplicaciones distintas, algo que hasta ahora era una fuente constante de fragmentacion.

    El limite tecnico es claro: la nueva edad de salud en Apple Health depende de que el usuario tenga un iPhone compatible con los sensores adecuados y, en muchos casos, un Apple Watch. Eso condiciona la cobertura de cualquier producto construido encima. Ademas, se trata de indicadores orientados a bienestar, no de diagnostico clinico validado, por lo que las empresas de salud deben tratar la cifra como una señal de contexto y no como un dato medico regulado. La gestion de consentimiento y privacidad, con el marco de permisos de HealthKit y el RGPD encima, sigue siendo responsabilidad de quien desarrolla la app, no de Apple.

    La leccion real para empresas del sector salud

    Aqui la enseñanza para una PYME de salud o bienestar es concreta y no forzada: antes de invertir en construir tus propios modelos de scoring biometrico, evalua si te compensa apoyarte en las metricas ya normalizadas de la plataforma. Si tu app de fisioterapia, nutricion o seguros de salud atiende a usuarios mayoritariamente en iPhone, integrar la edad de salud via HealthKit puede ahorrar meses de desarrollo. Que evitar: presentar la cifra como un veredicto medico, porque no lo es, y descuidar el consentimiento explicito del usuario para leer datos sanitarios. El ROI aparece cuando la metrica mejora la retencion o la personalizacion del servicio, no por tenerla de adorno. Y ojo con la dependencia de plataforma: atar tu producto a un unico ecosistema deja fuera a todo tu publico Android, asi que conviene diseñar una capa propia que abstraiga la fuente de datos.

    Analisis Blixel

    Reducir la salud de una persona a un unico numero es tan util como peligroso. Util porque una cifra se entiende sin formacion medica y engancha; peligroso porque invita a interpretaciones que ni Apple ni un desarrollador serio deberian avalar. La edad de salud es un resumen motivacional, no un diagnostico, y esa distincion se difumina en cuanto el marketing entra en juego. Para las empresas que se planteen construir encima, el atractivo es evidente: metricas listas, ecosistema masivo y usuarios ya acostumbrados a compartir sus datos con el reloj. Pero apoyarse en la plataforma tiene contrapartida. Cada vez que se delega el calculo de una señal clave a un tercero, se cede tambien el control sobre como se define, como cambia entre versiones y a quien deja fuera. Y deja fuera a mucha gente: sin iPhone reciente y sin sensores, no hay cifra. Nuestra recomendacion es pragmatica. Usar estas metricas como complemento, nunca como columna vertebral del producto, y mantener una arquitectura que permita cambiar de fuente sin reescribir medio sistema. Quien trabaje con datos sanitarios ademas debe blindar el consentimiento y la privacidad desde el diseño, no como parche posterior. La oportunidad real no esta en mostrar la edad de salud, sino en convertirla en acciones concretas para el usuario. Lo demas es un numero bonito que caduca a la semana.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Heurist crea una plataforma de inversion con IA en Bedrock

    Heurist crea una plataforma de inversion con IA en Bedrock

    La plataforma de inversion con IA que ha construido Heurist Finance sobre Amazon Bedrock AgentCore aborda un problema concreto: dar a inversores minoristas acceso a analisis de nivel institucional sin cargar con los contratos millonarios de datos que eso normalmente exige. El sistema reune analisis de mercado, lectura de documentos financieros, construccion de carteras y monitoreo de posiciones dentro de una unica interfaz de chat. La pieza clave es economica, no tecnica: AgentCore payments permite comprar datos premium por consulta, en lugar de firmar licencias empresariales caras antes de tener usuarios.

    Que ha hecho Heurist y por que importa

    Heurist Finance ha integrado varios flujos de trabajo que hasta ahora vivian en herramientas separadas dentro de una sola conversacion. Un inversor puede pedir un analisis de mercado, cargar un documento financiero para que el sistema lo lea y resuma, plantear una construccion de cartera y revisar sus posiciones abiertas sin salir del chat. Todo ello se apoya en Amazon Bedrock AgentCore como capa de orquestacion de agentes.

    El elemento diferencial de esta plataforma de inversion con IA es como paga los datos. En lugar de contratar un feed premium con un compromiso anual, el sistema usa AgentCore payments para comprar informacion premium en el momento de la consulta. Esto rompe el circulo vicioso habitual de las fintech jovenes: necesitas datos caros para atraer usuarios, pero no puedes justificar el gasto sin usuarios. El pago por consulta convierte un coste fijo enorme en un coste variable ligado al uso real.

    El contexto ayuda a entender el movimiento. AgentCore es la propuesta de AWS para desplegar y operar agentes de IA en produccion, con componentes de identidad, memoria y ahora pagos. Que una fintech lo use para monetizar datos por consulta muestra un patron emergente: agentes que no solo razonan, sino que ejecutan transacciones economicas acotadas de forma autonoma.

    Implicaciones tecnicas del pago por consulta

    Lo interesante de esta plataforma de inversion con IA no es el chat, que hoy es casi commodity, sino el modelo de acceso a datos. AgentCore payments introduce la idea de un agente que consume recursos de pago sobre la marcha, lo que obliga a repensar el control de costes. Cada consulta tiene un precio, asi que la arquitectura necesita limites, presupuestos por usuario y trazabilidad de que datos se compraron y por que. Sin esos controles, un patron de uso intensivo puede disparar el gasto.

    La combinacion de lectura de documentos financieros, analisis y gestion de cartera dentro de una capa de agentes tambien plantea retos de fiabilidad. Un sistema que resume un informe o propone una cartera debe dejar rastro de sus fuentes, porque en finanzas una alucinacion no es una anecdota: es una decision de inversion mal informada. La eleccion de una plataforma gestionada como AgentCore descarga a Heurist de operar la infraestructura de agentes, memoria e identidad, y le permite concentrarse en la logica financiera y en la calidad de los datos que compra por consulta.

    Para el ecosistema de desarrollo, este caso es una senal clara de hacia donde va Bedrock: de generar texto a orquestar agentes que actuan, pagan y rinden cuentas.

    Como pueden aplicar esto las empresas hoy

    La leccion practica de esta plataforma de inversion con IA es el modelo de coste variable para datos y APIs caros. Si tu empresa depende de fuentes premium (datos de mercado, informes sectoriales, enriquecimiento de datos) y aun no tienes volumen que justifique un contrato anual, evalua un esquema de pago por consulta antes de comprometerte. Permite validar demanda real sin quemar caja en licencias infrautilizadas.

    Antes de replicar el enfoque, mide tres cosas. Primero, el coste medio por consulta y su varianza: un pico de uso sin topes puede convertir la ventaja en un problema. Segundo, la trazabilidad: en cualquier flujo con documentos o decisiones sensibles, exige que el agente cite de donde saca cada dato. Tercero, el ROI honesto: AgentCore reduce el trabajo de infraestructura, pero no elimina el de disenar limites, gobernar costes y verificar salidas. Lo que conviene evitar es lanzar un agente con pago autonomo sin presupuestos por usuario ni alertas de gasto. La autonomia economica de un agente es util solo si esta acotada.

    Analisis Blixel

    El detalle que merece atencion aqui no es que otra fintech haya puesto un chat sobre datos de mercado, sino que un agente compre informacion pagando por consulta. Ese cambio, aparentemente pequeno, altera la economia de montar un producto de datos: el foso de entrada deja de ser el capital para firmar contratos y pasa a ser la calidad del producto. Es una democratizacion real, no retorica.

    Dicho esto, conviene bajar las expectativas al suelo. Reunir analisis, lectura de documentos y gestion de cartera en una interfaz conversacional suena limpio en una demo, pero en produccion el diablo esta en la verificacion. En finanzas, un resumen incorrecto de un informe o una asignacion mal razonada tienen consecuencias medibles, y ningun modelo esta libre de equivocarse. La pregunta no es si el sistema responde, sino si puede justificar cada respuesta con su fuente.

    El movimiento de AWS con pagos en su capa de agentes es el subtexto mas relevante. Marca la transicion de agentes que hablan a agentes que gastan dinero de forma autonoma, y eso abre un frente de gobierno del gasto que muchas empresas aun no tienen resuelto. Para una PYME, la oportunidad es concreta: convertir costes fijos de datos en variables. Pero solo funciona con limites, alertas y trazabilidad desde el primer dia. La tecnologia habilita el modelo; la disciplina operativa decide si sale rentable o se convierte en una factura sorpresa.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • AWS une TorchServe y Ray Serve para desplegar modelos

    AWS une TorchServe y Ray Serve para desplegar modelos

    El despliegue de modelos PyTorch en produccion acaba de ganar una opcion menos artesanal. AWS ha publicado una integracion entre TorchServe y Ray Serve empaquetada en contenedores especializados para deep learning, disponibles en Amazon ECR y compatibles tanto con CPU como con GPU. La promesa es concreta: reducir la carga operativa de servir modelos a escala, con escalado automatico y reparto de trabajo gestionado por el propio runtime. Para equipos que hoy montan su stack de inferencia a mano, es un atajo que merece una evaluacion seria antes de descartarlo o adoptarlo a ciegas.

    Que ha lanzado AWS y por que importa

    AWS ha combinado dos piezas que hasta ahora vivian en repositorios y flujos separados. TorchServe es el servidor de modelos oficial del ecosistema PyTorch, pensado para exponer modelos entrenados via API. Ray Serve, por su parte, es la capa de serving del framework Ray, orientada a orquestar y escalar cargas de inferencia distribuidas. La novedad es que ambos llegan preintegrados en contenedores Deep Learning Containers, listos para tirar desde Amazon ECR sin ensamblar dependencias a mano.

    El detalle relevante es la doble compatibilidad con CPU y GPU, lo que cubre desde inferencia ligera hasta modelos que exigen aceleracion. En el despliegue de modelos PyTorch, buena parte del coste real no esta en entrenar sino en mantener el servicio vivo, escalado y actualizado. Al empaquetar TorchServe con la logica de escalado de Ray Serve, AWS ataca justo esa fase. Historicamente, integrar ambos suponia resolver versiones, drivers de GPU y configuracion de red por cuenta propia, un trabajo repetitivo que consume horas de ingenieria y genera fragilidad en cada actualizacion del stack.

    Implicaciones tecnicas del nuevo stack de inferencia

    La combinacion tiene sentido arquitectonico. Ray Serve aporta escalado automatico y distribucion de peticiones entre replicas, mientras TorchServe se encarga del ciclo de vida del modelo dentro de cada worker: carga, versionado y ejecucion. Al desacoplar orquestacion de serving, el despliegue de modelos PyTorch deja de depender de scripts caseros para gestionar picos de carga o repartir peticiones entre nodos con y sin GPU.

    El uso de contenedores preconstruidos tiene un efecto practico inmediato: reproducibilidad. Un contenedor validado por AWS reduce el clasico «en mi maquina funciona» y acorta el camino de un modelo en desarrollo a un endpoint en produccion. Para equipos de MLOps, esto significa menos tiempo peleando con compatibilidades de CUDA y mas tiempo en lo que aporta valor. Conviene, eso si, no confundir facilidad de arranque con ausencia de decisiones: el dimensionado de replicas, la eleccion entre CPU y GPU segun latencia objetivo y el coste por peticion siguen siendo responsabilidad del equipo. La integracion elimina fontaneria, no la necesidad de entender la carga real de inferencia que se quiere servir.

    Como pueden aplicar esto las empresas hoy

    Si tu empresa ya sirve modelos PyTorch sobre infraestructura propia, el primer paso es un piloto controlado: coge un modelo representativo, despliegalo con el contenedor desde Amazon ECR y compara latencia, coste por inferencia y esfuerzo operativo frente a tu setup actual. El despliegue de modelos PyTorch con estos contenedores tiene mas sentido cuando ya sufres picos de trafico o gestionas varios modelos que compiten por recursos. Para un unico modelo con trafico estable y bajo, la complejidad de Ray Serve puede ser excesiva; ahi un TorchServe simple o incluso una funcion serverless resuelve igual con menos capas.

    Que evitar: adoptar el stack solo porque es nuevo. Mide antes de migrar. Revisa tambien el coste de la GPU, que suele ser el factor dominante de la factura; si tu modelo tolera CPU, empieza por ahi. Y confirma que tu equipo tiene o puede adquirir criterio sobre Ray, porque depurar un sistema distribuido exige conocimiento que no viene incluido en el contenedor. El ahorro real llega cuando reduces horas de mantenimiento, no cuando sumas una herramienta mas al inventario.

    Analisis Blixel

    Hay una tendencia clara en la industria: el valor ya no esta en entrenar modelos, sino en servirlos de forma fiable y barata. AWS lo sabe y por eso mueve ficha en la capa menos glamurosa pero mas rentable, la de operaciones. Empaquetar TorchServe con Ray Serve no es un avance tecnico rompedor, es una consolidacion sensata de piezas que ya existian y que la mayoria de equipos ensamblaba con esfuerzo y errores. Ese es precisamente su merito: convertir trabajo repetitivo en un contenedor descargable.

    El riesgo, como siempre con las comodidades de AWS, es el acoplamiento. Un stack preconstruido y disponible solo en su ECR facilita hoy y ata manana. Merece la pena aprovechar la integracion, pero manteniendo el modelo y la logica de negocio lo suficientemente portables como para no quedar atrapado si los precios cambian. Para PYMEs con equipos pequenos, la ecuacion es favorable: menos ingenieria de plataforma significa poder centrarse en el producto. Para organizaciones con infraestructura madura, la pregunta es si esto mejora lo que ya tienen o solo lo sustituye por algo gestionado por un tercero. La respuesta honesta depende de cuantas horas dediques hoy a mantener tu propio serving. Si son muchas, prueba. Si son pocas, quiza no lo necesites todavia. La herramienta es buena; la decision de adoptarla debe seguir siendo tuya y basarse en numeros, no en la novedad.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Shipt suma un asistente de compras con IA a su app

    Shipt suma un asistente de compras con IA a su app

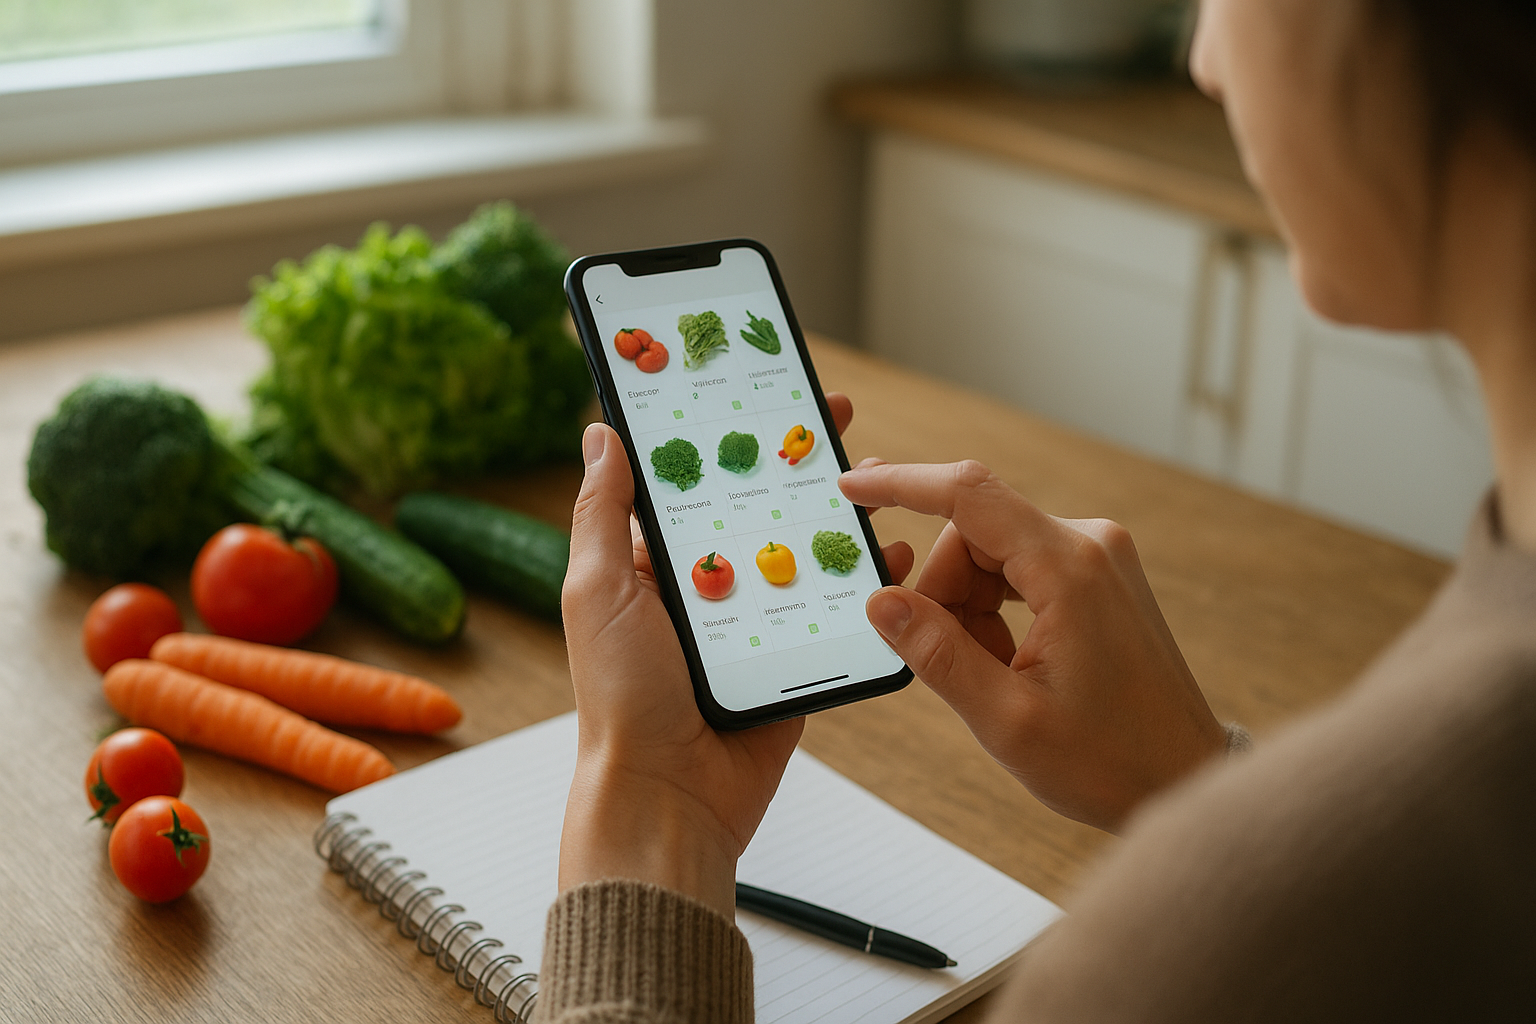
    El asistente de compras con IA que acaba de estrenar Shipt no reinventa nada, pero confirma una direccion clara: las apps de reparto a domicilio quieren dejar de ser catalogos con carrito para convertirse en algo que orienta la compra. Shipt ha integrado esta funcion en su aplicacion de entrega, sumandose a otras companias de delivery que ya habian dado el paso. El objetivo declarado es mejorar la personalizacion de recomendaciones y afinar la experiencia de compra online, dos frentes donde el sector retail se juega buena parte de la conversion.

    Que ha pasado y por que importa

    Shipt ha incorporado un asistente de compras con IA a su aplicacion de entrega a domicilio. La compania se posiciona asi como la ultima empresa del sector delivery en adoptar este tipo de herramienta, despues de que otras companias del mismo mercado hayan implementado asistentes similares. La funcion se orienta a que las empresas del retail puedan mejorar la personalizacion de las recomendaciones y optimizar la experiencia de compra online, factores que la propia compania senala como clave para competir en e-commerce.

    El movimiento se enmarca en una tendencia mas amplia dentro del reparto a domicilio, donde la diferenciacion ya no se juega solo en tiempos de entrega o cobertura, sino en como se acompana al usuario durante la seleccion de productos. Un asistente conversacional que sugiere articulos, responde dudas o completa cestas apunta directamente a reducir la friccion del carrito. En un mercado con margenes ajustados y alta rotacion de usuarios, cualquier mejora sostenida en conversion o ticket medio tiene efecto en la cuenta de resultados, y ese es el terreno donde se libran estas apuestas.

    Implicaciones tecnicas y de producto

    Un asistente de compras con IA dentro de una app de delivery no es un chatbot decorativo: para aportar valor real necesita conectarse al catalogo en tiempo real, al historial de pedidos del usuario y a senales de disponibilidad de stock. La personalizacion de recomendaciones util depende menos del modelo de lenguaje y mas de la calidad de esos datos: si el inventario no esta bien estructurado o las categorias son inconsistentes, el asistente sugiere productos agotados o irrelevantes y erosiona la confianza.

    Ahi esta el matiz que suele quedar fuera del anuncio. La parte visible es la conversacion; la parte dificil es la integracion con los sistemas de catalogo, precios y logistica. Para el retail que observa este tipo de lanzamientos, la leccion tecnica es que un asistente de compra vive o muere segun la infraestructura de datos que tenga debajo. Sin un catalogo limpio, atributos de producto consistentes y sincronizacion de stock, la capa de IA amplifica los errores en lugar de corregirlos. Por eso los proyectos que funcionan empiezan por ordenar los datos antes de anadir la interfaz conversacional.

    Que puede aprender una PYME de retail de este movimiento

    La leccion accionable para una PYME de comercio no es copiar a Shipt, sino invertir el orden habitual. Antes de plantear un asistente de compras con IA, conviene auditar el catalogo: fichas de producto con atributos completos, categorias coherentes y stock sincronizado. Ese trabajo, poco vistoso, es el que determina si una capa de IA sera util o contraproducente. Una tienda pequena puede empezar por mejorar el buscador interno y las recomendaciones basicas basadas en historial antes de saltar a lo conversacional, porque gran parte de la ganancia en experiencia de compra online se obtiene ahi con menos coste y menos riesgo. El segundo aprendizaje es medir: definir de antemano si el objetivo es subir la conversion, el ticket medio o reducir devoluciones, y descartar la funcion si no mueve esas cifras. Un asistente que responde bien pero no cambia el negocio es un gasto, no una mejora. Lo genuino aqui es la secuencia, no la tecnologia.

    Analisis Blixel

    Cuando toda una categoria de apps adopta la misma funcion en pocos meses, conviene preguntarse cuanto responde a una necesidad real del usuario y cuanto a la presion competitiva de no quedarse fuera. El caso del reparto a domicilio tiene las dos cosas, y distinguirlas importa. Un comprador que pide comida o productos de supermercado suele saber lo que quiere; el margen de mejora de un asistente esta en cestas grandes, listas recurrentes o descubrimiento de alternativas cuando algo falta, no en una conversacion por conversar. Si la funcion se limita a un chat vistoso encima del mismo catalogo, el usuario la ignorara tras la novedad inicial. La utilidad real llega cuando el asistente conoce el historial, anticipa la recompra y resuelve la falta de stock proponiendo sustitutos sensatos. Ese valor no lo da el modelo, lo da la integracion. Para una empresa que evalua algo parecido, el error frecuente es comprar la capa visible y descubrir despues que los datos no la sostienen. La recomendacion es sobria: tratar estos asistentes como una mejora incremental de la experiencia de compra, medible y reversible, no como un salto estrategico. Adoptarlos por miedo a parecer atrasados es la peor razon posible. Adoptarlos porque los datos ya estan ordenados y hay una metrica clara que mover es la unica que justifica el esfuerzo.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • Instacart lanza Clementine, su asistente de compras con IA

    Instacart lanza Clementine, su asistente de compras con IA

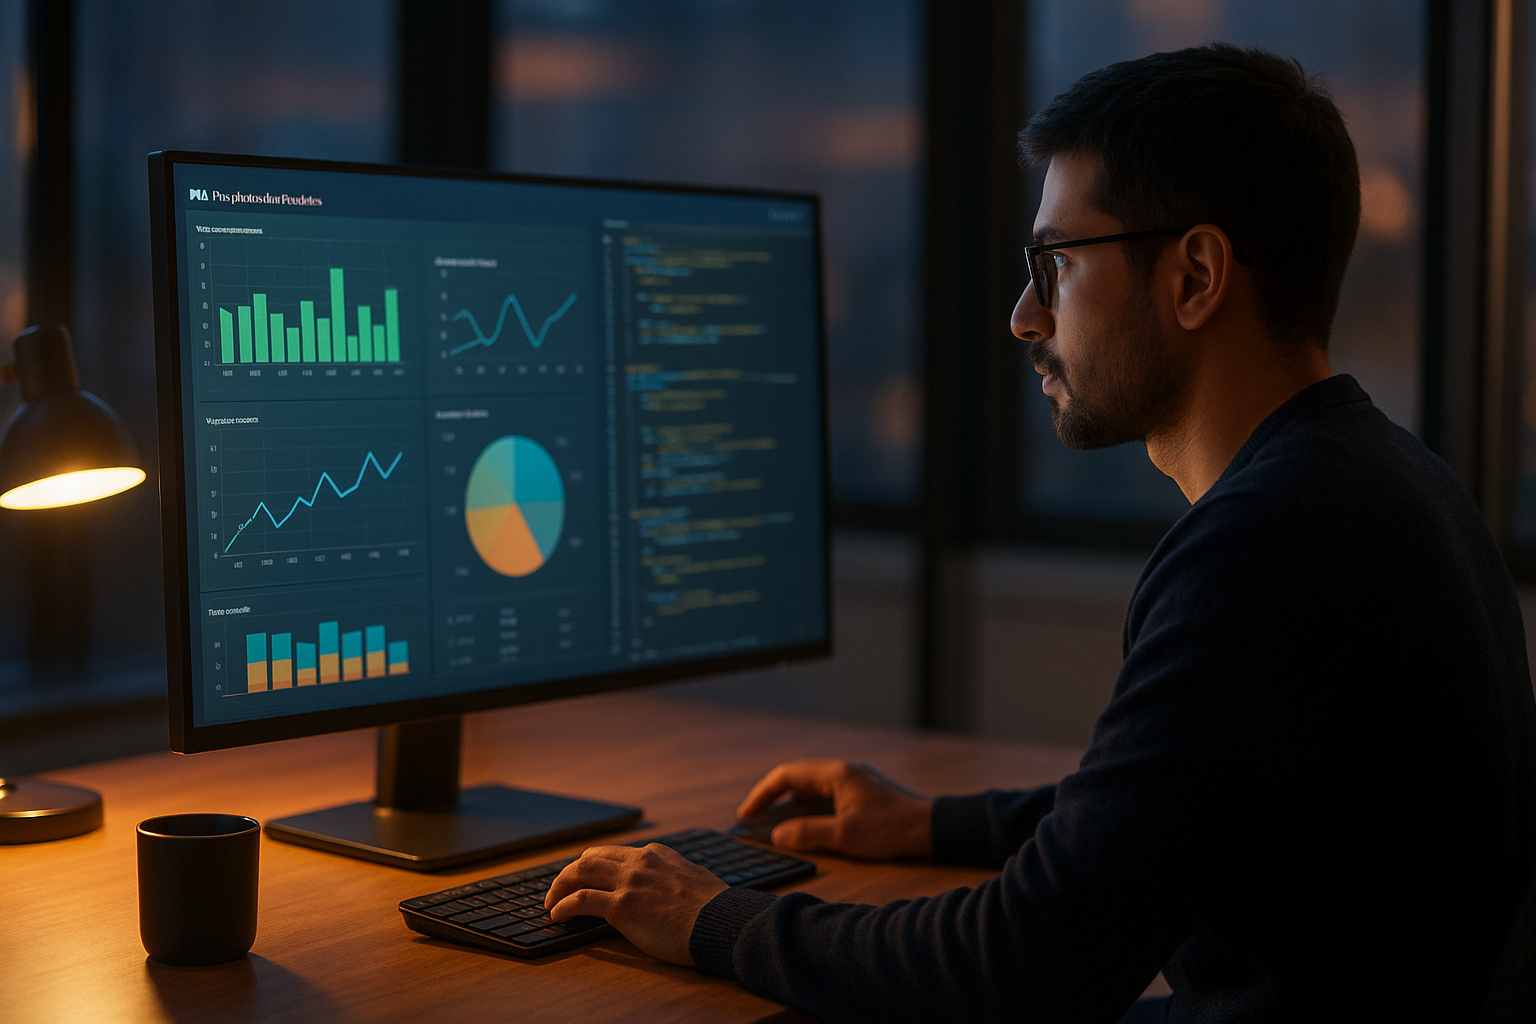
    El asistente de compras con IA de Instacart, bautizado como Clementine, ha llegado para meterse en el carrito de la compra online de supermercado. La compania lo presenta como una herramienta que ofrece recomendaciones personalizadas y asistencia automatizada para que el usuario tarde menos en decidir que comprar. Detras del nombre amable hay una apuesta clara: convertir la busqueda de productos de alimentacion en una conversacion guiada. Para el sector retail, la pregunta no es si la IA entra en el ecommerce de comida, sino con que resultados medibles lo hace y a quien beneficia realmente.

    Que ha pasado y por que importa

    Instacart ha presentado Clementine, un asistente de inteligencia artificial integrado en su plataforma de comercio electronico de alimentacion. Su funcion principal es acompanar al comprador durante la sesion: sugerir productos, resolver dudas y afinar recomendaciones segun el contexto de cada usuario. La compania enmarca el lanzamiento dentro de su estrategia de incorporar capacidades de IA a lo largo de toda la experiencia de compra online.

    El argumento comercial es directo. Un asistente de compras con IA bien planteado puede reducir el tiempo de decision del consumidor y, por extension, aumentar las ventas al facilitar que el carrito se llene con menos friccion. En un sector con margenes ajustados y cestas muy grandes en numero de referencias, cada segundo que un usuario ahorra buscando tiene valor.

    Instacart no es nueva en el terreno de la recomendacion: su modelo de negocio siempre ha vivido de conectar catalogos enormes con compradores que no quieren perderse en pasillos digitales. Clementine representa un paso mas hacia una interfaz conversacional que sustituye parte de la busqueda tradicional por texto por una guia mas parecida a preguntar a un dependiente. El movimiento llega en un momento en que buena parte del retail experimenta con asistentes similares.

    Implicaciones tecnicas y de mercado

    Un asistente de compras con IA como Clementine se apoya en varias piezas que conviene entender antes de idealizarlo. Por un lado, necesita un catalogo bien estructurado y datos limpios de producto: sin metadatos coherentes, las recomendaciones se degradan rapido. Por otro, requiere senales de contexto (historial, preferencias, restricciones dieteticas) para que la personalizacion sea util y no ruido. La calidad del resultado depende tanto del modelo como del dato que lo alimenta.

    El riesgo tipico de estos sistemas es la recomendacion sesgada hacia lo que mas conviene vender, no hacia lo que el usuario necesita. Si el asistente empuja siempre marcas patrocinadas, la confianza se erosiona y el efecto sobre las ventas a largo plazo puede ser negativo. La transparencia sobre por que se sugiere cada producto sera un factor competitivo.

    En terminos de mercado, Instacart usa Clementine tanto de cara al consumidor como argumento para los retailers que operan sobre su plataforma. Es decir, no solo mejora su propia app: ofrece a las cadenas de supermercado una capa de IA que, en teoria, eleva conversion sin que cada una tenga que construirla desde cero. Ese enfoque de IA como servicio para el retail de alimentacion es donde se libra la batalla real.

    Como pueden aplicar esto las empresas hoy

    Para una PYME del sector alimentacion o retail, la leccion de Clementine no es copiar el producto, sino entender sus condiciones previas. Antes de plantear cualquier asistente de compras con IA, lo prioritario es tener el catalogo digitalizado con atributos coherentes: categoria, alergenos, formato, precio por unidad. Sin esa base, ningun modelo genera recomendaciones fiables. Ese trabajo de datos es barato de empezar y rinde aunque nunca se despliegue un asistente conversacional.

    El segundo paso realista es medir antes de automatizar. Conviene identificar donde abandona el usuario el carrito y si el problema es de busqueda, de informacion de producto o de precio. Un asistente resuelve el primero, no los otros dos. Para evaluar el ROI, compara el coste de integrar una capa de IA (propia o de un proveedor como Instacart) frente al aumento real de conversion en una prueba controlada, no frente a promesas de venta. Lo que hay que evitar es lanzar un chatbot generico que empuje productos patrocinados y llamarlo personalizacion: el cliente lo detecta y penaliza la confianza. Empieza pequeno, con una categoria concreta, y escala solo con datos que lo justifiquen.

    Analisis Blixel

    La friccion en la compra de alimentacion online rara vez esta donde las empresas creen. No falla porque el usuario no encuentre un asistente amable, sino porque el catalogo esta mal descrito, las fotos son malas o el precio por unidad no queda claro. Poner una capa conversacional sobre esos problemas es maquillaje sofisticado. Clementine funcionara en la medida en que Instacart tenga los datos ordenados por debajo, y ahi es donde la mayoria de retailers todavia cojea.

    Hay un segundo punto que merece vigilancia: el conflicto de interes. Un asistente que recomienda comida y a la vez vende espacio publicitario a marcas tiene un incentivo estructural para sugerir lo mas rentable, no lo mejor para el comprador. Si esa linea se cruza demasiado, el asistente deja de ser una ayuda y se convierte en un vendedor disfrazado. La sostenibilidad de estas herramientas depende de que la recomendacion siga siendo honesta cuando nadie mira.

    Para las PYMEs espanolas la lectura es tranquilizadora en un sentido: no necesitan un Clementine propio para competir. Necesitan datos de producto limpios, una web rapida y un proceso de pago sin sobresaltos. Eso ya mejora la conversion mas que cualquier asistente vistoso montado sobre cimientos flojos. La IA en el carrito es interesante, pero llega despues de los deberes basicos, no antes.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • SageMaker Feature Store estrena la API UpdateRecord

    SageMaker Feature Store estrena la API UpdateRecord

    La API UpdateRecord de SageMaker Feature Store ya está disponible y resuelve una molestia concreta para cualquier equipo que mantiene features en producción: hasta ahora, cambiar un solo valor obligaba a leer el registro completo, modificarlo en memoria y volver a escribirlo entero. Amazon acaba de romper ese ciclo. Con UpdateRecord se actualizan uno o varios valores de un registro en una única llamada, sin tocar el resto. El resultado es menos latencia y menos consumo de capacidad de lectura en los pipelines de machine learning que dependen de features actualizadas constantemente.

    Qué ha cambiado y por qué importa

    Hasta este lanzamiento, la única forma de modificar un registro en SageMaker Feature Store era PutRecord, una operación que sobrescribe el registro completo. Si querías cambiar un único atributo (por ejemplo, el saldo de una cuenta o el último producto visto por un usuario), tenías que ejecutar un ciclo read-modify-write: leer el registro entero, aplicar el cambio en tu código y volver a escribirlo. Ese patrón consume capacidad de lectura innecesaria y añade latencia en cada actualización.

    La nueva API UpdateRecord permite escrituras a nivel de feature. Envías solo los valores que cambian y el servicio los actualiza sin necesidad de leer previamente el registro ni reescribir los campos que no se tocan. Está disponible tanto en el tier Standard, respaldado por DynamoDB, como en el tier In-Memory, respaldado por ElastiCache. Es decir, cubre tanto casos de features con latencias de milisegundos como escenarios de acceso ultrarrápido en memoria, sin cambiar de herramienta.

    Implicaciones técnicas para tus pipelines

    El impacto real de la API UpdateRecord de SageMaker Feature Store se nota en las cargas de escritura frecuente. En sistemas de recomendación, detección de fraude o scoring en tiempo real, un mismo registro de feature puede actualizarse cientos de veces por minuto. Eliminar la lectura previa de cada ciclo reduce directamente el número de operaciones facturables y baja la latencia percibida por la aplicación que consume esas features online.

    Hay un segundo efecto menos evidente pero igual de relevante: la simplificación del código. El patrón read-modify-write obliga a gestionar la coherencia manualmente y abre la puerta a condiciones de carrera cuando varios procesos escriben sobre el mismo registro casi a la vez. Con actualizaciones a nivel de feature, el margen de error se reduce porque cada escritura afecta solo a los campos que envías. Para equipos de MLOps, esto significa menos lógica defensiva en el ingest de datos y menos incidentes difíciles de reproducir. La disponibilidad simultánea en Standard e In-Memory evita además tener que rediseñar el flujo según el tier de rendimiento que uses en cada caso.

    Cómo pueden aplicar esto las empresas hoy

    Si ya usas SageMaker Feature Store con PutRecord para actualizaciones parciales, el cambio más directo es revisar dónde estás pagando lecturas que ya no necesitas. Identifica las features que se actualizan con frecuencia y aisladamente (contadores, timestamps, estados) y migra esas escrituras a UpdateRecord. El ahorro de capacidad de lectura es medible y suele concentrarse en unos pocos flujos de alta frecuencia, así que no necesitas reescribir todo el pipeline de golpe.

    Antes de migrar, mide la línea base: latencia por operación y consumo de capacidad de lectura del online store durante una semana típica. Así podrás cuantificar el ROI real en lugar de asumirlo. Lo que conviene evitar es forzar UpdateRecord en flujos donde de todas formas reescribes casi todo el registro: ahí PutRecord sigue siendo lo natural. La API UpdateRecord brilla cuando las escrituras son parciales y repetitivas, no como sustituto universal de PutRecord. Si aún no usas Feature Store, este lanzamiento reduce una de las fricciones históricas de mantener features online actualizadas a bajo coste.

    Analisis Blixel

    Puede parecer una función menor, casi de nota al pie en un changelog. Y sin embargo, este tipo de mejoras son las que de verdad importan cuando llevas un modelo a producción y empiezas a pagar la factura mes a mes. El ciclo read-modify-write era un impuesto silencioso: cada actualización parcial arrastraba una lectura completa que nadie contabilizaba hasta que el volumen crecía. Amazon no está vendiendo aquí una capacidad nueva y espectacular, está eliminando una ineficiencia estructural que penalizaba a los equipos con cargas de escritura intensas.

    Para las PYMEs que operan con presupuestos ajustados de infraestructura, este es el tipo de detalle que marca la diferencia entre un pipeline sostenible y uno que se dispara en coste sin explicación clara. La lección de fondo es que la madurez de una plataforma de MLOps no se mide por las funciones grandes que anuncia, sino por cuántas fricciones operativas va limando con el tiempo. La escritura a nivel de feature entra en esa categoría. No cambiará tu arquitectura, pero sí puede recortar la factura y simplificar el código de ingest de quien la aplique con criterio. El consejo práctico: no la adoptes por moda, adóptala donde tengas medido que las lecturas evitadas compensan. Y desconfía de cualquier migración que no puedas justificar con un antes y un después en números.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.