
Categoría: Hardware y Cómputo

  • El teclado de OpenAI para agentes Codex cuesta 230 $

    El teclado de OpenAI para agentes Codex cuesta 230 $

    El teclado Codex Micro de OpenAI es un dispositivo fisico de 230 dolares pensado para gestionar agentes de programacion autonomos sin pasar por una app movil o de escritorio. Sus teclas iluminadas muestran el estado de cada agente y ofrecen controles personalizables para las acciones mas frecuentes de Codex. El lanzamiento llega en un momento raro: mientras OpenAI empuja hacia el hardware, Apple la demanda por supuesto robo de secretos comerciales. Dos frentes que conviene mirar juntos, porque explican adonde quiere ir la compania mas alla del chatbot.

    Que ha pasado y por que importa

    OpenAI ha presentado el Codex Micro, un teclado de 230 dolares disenado especificamente para controlar los agentes de IA de programacion de la plataforma Codex. La propuesta es concreta: cada tecla iluminada refleja el estado de un agente en curso y permite disparar acciones frecuentes con un boton fisico. En lugar de saltar entre una app movil y el escritorio para supervisar bots que escriben y ejecutan codigo por su cuenta, el desarrollador tiene un centro de comando tangible sobre la mesa.

    El teclado Codex Micro parte de una idea que ya venia madurando en el flujo de trabajo de muchos equipos: los agentes de programacion autonomos generan tareas que corren en segundo plano y necesitan supervision constante. Hasta ahora esa supervision vivia en pantallas compartidas con el resto del trabajo. Convertirla en un dispositivo dedicado, con feedback luminoso, es un movimiento hacia la interfaz fisica en un terreno donde casi todo era software. El precio, 230 dolares, lo situa como accesorio profesional, no como gadget de impulso.

    Implicaciones tecnicas y el frente legal con Apple

    El teclado Codex Micro no llega solo. En paralelo, Bloomberg reveló que OpenAI trabaja en un altavoz inteligente portatil sin pantalla, con elementos mecanicos moviles y disenado por ex-ingenieros de Apple. Ese detalle es el que ha encendido el conflicto: Apple demanda a OpenAI por supuesto robo de secretos comerciales, en lo que apunta a una disputa por talento y conocimiento tecnico fugado desde Cupertino.

    Tecnicamente, el Codex Micro reconoce algo que los equipos ya sabian: gestionar varios agentes de programacion a la vez es un problema de atencion, no solo de computo. Un panel fisico con estados visibles reduce el coste mental de vigilar procesos autonomos. Es la misma logica que llevo a los stream decks y teclados macro al setup de developers, ahora aplicada a agentes de IA. El movimiento hacia hardware propio, sumado al altavoz sin pantalla, sugiere que OpenAI no quiere depender de las plataformas de terceros para llegar al usuario. Y ahi es donde choca con Apple, que controla el hardware de consumo mas relevante y no ve con buenos ojos que ex-empleados alimenten a un rival directo.

    Como pueden aplicar esto las empresas hoy

    Antes de comprar el teclado Codex Micro para tu equipo, la pregunta real es otra: usas ya agentes de programacion en produccion o solo experimentas con ellos. Si es lo segundo, un dispositivo de 230 dolares por puesto no aporta ROI; el cuello de botella esta en el flujo, no en la interfaz. Para equipos que ya orquestan varios agentes en paralelo y pierden tiempo saltando entre ventanas para supervisarlos, un panel de control fisico puede recortar la fatiga de monitorizacion y los errores por descuido.

    Que evitar: comprar hardware para justificar una adopcion de agentes que aun no existe. Primero mide cuantas tareas autonomas corren a la vez y cuanto tiempo dedica el equipo a vigilarlas. Si esa cifra es baja, cualquier atajo de teclado configurable resuelve lo mismo gratis. El Codex Micro solo tiene sentido cuando la supervision de agentes de programacion es una actividad recurrente y costosa en tu dia a dia, no una promesa de futuro.

    Analisis Blixel

    Vender un teclado de 230 dolares para vigilar bots dice mas sobre la estrategia de OpenAI que sobre el propio accesorio. La compania esta tanteando el hardware desde dos angulos a la vez: un dispositivo de nicho para developers y un altavoz de consumo firmado por gente que salio de Apple. No es casualidad que ambos aparezcan cerca de una demanda por secretos comerciales. Cuando una empresa de software puro empieza a fabricar objetos, esta buscando controlar el punto de contacto con el usuario y dejar de alquilarselo a otros.

    El teclado en si es honesto en su planteamiento: reconoce que gestionar agentes de programacion autonomos es agotador y que el software solo no lo resuelve. Eso es un dato util para cualquiera que este montando pipelines con IA. Pero tambien es un producto de segmento estrecho; la mayoria de equipos no tiene tantos agentes corriendo como para necesitar un panel dedicado. El movimiento interesante no es el gadget, es la senal. OpenAI quiere hardware, quiere talento de Apple y esta dispuesta a litigar por el camino. Para las empresas que dependen de su plataforma, conviene leer esto como lo que es: una compania ampliando frentes deprisa. Eso trae mas capacidades, pero tambien mas dependencia de un unico proveedor que ya no se limita al modelo, sino que quiere la mesa entera.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Nueva York frena todos los nuevos centros de datos

    Nueva York frena todos los nuevos centros de datos

    La moratoria de centros de datos en Nueva York convierte al estado en el primero de EE. UU. en frenar la aprobacion de nuevos permisos para instalaciones de 50 megavatios o mas. La gobernadora Kathy Hochul firmo una orden ejecutiva que suspende temporalmente estos proyectos mientras se completa una revision ambiental que se prolongara aproximadamente un ano. La medida llega en pleno auge de construccion vinculado a la IA y expone una tension creciente entre la demanda de computo y la capacidad real de la red electrica para sostenerla sin trasladar el coste a los residentes.

    Que ha pasado y por que importa

    La orden ejecutiva prohibe de forma temporal que Nueva York apruebe permisos para centros de datos con una demanda de 50 megavatios o superior. Es un umbral que apunta directamente a las grandes instalaciones asociadas al entrenamiento y despliegue de modelos de IA, no a los pequenos racks corporativos. Segun lo comunicado, la moratoria se mantendra durante alrededor de un ano, el tiempo estimado para completar una revision ambiental que evalue el impacto sobre la red electrica y los recursos locales. La medida podria afectar a mas de una docena de proyectos que ya estaban en desarrollo.

    El contexto ayuda a entender la decision. El consumo energetico de los centros de datos ha crecido con rapidez por la demanda de computo para IA, y las administraciones locales empiezan a cuestionar quien paga la factura de ampliar la red. A esa presion se suma un factor social: la moratoria de centros de datos en Nueva York coincide con un escepticismo publico notable, donde solo el 10% de los estadounidenses se declaran mas entusiasmados que preocupados por el uso diario de la IA. Nueva York es el primer estado en formalizar una pausa de este tipo.

    Implicaciones tecnicas y de mercado

    Para el sector de infraestructura, la senal es clara: la energia, y no el silicio, se esta convirtiendo en el cuello de botella real de la expansion de la IA. Un centro de datos de 50 MW no se limita por la disponibilidad de GPU, sino por la capacidad de la red para suministrar energia estable sin encarecer el recibo del resto de consumidores. La moratoria de centros de datos en Nueva York obliga a operadores e hiperescalares a incorporar el riesgo regulatorio y energetico como variable de primer orden en la eleccion de emplazamientos.

    El efecto inmediato es de redistribucion geografica. Los proyectos congelados no desaparecen: buscan estados con permisos mas agiles y con excedente de generacion. Eso beneficia a mercados con energia barata y regulacion previsible, y penaliza a las zonas densamente pobladas donde la red ya esta tensionada. Tambien acelera el interes por acuerdos de generacion propia, contratos de energia renovable a largo plazo y ubicaciones con acceso a fuentes estables. Para los proveedores de refrigeracion, transformadores y equipamiento electrico, un ano de revision introduce incertidumbre en la planificacion de pedidos, pero no altera la tendencia de fondo: la demanda de computo sigue subiendo.

    Que significa este movimiento para el mercado

    Para los hiperescalares y operadores de colocation, la leccion es que la licencia social y la disponibilidad energetica pesan tanto como el capital. Quien tenga proyectos en estados con redes saturadas debe asumir que otras administraciones podrian seguir el ejemplo de Nueva York, y planificar rutas alternativas de despliegue. Para los proveedores de energia, se abre una oportunidad clara: los contratos de suministro dedicado y la generacion cercana al centro de datos ganan valor. Para las empresas que dependen de capacidad cloud, el riesgo es indirecto pero real: si la construccion se ralentiza en ciertas regiones, la latencia y el coste de determinados servicios podrian variar segun donde acaben ubicandose los nuevos centros. Los buyers corporativos deberian preguntar a sus proveedores cloud por la ubicacion y la sostenibilidad energetica de la infraestructura que contratan, no solo por el precio por hora. El escepticismo publico hacia la IA anade una capa politica: los proyectos que no comuniquen su impacto local encontraran mas fricciones.

    Analisis Blixel

    Durante meses el relato dominante ha sido que la carrera de la IA se ganaba con GPU y capital. Esta decision recuerda que el limite fisico es mucho mas prosaico: kilovatios y refrigeracion. Un estado entero puede decir que no, y eso reescribe el mapa de donde se construye computo. No es una medida anti-IA, es una medida de gestion de recursos, y esa distincion importa. La revision ambiental de un ano no es un capricho burocratico: es el reconocimiento de que ampliar la red tiene un coste que alguien paga, y que trasladarlo silenciosamente a los residentes ya no es viable politicamente. Para las empresas espanolas la lectura es util aunque la noticia sea estadounidense. La infraestructura que contratamos vive en algun sitio real, con una red electrica y una comunidad detras. Cuando un proveedor promete capacidad ilimitada, conviene preguntar de donde sale la energia y a que coste ambiental. La sostenibilidad deja de ser un adorno de marketing para convertirse en una variable de continuidad del servicio. Preveo que otras administraciones observaran de cerca el resultado de esta pausa. Si la revision funciona sin frenar la economia digital, el modelo se copiara. Y si frena proyectos sin ordenar nada, sera munición para quienes defienden la desregulacion total. El equilibrio entre demanda de computo y capacidad energetica sera uno de los debates definitorios de los proximos anos.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Reflection sella un pacto de computo de 1.000M con Nebius

    Reflection sella un pacto de computo de 1.000M con Nebius

    El acuerdo de computacion en la nube firmado entre Reflection y Nebius, valorado en 1.000 millones de dolares, es una de las mayores transacciones registradas hasta la fecha en el sector de la infraestructura para inteligencia artificial. El pacto da a Reflection acceso a recursos de computo de alto rendimiento sin desembolsar de golpe el capital que exigiria construir sus propios centros de datos. En un momento en que la disponibilidad de GPU marca el ritmo del desarrollo de modelos, un contrato de esta escala dice tanto de Reflection como del reparto de poder en la cadena de suministro de la IA.

    Que ha pasado y por que importa

    Reflection ha cerrado un contrato con Nebius por un valor total de 1.000 millones de dolares para acceder a infraestructura de computo de alto rendimiento. El objetivo declarado es sencillo: disponer de la capacidad de calculo necesaria para entrenar y ejecutar modelos de IA sin asumir la inversion inicial en hardware propio. En lugar de comprar y gestionar sus propias flotas de aceleradores, Reflection contrata esa potencia a un proveedor especializado. Este tipo de acuerdo de computacion en la nube se ha convertido en la via habitual para las empresas que desarrollan modelos y no quieren inmovilizar cientos de millones en equipamiento que se deprecia rapido.

    La magnitud de la cifra es lo que distingue este movimiento. Contratos de mil millones de dolares en computo eran, hace pocos anos, terreno reservado a los grandes hiperescaladores. Que un proveedor como Nebius firme un compromiso de este calibre confirma que el mercado de infraestructura para IA se esta ampliando mas alla de los sospechosos habituales. La demanda de capacidad de calculo crece mas rapido que la oferta, y eso empuja a las empresas de modelos a asegurar acceso a largo plazo mediante contratos plurianuales de gran volumen.

    Implicaciones tecnicas y de mercado

    Este acuerdo de computacion en la nube refleja una tendencia estructural: la separacion entre quien desarrolla los modelos y quien posee la infraestructura fisica. Para Reflection, externalizar el computo significa convertir una inversion de capital en un gasto operativo, ganar flexibilidad para escalar segun lo pida cada fase de entrenamiento y evitar el riesgo de quedarse con hardware obsoleto. A cambio, cede parte del control sobre su cadena de suministro y ata su capacidad de crecimiento a la disponibilidad y los precios que fije su proveedor.

    Para Nebius, un compromiso de 1.000 millones de dolares aporta previsibilidad de ingresos y justifica la expansion de su capacidad instalada. Los proveedores de infraestructura viven de la utilizacion: un contrato ancla de este tamano permite financiar la compra de aceleradores y la construccion de centros de datos con la demanda ya comprometida. En un mercado donde el acceso a GPU de alto rendimiento es el cuello de botella real, quien garantiza capacidad se coloca en una posicion negociadora fuerte. El acuerdo de computacion en la nube tambien senala que las alternativas a los grandes hiperescaladores estan madurando lo suficiente como para sostener cargas de trabajo de IA a gran escala.

    Que significa este movimiento para el mercado

    Para los competidores de Nebius, este contrato es una prueba de que hay hueco fuera del oligopolio de los grandes proveedores cloud. Las empresas de modelos buscan diversificar proveedores para no depender de un unico interlocutor, y eso abre oportunidades a operadores especializados que ofrezcan capacidad garantizada a precios competitivos. Para los desarrolladores de IA que no manejan presupuestos de mil millones, el mensaje es doble: la capacidad de calculo existe y se puede contratar, pero los mejores terminos van hacia quienes se comprometen a volumen y a largo plazo.

    Para los compradores mas pequenos, el efecto puede ser mixto. Que los grandes clientes bloqueen capacidad mediante contratos plurianuales tensiona la disponibilidad para el resto y presiona los precios al alza en periodos de escasez. Al mismo tiempo, la entrada de mas proveedores con inversiones respaldadas por acuerdos ancla incrementa la oferta total a medio plazo. El acuerdo de computacion en la nube entre Reflection y Nebius es, en el fondo, una senal de hacia donde fluye el capital: hacia asegurar computo antes de que escasee.

    Analisis Blixel

    Detras de las cifras llamativas hay una decision de gestion de riesgo bastante conservadora. Comprometer 1.000 millones en computo contratado, en lugar de construir infraestructura propia, es reconocer que nadie sabe con certeza que aceleradores seran competitivos dentro de tres anos ni cuanto valdran. Externalizar traslada ese riesgo de obsolescencia al proveedor. Es una jugada sensata para una empresa centrada en modelos, no en hardware.

    Lo interesante es lo que revela sobre el mercado. Que Nebius, y no solo los gigantes de siempre, firme un contrato de este tamano confirma que la infraestructura para IA se esta diversificando. Eso es sano: menos concentracion significa menos dependencia y, con el tiempo, mas competencia en precios. Pero conviene no idealizarlo. Los acuerdos ancla como este tienden a reservar la mejor capacidad para los grandes clientes, y quien llegue tarde o con presupuesto modesto negociara siempre en peores condiciones. Para las empresas espanolas que evaluan proyectos de IA, la leccion practica es que el computo es un recurso escaso con dinamica de mercado propia: los precios fluctuan, la disponibilidad no esta garantizada y los mejores terminos exigen compromiso. Antes de asumir que la nube resolvera cualquier necesidad de calculo, conviene entender que se compite por esa capacidad con actores que mueven miles de millones. Planificar el acceso al computo debe formar parte de la estrategia, no ser una nota al pie.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Altman contra los centros de datos espaciales de Musk

    Altman contra los centros de datos espaciales de Musk

    Sam Altman ha puesto el foco sobre los centros de datos espaciales de SpaceX con un mensaje directo: los planes de orbitar hardware de inferencia de IA son, segun el, enganosos. El cruce con Elon Musk en redes sociales no es una anecdota mas entre dos figuras del sector. Detras hay una cifra concreta, los 2 billones de dolares de valoracion que se atribuyen a SpaceX, y una dependencia tecnica real: que el cohete Starship funcione. Los expertos consultados coinciden en que la tecnologia no sera viable comercialmente a corto plazo.

    Que ha pasado y por que importa

    El intercambio entre Altman y Musk se produjo en redes sociales, donde el consejero delegado de OpenAI califico de enganosos los planes de SpaceX para desplegar centros de datos en orbita destinados a tareas de inferencia de IA. La inferencia es la fase en la que un modelo ya entrenado responde a peticiones reales, y es donde se concentra buena parte del gasto operativo de las empresas que explotan IA a escala. La idea de SpaceX pasa por llevar ese computo al espacio, aprovechando energia solar continua y refrigeracion en vacio.

    El problema es de calendario y de coste. Los centros de datos espaciales dependen de dos condiciones que hoy no se cumplen: cohetes lo bastante baratos para poner masa en orbita de forma rentable y una capacidad de fabricacion masiva de satelites de alta potencia. Ninguna de las dos existe todavia a la escala necesaria. La pieza que sostiene toda la ecuacion es Starship, cuyo decimotercer vuelo de prueba estaba previsto para el 16 de julio. Sin un Starship operativo y reutilizable de forma fiable, la economia del proyecto no cierra.

    Implicaciones de mercado de una valoracion condicionada

    Lo relevante para el mercado es que los planes de centros de datos espaciales de SpaceX se senalan como el principal motor detras de su valoracion de 2 billones de dolares. Eso convierte una promesa tecnica no probada en el nucleo del argumento financiero de la compania. Cuando una cifra de esa magnitud descansa sobre una tecnologia que los propios expertos consideran inviable comercialmente a corto plazo, cualquier retraso en Starship deja de ser un contratiempo de ingenieria y pasa a ser un riesgo de valoracion.

    La critica de Altman tiene tambien lectura competitiva. OpenAI esta construyendo su propia estrategia de computo en tierra, con acuerdos de infraestructura convencional. Cuestionar la viabilidad del computo orbital de SpaceX es, en parte, defender el modelo que su empresa ya esta ejecutando. Para inversores, proveedores de hardware y clientes que evaluan donde alojar cargas de inferencia, el mensaje de fondo es que las alternativas espaciales no entran todavia en la ecuacion de decision. El horizonte sigue siendo el datacenter terrestre, con sus limites conocidos de energia y refrigeracion.

    Que significa este movimiento para el mercado

    Para los competidores de SpaceX en el segmento de infraestructura, la disputa expone una vulnerabilidad: una valoracion apoyada en un caso de uso que aun no ha demostrado rentabilidad. Los proveedores de GPU y de infraestructura terrestre no tienen motivos para reorientar su hoja de ruta hacia el espacio mientras no exista lanzamiento barato ni produccion de satelites a escala. Los compradores de capacidad de inferencia, que son las empresas que despliegan IA en produccion, deben seguir planificando sobre centros de datos convencionales y contratos de nube ya disponibles. Para los inversores, la lectura es de gestion de expectativas: distinguir entre la capacidad real de lanzamiento de SpaceX, que si esta demostrando avances con Starship, y la promesa de computo orbital, que depende de esos avances pero anade capas adicionales de coste y complejidad todavia sin resolver. La prueba numero 13 de Starship funciona aqui como un indicador practico: cada iteracion acerca o aleja la fecha en la que ese caso de negocio podria empezar a discutirse en serio.

    Analisis Blixel

    Poner ordenadores en orbita para procesar IA suena a solucion a un problema real: los centros de datos terrestres chocan con limites de energia y refrigeracion, y el espacio ofrece sol continuo y frio gratis. El detalle incomodo es que llevar masa a orbita sigue siendo caro y fabricar satelites de alta potencia en cantidad industrial no es algo que exista hoy. Cuando una valoracion de 2 billones se apoya en algo que los propios ingenieros situan a anos vista, conviene separar la ingenieria de la narrativa financiera. La critica de Altman es interesada, claro, porque su empresa juega en tierra. Pero eso no la hace falsa. El punto tecnico es solido: sin Starship reutilizable y barato, el computo orbital no cierra numeros, y aunque Starship madure, quedan por resolver la produccion de satelites y la operacion a escala. Para cualquier empresa que evalue donde alojar cargas de inferencia en los proximos anos, la conclusion practica es que el espacio no es una opcion sobre la mesa. Es una apuesta de largo plazo con muchas condiciones encadenadas. Lo sano es tratar estos anuncios como lo que son, hipotesis de futuro, y tomar decisiones de infraestructura sobre lo que ya funciona y se puede contratar. El ruido en redes entre dos multimillonarios no cambia esa realidad operativa.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • DeepSeek quiere su propio chip y menos Nvidia

    DeepSeek quiere su propio chip y menos Nvidia

    El chip de IA de DeepSeek es el ultimo movimiento de una startup china que ya sacudio el mercado a principios de ano con sus modelos de bajo coste. Segun la informacion disponible, la compania estaria desarrollando su propio procesador para entrenar e inferir sus modelos, con el objetivo de depender menos de las GPU de Nvidia y de los aceleradores de Huawei. No hay fechas ni especificaciones confirmadas, pero la sola intencion tiene peso en un sector donde el acceso al hardware marca quien puede competir y quien no. Aqui separamos lo verificable del ruido.

    Que ha pasado y por que importa

    DeepSeek, conocida por lanzar modelos de lenguaje competitivos a una fraccion del coste habitual, estaria trabajando en su propio silicio de IA. El planteamiento es claro: reducir la dependencia de los procesadores de Nvidia, dificiles de obtener en China por las restricciones de exportacion de Estados Unidos, y tambien de los chips de Huawei, la alternativa domestica de referencia. Este movimiento hacia un chip de IA de DeepSeek propio no es un detalle tecnico menor, sino una decision estrategica sobre el control de su cadena de suministro.

    El contexto explica la urgencia. Las sanciones han limitado el acceso de las empresas chinas a las GPU mas potentes de Nvidia, obligandolas a improvisar con hardware menos capaz o a hacer cola por la oferta local. Huawei ha ocupado parte de ese hueco con su linea Ascend, pero su capacidad de produccion es limitada y la demanda interna es enorme. Para una empresa que hizo de la eficiencia su bandera, disenar hardware a medida de sus modelos es la continuacion logica de esa filosofia, aunque tambien la mas dificil de ejecutar.

    Implicaciones tecnicas y de mercado

    Disenar un chip de IA de DeepSeek propio y fabricarlo son dos problemas distintos. El diseno esta al alcance de un equipo con talento, pero la fabricacion depende de fundiciones con capacidad para procesos avanzados, y ahi las restricciones aprietan de nuevo: el acceso a las litografias mas modernas esta limitado para empresas chinas. Sin una fundicion capaz de fabricar el chip a escala y con buen rendimiento, el diseno se queda en el papel. Es la misma barrera que frena a buena parte de la industria de semiconductores del pais.

    Para el mercado, la senal es que la fragmentacion del hardware de IA se acelera. Si mas actores desarrollan silicio propio adaptado a sus modelos, el dominio casi total de Nvidia deja de ser una certeza a largo plazo, al menos en ciertos mercados. Un chip de IA de DeepSeek, aunque solo sirviera para inferencia y no para entrenamiento, aliviaria costes operativos y reduciria la exposicion a la escasez de GPU. El riesgo es evidente: el proyecto puede quedarse en anuncio, como tantos intentos de silicio propio que nunca llegaron a produccion masiva.

    Que significa este movimiento para el mercado

    Para Nvidia, un cliente menos en China pesa poco a corto plazo, pero la tendencia si importa: cada gran actor que disena su propio hardware reduce el mercado cautivo. Para Huawei, DeepSeek pasaria de cliente potencial a competidor indirecto en aceleradores, justo cuando intenta consolidar su ecosistema Ascend. Para los compradores de IA fuera de China, el impacto directo es limitado, ya que un chip de este tipo dificilmente saldria del mercado interno por las mismas restricciones que lo motivan. Lo relevante para cualquier empresa que planifique infraestructura es entender que la geopolitica del hardware ya no es un tema lejano: condiciona precios, plazos de entrega y disponibilidad de GPU en todo el mundo. Un proveedor que hoy tiene stock puede no tenerlo en seis meses. La leccion para responsables de tecnologia es diversificar proveedores y no atarse a una sola arquitectura antes de tiempo, porque el tablero de los aceleradores de IA se esta moviendo mas rapido de lo que parece.

    Analisis Blixel

    Anunciar un chip propio es facil; fabricarlo en volumen y que funcione es otra historia. Conviene mirar este tipo de noticias con escepticismo sano, porque la distancia entre la intencion y una oblea que rinde en produccion esta llena de proyectos abandonados. Dicho esto, la logica detras del movimiento es solida y encaja con lo que DeepSeek ya ha demostrado: obsesion por hacer mas con menos. Una empresa que optimizo el software hasta competir con presupuestos ajustados tiene incentivos claros para controlar tambien la capa de hardware, sobre todo cuando el acceso a las GPU importadas es una loteria. El verdadero cuello de botella no es el talento de diseno, que en China abunda, sino la fabricacion en procesos avanzados, bloqueada por las restricciones actuales. Ahi es donde el proyecto se juega su viabilidad. Para quienes trabajamos en integracion de IA, lo interesante no es si DeepSeek lo consigue, sino la senal de fondo: la era de un unico proveedor dominante de aceleradores tiene fecha de caducidad, aunque nadie sepa cuando llega. Esa fragmentacion es buena para los precios a largo plazo, pero complica la planificacion a corto. Nuestra recomendacion de siempre: disenar arquitecturas que no dependan de un chip ni de un proveedor concreto, porque el suelo se mueve. La flexibilidad es hoy mas valiosa que apostar por el ganador.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Micron cierra con Ford su segundo pacto de chips

    Micron cierra con Ford su segundo pacto de chips

    El acuerdo de suministro de chips entre Micron y Ford confirma un patron: los fabricantes de coches quieren asegurar memoria a largo plazo y no depender del mercado spot. Ford Motor Company y Micron Technology han firmado un contrato a largo plazo para abastecer de chips de memoria la produccion de sus vehiculos de proxima generacion. Llega solo una semana despues de que Micron anunciara un pacto similar con General Motors, lo que dibuja una estrategia deliberada del fabricante de semiconductores para anclarse en el sector del automovil.

    Que ha pasado y por que importa

    Ford y Micron han sellado un acuerdo a largo plazo para el suministro de chips de memoria destinados a los vehiculos de proxima generacion del fabricante. El movimiento se produce apenas siete dias despues de que Micron cerrara un contrato equivalente con General Motors, lo que convierte a dos de los mayores fabricantes de Detroit en clientes comprometidos del proveedor de memoria. El acuerdo de suministro de chips entre Micron y Ford no detalla volumenes ni cifras economicas, pero su naturaleza a largo plazo es la parte relevante: no es una compra puntual, es un compromiso de abastecimiento sostenido.

    El contexto ayuda a entenderlo. La crisis de semiconductores de 2021 y 2022 dejo lineas de montaje paradas y miles de coches sin terminar por falta de chips. Aquella experiencia empujo a los fabricantes de automoviles a negociar directamente con los proveedores de silicio en lugar de dejarlo en manos de los proveedores de componentes intermedios. Un coche moderno integra memoria en sistemas de infoentretenimiento, asistencia a la conduccion, gestion del motor y conectividad. Cerrar el suministro por adelantado reduce el riesgo de volver a quedarse sin piezas criticas.

    Implicaciones tecnicas y de mercado

    El acuerdo de suministro de chips entre Micron y Ford refuerza la idea de que la memoria se ha vuelto un componente estrategico en automocion, no una mercancia intercambiable. Los vehiculos de proxima generacion exigen mas memoria y de mayor ancho de banda para soportar pantallas, sistemas de conduccion asistida y actualizaciones de software over-the-air. Para Micron, encadenar acuerdos con GM y Ford en una misma semana significa diversificar ingresos mas alla de los centros de datos y los moviles, mercados sujetos a ciclos de precios muy volatiles.

    Para el resto del sector, la lectura es clara. Los fabricantes de coches estan replicando el modelo de contratos plurianuales que ya usan con baterias y materias primas. Eso deja a proveedores de memoria competidores en la posicion de tener que ofrecer garantias de capacidad similares o arriesgarse a quedar fuera de los programas de vehiculos que se disenan hoy y llegaran al mercado dentro de varios anos. La memoria de grado automotriz, ademas, requiere certificaciones de fiabilidad y rangos de temperatura mas exigentes que la de consumo, lo que estrecha el numero de proveedores capaces de cumplir.

    Que significa este movimiento para el mercado

    Para los competidores de Micron, la senal es que los grandes programas de automocion se estan adjudicando ahora y por contrato largo. Quien no tenga capacidad certificada de grado automotriz disponible corre el riesgo de perder cuota en un segmento que crece con cada nueva generacion de vehiculos definidos por software. Para los propios fabricantes de coches que aun no han cerrado suministro, el mensaje es que la ventana de negociacion en condiciones favorables se estrecha a medida que la capacidad se compromete. Para los proveedores de componentes intermedios (los tier 1), el hecho de que Ford y GM negocien directamente con el fabricante de silicio les resta control sobre una pieza que antes gestionaban ellos. Los buyers de automocion salen reforzados en previsibilidad, pero a cambio de comprometerse a volumenes y plazos que reducen su flexibilidad si la demanda de vehiculos cambia. En conjunto, el mercado de memoria para automocion se profesionaliza y se parece cada vez mas al de otros componentes criticos: menos compras oportunistas y mas relaciones contractuales estables entre fabricante de coches y proveedor de chips.

    Analisis Blixel

    Lo interesante no es el contrato en si, sino la velocidad. Dos pactos con dos gigantes de Detroit en siete dias no es casualidad, es una campana comercial ordenada para posicionarse antes que la competencia en el ciclo de disenos que definira los coches de la proxima decada. El automovil se ha convertido en un ordenador con ruedas, y quien controla la memoria controla una parte del margen y del calendario de produccion de esos vehiculos. La lectura de fondo, mas alla del hardware, es sobre gestion de riesgo en la cadena de suministro. Ford y GM aprendieron por las malas en 2021 lo que cuesta parar una fabrica por falta de un chip de pocos euros, y estan comprando seguridad a cambio de flexibilidad. Es una decision defensiva sensata, aunque implica atarse a volumenes que quiza no encajen si el mercado del coche se enfria. Para cualquier empresa que dependa de componentes criticos, la moraleja es reconocible: cuando un insumo pequeno puede paralizar toda tu operacion, la negociacion no va de precio, va de garantia de suministro. La puntuacion baja de esta noticia refleja que hay pocos datos concretos (ni cifras ni volumenes), pero la tendencia que confirma es solida y merece seguimiento.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Anthropic sella un pacto de centros de datos de 19.000M

    Anthropic sella un pacto de centros de datos de 19.000M

    El acuerdo de centro de datos de Anthropic con el desarrollador TeraWulf marca uno de los compromisos de infraestructura mas grandes firmados por una empresa de IA hasta la fecha. Se trata de un arrendamiento a 20 anos que, segun lo contratado, generara 19.000 millones de dolares en ingresos para TeraWulf durante el periodo inicial. La cifra situa a Anthropic en la carrera por asegurar capacidad de computo a largo plazo, un recurso que hoy escasea y que condiciona la velocidad a la que cualquier laboratorio puede entrenar y servir sus modelos.

    Que ha pasado y por que importa

    TeraWulf, un desarrollador de centros de datos con sede en EE.UU., ha firmado un contrato de arrendamiento a 20 anos con Anthropic. El propio documento estima que el acuerdo generara 19.000 millones de dolares en ingresos contratados a lo largo del periodo inicial. No hablamos de una compra puntual de servidores, sino de un compromiso de capacidad sostenido en el tiempo, lo que da a Anthropic visibilidad sobre la infraestructura que necesitara para entrenar y desplegar sus modelos Claude durante las proximas dos decadas.

    El acuerdo de centro de datos de Anthropic encaja en un patron que se repite en el sector: los laboratorios de IA ya no compiten solo por talento o por arquitecturas de modelos, sino por metros cuadrados de sala tecnica, acceso a energia y capacidad de refrigeracion. Firmar arrendamientos ultralargos permite bloquear precio y disponibilidad frente a una demanda que crece mas rapido de lo que se construyen instalaciones nuevas. Para TeraWulf, un contrato de esta magnitud con un cliente ancla transforma su perfil de riesgo y su capacidad de financiar futuras expansiones.

    Implicaciones de mercado del acuerdo

    Un compromiso de 19.000 millones a 20 anos cambia las reglas del juego para ambas partes. Anthropic asegura capacidad de computo predecible, algo critico cuando el cuello de botella de la industria ya no es la investigacion sino la infraestructura fisica que la sostiene. Contar con un proveedor dedicado reduce la dependencia de la capacidad de terceros que puede reasignarse a otros clientes en picos de demanda.

    El acuerdo de centro de datos de Anthropic tambien envia una senal financiera clara. Los desarrolladores de centros de datos que consigan clientes ancla del calibre de un laboratorio de IA puntero acceden a mejores condiciones de financiacion para levantar nueva capacidad. Ese circulo (contrato largo, financiacion mas barata, mas construccion) es exactamente lo que necesita un mercado que hoy no da abasto. Para los competidores de TeraWulf, la lectura es que la ventana para captar contratos plurianuales con los grandes de la IA sigue abierta, pero se estrecha a medida que los laboratorios cierran sus compromisos de capacidad. Y para el resto del ecosistema, confirma que la infraestructura se ha convertido en el terreno donde se decide buena parte de la competencia.

    Que significa este movimiento para el mercado

    Para los proveedores de computo, el mensaje es que los contratos ultralargos con clientes ancla se han vuelto la moneda de cambio: quien los firma, financia; quien no, compite por sobras. Para los buyers empresariales que consumen modelos de Anthropic via API, este tipo de acuerdo aporta una senal de continuidad operativa, porque detras del servicio hay capacidad reservada a 20 anos y no una infraestructura alquilada mes a mes. Para los competidores de Anthropic, la presion por cerrar su propia capacidad se intensifica, ya que cada gran arrendamiento firmado reduce el pool disponible en un mercado tensionado por energia y refrigeracion. El acuerdo de centro de datos de Anthropic no es un anuncio de producto, sino un movimiento estrategico de aprovisionamiento que redefine el mapa de dependencias entre laboratorios, desarrolladores de infraestructura y las electricas que alimentan estas instalaciones. Conviene seguir de cerca quien firma con quien: esos contratos anticipan quien tendra capacidad para servir modelos a escala en los proximos anos y quien quedara limitado por falta de sala tecnica.

    Analisis Blixel

    La verdadera guerra de la IA se libra hoy en subestaciones electricas y salas de servidores, no en los papers. Cuando una empresa se compromete a 20 anos y 19.000 millones por adelantado, esta admitiendo que el limite de su crecimiento no es la inteligencia de sus modelos, sino los kilovatios y los metros cuadrados a los que puede acceder. Es una apuesta racional en un mercado donde la capacidad tarda anos en construirse y la demanda cambia en meses. El riesgo evidente es de sobreexposicion: firmar dos decadas de compromiso asume que la trayectoria de crecimiento actual se mantiene, algo que ningun ciclo tecnologico ha garantizado nunca. Si la eficiencia de los modelos mejora mas rapido de lo previsto, parte de esa capacidad reservada podria quedar infrautilizada. Para las PYMEs y directivos que observan desde fuera, hay una leccion util sin necesidad de firmar nada millonario: la disponibilidad de computo influye directamente en el precio y la estabilidad de los servicios de IA que consumen. Un proveedor con capacidad asegurada ofrece mas garantias de continuidad que uno que improvisa su infraestructura. No es motivo para elegir a nadie a ciegas, pero si un factor a incluir en cualquier evaluacion de proveedor de IA a medio plazo. La infraestructura, aburrida como suena, es lo que sostiene todo lo demas.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Samsung anticipa beneficios record por los chips de IA

    Samsung anticipa beneficios record por los chips de IA

    Los beneficios record de Samsung por la IA confirman que la fiebre de la inteligencia artificial ya no es solo cosa de las empresas de software. El fabricante surcoreano pronostico beneficios operativos record para el segundo trimestre e ingresos superiores a 171 billones de wones, unos 113.000 millones de dolares, impulsados por la demanda global de chips de memoria para IA. La cifra situa a Samsung como uno de los grandes beneficiados de la carrera por construir infraestructura de computo, y confirma que el cuello de botella del sector se ha desplazado hacia el hardware.

    Que ha pasado y por que importa

    Samsung Electronics ha adelantado una prevision de beneficios operativos record para su segundo trimestre, acompanada de ingresos que superan los 171 billones de wones, equivalentes a unos 113.000 millones de dolares. Segun la propia compania, el motor de estas cifras es la demanda global de chips de memoria destinados a cargas de trabajo de inteligencia artificial. Los beneficios record de Samsung por la IA reflejan un mercado donde cada centro de datos que entrena o ejecuta modelos necesita cantidades crecientes de memoria de alto rendimiento.

    El dato importa porque marca un cambio de ciclo para el fabricante. Tras varios trimestres de precios deprimidos en el segmento de memoria, la demanda ligada a la IA ha invertido la tendencia. La memoria dejo de ser un componente barato y abundante para convertirse en un recurso escaso y estrategico. Samsung, junto a sus competidores directos, se encuentra en el centro de una cadena de suministro que condiciona la velocidad a la que el resto de la industria puede desplegar sus modelos.

    Implicaciones tecnicas y de mercado

    La demanda que impulsa los beneficios record de Samsung por la IA se concentra en la memoria de alto ancho de banda, la HBM, que acompana a los aceleradores de las GPU en los servidores de entrenamiento. Este tipo de chips de memoria se apila verticalmente para ofrecer un ancho de banda muy superior al de la memoria convencional, y su fabricacion es compleja y de margenes elevados. Cuando un fabricante como Samsung reporta cifras record, la senal es doble: hay demanda sostenida y los precios se mantienen altos.

    Para el mercado, esto tiene un efecto en cadena. Los grandes proveedores de nube y las empresas que construyen clusters de entrenamiento compiten por asegurar suministro de memoria con meses de antelacion. Esa presion se traslada a los precios de los aceleradores completos y, en ultima instancia, al coste de entrenar e inferir modelos. La memoria se ha convertido en un factor tan critico como la propia capacidad de computo, y quien controla su produccion gana peso negociador en toda la cadena de la IA.

    Que significa este movimiento para el mercado

    Para los competidores directos de Samsung en memoria, estas cifras confirman que la ventana de precios altos sigue abierta y refuerzan la carrera por ampliar capacidad de fabricacion de HBM. Para los proveedores de nube y los fabricantes de aceleradores, el mensaje es menos comodo: dependen de un grupo reducido de fabricantes de memoria y esa dependencia encarece sus propios productos. Los buyers empresariales que planean invertir en infraestructura propia deben asumir que los componentes clave seguiran caros y con plazos de entrega largos mientras la demanda de IA no se enfrie. En la practica, esto favorece el modelo de alquiler de computo en la nube frente a la compra de hardware propio para la mayoria de organizaciones, ya que amortizar servidores con memoria a precios record exige un volumen de uso muy alto. El movimiento tambien consolida el poder de negociacion de los fabricantes de memoria dentro de la cadena de valor de la IA, un lugar que hasta hace poco ocupaban casi en exclusiva los fabricantes de GPU.

    Analisis Blixel

    Conviene mirar estas cifras con perspectiva antes de celebrarlas como prueba del exito de la IA. Lo que realmente muestran es donde esta el dinero y donde estan los cuellos de botella: no en los modelos, sino en el silicio que los sostiene. Un fabricante de memoria batiendo records de beneficios significa que la infraestructura para entrenar y ejecutar IA sigue siendo cara, escasa y concentrada en pocas manos. Para una PYME espanola, la lectura util no es que la IA vaya bien en bolsa, sino que el coste subyacente del computo no va a bajar a corto plazo. Cualquier proyecto que dependa de entrenar modelos propios o de un consumo masivo de inferencia se topara con esa realidad de precios. La recomendacion sensata es apoyarse en modelos ya entrenados via API, optimizar el consumo y evitar la tentacion de montar infraestructura propia salvo que el volumen lo justifique de sobra. Estas cifras tambien recuerdan que buena parte del valor de la IA se lo estan llevando quienes venden picos y palas, no quienes buscan oro. Para el tejido empresarial, la prioridad debe seguir siendo el caso de uso concreto y el retorno medible, no seguir la euforia de un mercado de componentes que responde a dinamicas muy alejadas del dia a dia de la mayoria de negocios.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Apple sigue atada a Broadcom en chips hasta 2031

    Apple sigue atada a Broadcom en chips hasta 2031

    El acuerdo de chips personalizados entre Broadcom y Apple se extiende hasta 2031, una senal clara de que el fabricante del iPhone tardara todavia varios anos en desprenderse de sus proveedores externos de silicio. La ampliacion de una alianza de larga duracion apunta a que el paso completo hacia los chips de la serie C disenados por la propia Apple no es inminente, pese a la ambicion de la companhia por controlar cada capa de su hardware. El anuncio reordena expectativas en toda la cadena de suministro de semiconductores.

    Que ha pasado y por que importa

    Broadcom y Apple han acordado expandir su asociacion de larga data hasta 2031. Es una relacion que lleva anos funcionando: Broadcom suministra componentes clave para los dispositivos de Apple, y esta extension prolonga ese vinculo casi hasta el final de la decada. El mensaje de fondo es que el acuerdo de chips personalizados entre Broadcom y Apple sigue siendo estrategico para ambas partes, y que la transicion hacia el silicio interno de Apple avanza mas despacio de lo que muchos anticipaban.

    La lectura mas directa es temporal. Un cambio completo a los propios chips de la serie C del fabricante del iPhone podria tardar aun varios anos, segun se desprende del propio calendario del acuerdo. Si Apple planeara sustituir de forma inmediata la tecnologia de Broadcom, no firmaria una prorroga que llega hasta 2031. Ese horizonte da a Broadcom visibilidad de ingresos a largo plazo y confirma que Apple, pese a su historial de internalizar componentes, no puede prescindir de golpe de socios especializados en radiofrecuencia y conectividad.

    Implicaciones tecnicas y de mercado

    Apple lleva anos ejecutando una estrategia de verticalizacion: primero los procesadores de la serie M en Mac, despues sus propios modems y componentes de conectividad. El acuerdo de chips personalizados entre Broadcom y Apple muestra los limites practicos de esa ambicion. Disenar y fabricar chips de radiofrecuencia y de conectividad inalambrica a escala, con la fiabilidad que exige el volumen del iPhone, es un reto distinto al de un SoC de computo. La serie C representa ese esfuerzo, pero madurar una linea propia lleva tiempo y validaciones que no se aceleran por decreto.

    Para el mercado de semiconductores, la extension estabiliza la posicion de Broadcom como proveedor de referencia en componentes de alto margen. Un contrato que se prolonga hasta 2031 asegura previsibilidad frente a las dudas recurrentes sobre cuando Apple cortaria el cordon. Al mismo tiempo, el acuerdo no cierra la puerta a la transicion: la coexiste con ella. Apple gana tiempo para perfeccionar su silicio sin poner en riesgo el suministro de productos que salen al mercado cada ano por decenas de millones de unidades.

    Que significa este movimiento para el mercado

    Para Broadcom, la extension despeja incertidumbre en una relacion que era su mayor punto de exposicion: la posibilidad de que Apple lo sustituyera. Con visibilidad hasta 2031, refuerza su tesis de ingresos recurrentes y reduce la presion de tener que compensar rapido ese hueco. Para competidores y otros proveedores de radiofrecuencia, el mensaje es que Apple prioriza la fiabilidad de suministro sobre la sustitucion agresiva, lo que mantiene abierto el negocio de componentes especializados durante mas tiempo del previsto.

    Para el resto de fabricantes de hardware que observan la estrategia de Apple como referencia, la leccion es de ritmo. Internalizar silicio es viable, pero la conectividad y la radiofrecuencia son las piezas mas dificiles de replicar. Los compradores corporativos de chips deberian leer esta senal como confirmacion de que las alianzas con proveedores especializados seguiran siendo necesarias incluso para el actor con mas recursos del sector. La verticalizacion total es una meta, no un interruptor.

    Analisis Blixel

    Controlar el diseno del propio silicio es la jugada estrategica mas repetida de la ultima decada en hardware, y por buenas razones: margenes, diferenciacion y menos dependencia. Pero hay una diferencia enorme entre disenar un procesador de computo y dominar la radiofrecuencia, donde la fisica, las certificaciones y el volumen no perdonan. Que Apple, con su presupuesto y su talento, firme una prorroga hasta 2031 dice mas sobre la dificultad real de este terreno que cualquier hoja de ruta optimista. La serie C llegara, pero el calendario manda. Lo interesante para quien evalua proveedores tecnologicos no es el titular de la independencia, sino la cadencia con la que se ejecuta: incluso los gigantes mantienen socios criticos durante anos porque el coste de un fallo de suministro supera al de compartir margen. Para una PYME o una empresa media que decide entre construir capacidad interna o apoyarse en un proveedor especializado, la senal es util. Si Apple no fuerza la transicion de un dia para otro, tampoco tiene sentido asumir que internalizar todo es siempre la mejor decision. La dependencia bien gestionada, con contratos largos y proveedores solidos, es una estrategia legitima y muchas veces mas racional que la autosuficiencia a cualquier precio. El pragmatismo, aqui, gana a la ambicion.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • ZML lanza un servidor de inferencia gratis multichip

    ZML lanza un servidor de inferencia gratis multichip

    El servidor de inferencia multichip que acaba de publicar la startup francesa ZML apunta a un problema muy concreto: hoy ejecutar modelos de lenguaje open source suele atarte a un unico fabricante de hardware. ZML/LLMD es gratuito y corre esos modelos sobre chips de Nvidia, AMD, Google TPU, Apple Metal e Intel Arc. Detras hay una compania parisina de 20 empleados, respaldada por Yann LeCun, que ha levantado 20 millones de dolares. La promesa es directa: elegir el chip por precio o eficiencia, no por obligacion.

    Que ha lanzado ZML y por que importa

    ZML ha presentado ZML/LLMD, un servidor de inferencia multichip de codigo disponible sin coste que ejecuta modelos de lenguaje open source sobre distintas arquitecturas de aceleradores. La lista de hardware compatible incluye GPU de Nvidia, GPU de AMD, las TPU de Google, la capa Metal de Apple y las Intel Arc. El objetivo declarado es romper el vendor lock-in que hoy domina el despliegue de IA, donde una parte enorme de la inferencia se concentra en un solo proveedor y su stack de software asociado.

    La startup, con sede en Paris y solo 20 empleados, ha recaudado 20 millones de dolares. Entre sus respaldos figura el fondo 20VC y, como inversores, los fundadores de Hugging Face y de Docker, ademas del apoyo de Yann LeCun. Ese perfil de inversores no es casual: son nombres muy ligados al open source, a la portabilidad y a la infraestructura para desarrolladores, justo el terreno donde ZML quiere jugar con su servidor de inferencia multichip.

    Implicaciones tecnicas y de mercado

    La dependencia de un unico fabricante de aceleradores tiene un coste real: precios, plazos de entrega y disponibilidad quedan condicionados por ese proveedor. Un servidor de inferencia multichip capaz de abstraer la capa de hardware permite, sobre el papel, mover cargas de trabajo hacia el acelerador mas barato o mas eficiente energeticamente en cada momento, e incluso combinar varios tipos de chip en un mismo despliegue.

    Tecnicamente, el reto de un servidor asi es sostener rendimiento razonable sobre backends muy distintos: no es lo mismo optimizar para el ecosistema de Nvidia que para TPU, Metal o Intel Arc. Que la herramienta sea gratuita reduce la barrera de entrada para probarla, aunque el valor de negocio de una startup de este tipo suele estar en el soporte, las funciones avanzadas o el servicio gestionado. Para el mercado, cualquier avance en portabilidad de la inferencia presiona a la baja el poder de fijacion de precios del proveedor dominante y da mas margen de maniobra a quienes despliegan modelos open source en produccion.

    Como pueden aplicar esto las empresas hoy

    Si tu empresa ya sirve modelos open source, lo primero es medir: cuanto pagas hoy por inferencia y sobre que hardware. Con ese dato, un servidor de inferencia multichip como ZML/LLMD permite montar una prueba controlada comparando el mismo modelo sobre GPU de AMD, TPU o Intel Arc frente a tu configuracion actual, evaluando latencia, coste por millon de tokens y consumo energetico. La clave es benchmarkear con tus prompts y tu carga real, no con cifras genericas.

    Que evitar: migrar produccion de golpe. Al ser un proyecto reciente y gratuito, conviene tratarlo como piloto, validar estabilidad y comprobar que el rendimiento sobre hardware alternativo compensa el ahorro. Tampoco tiene sentido para quien apenas hace inferencia; el ROI aparece cuando el volumen es alto y sostenido, que es donde la factura de aceleradores duele. Para PYMEs con casos de uso puntuales, la recomendacion es esperar a validaciones de terceros antes de reorganizar la infraestructura.

    Analisis Blixel

    Atar la inferencia a un solo fabricante de chips ha sido durante anos la norma silenciosa del sector, y cualquiera que haya pagado una factura de GPU en produccion sabe lo cara que sale esa comodidad. Por eso una herramienta que abstrae el hardware y deja elegir acelerador por criterios de coste y eficiencia toca un nervio real. Dicho esto, hay que separar la promesa de la realidad operativa: escribir un servidor que corre sobre cinco arquitecturas es una cosa, y que rinda bien sobre las cinco sin sorpresas es otra muy distinta. La optimizacion fina siempre ha favorecido al ecosistema dominante, y ahi es donde estas iniciativas suelen sufrir. El respaldo de nombres del open source y la infraestructura para devs da credibilidad, y que sea gratuito facilita que la comunidad lo ponga a prueba rapido, que es exactamente lo que necesita para madurar. Nuestro consejo para quien despliega IA en serio: probarlo en un entorno aislado, medir con datos propios y no fiarse de comparativas de laboratorio. El valor estrategico no es tanto ahorrar hoy como tener la opcion de moverse manana sin reescribir todo. Esa opcionalidad, en un mercado con precios volatiles de hardware, ya justifica dedicarle unas horas de evaluacion. La pregunta abierta es si el rendimiento sobre chips alternativos sera suficiente para que el cambio compense de verdad.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.
  • SambaNova capta 1.000 millones y vale 11.000

    SambaNova capta 1.000 millones y vale 11.000

    La ronda Serie F de SambaNova ha cerrado con 1.000 millones de dolares y una valoracion de 11.000 millones, apenas cinco meses despues de su Serie E. El movimiento, liderado por General Atlantic, coloca a la empresa como proveedor de infraestructura de inferencia para bancos y gobiernos que quieren ejecutar grandes modelos de IA sin depender de la nube publica. El fichaje de JPMorgan Chase como socio de infraestructura de inferencia refuerza esa tesis. Aqui te explicamos que hay detras de la cifra y que significa para el mercado de chips y computo de IA.

    Que ha pasado y por que importa

    SambaNova Systems ha cerrado una ronda Serie F de 1.000 millones de dolares liderada por General Atlantic, alcanzando una valoracion de 11.000 millones. Lo llamativo es el ritmo: la ronda llega apenas cinco meses despues de su Serie E de 350 millones. Ese intervalo tan corto entre dos rondas de ese tamano dice mucho sobre el apetito inversor por la infraestructura de inferencia de IA privada, un segmento que hasta hace poco quedaba eclipsado por el entrenamiento de modelos.

    La empresa se posiciona como proveedor de infraestructura de inferencia para grandes modelos, con foco explicito en bancos y gobiernos que buscan alternativas privadas a los servicios cloud publicos. El anuncio mas relevante acompana a la cifra: JPMorgan Chase ha seleccionado a SambaNova como socio de infraestructura de inferencia, y ejecutara modelos de IA de forma segura en sus instalaciones usando los sistemas SN40L y SN50.

    El contexto ayuda a entender el salto. Durante los ultimos dos anos el gasto en IA se concentro en el entrenamiento, dominado por un unico proveedor de GPU. A medida que las empresas pasan de experimentar a poner modelos en produccion, el coste recurrente se desplaza hacia la inferencia. Ahi es donde la infraestructura de inferencia de SambaNova busca su hueco, ofreciendo hardware propio como alternativa al modelo dominante.

    Implicaciones tecnicas y de mercado

    La apuesta de SambaNova no es competir en entrenamiento, sino en el despliegue en produccion. Sus sistemas SN40L y SN50 estan disenados para ejecutar grandes modelos con un enfoque de infraestructura de inferencia instalable dentro del perimetro del cliente. Para un banco o una administracion publica, ese matiz es decisivo: pueden servir modelos sin que los datos salgan a una nube publica de terceros, un requisito frecuente en entornos regulados donde la soberania del dato pesa tanto como el rendimiento.

    El caso de JPMorgan funciona como sello de validacion. Que una entidad financiera de ese tamano confie su inferencia de IA privada a un proveedor alternativo es una senal para el resto del sector: existe demanda real de opciones fuera del oligopolio actual de computo. La ronda Serie F, con General Atlantic al frente, financia precisamente la escala necesaria para atender esa demanda.

    El mercado de la infraestructura de inferencia se esta segmentando. Por un lado, los hiperescaladores con sus servicios gestionados; por otro, proveedores de hardware especializado que venden despliegue on-premise. SambaNova se coloca en el segundo grupo, apostando a que la sensibilidad al coste por token y las exigencias de cumplimiento empujen a bancos y gobiernos hacia soluciones instaladas en casa. La valoracion de 11.000 millones descuenta que ese desplazamiento sera sostenido.

    Que significa este movimiento para el mercado

    Para los competidores directos, la ronda Serie F de SambaNova sube el liston de capital necesario para jugar en infraestructura de inferencia. Los fabricantes de aceleradores alternativos que buscaban clientes en banca y sector publico ahora compiten contra una empresa con 1.000 millones frescos y un cliente ancla del peso de JPMorgan. Para el proveedor dominante de GPU, no es una amenaza inmediata a su liderazgo en entrenamiento, pero si una senal de que la inferencia sera un campo mucho mas disputado.

    Para los compradores (bancos, gobiernos, grandes corporaciones reguladas) la noticia es buena: mas oferta significa mas poder de negociacion y menos dependencia de un unico proveedor. La eleccion de JPMorgan legitima el on-premise como opcion seria frente al cloud publico. Para los inversores, el intervalo de cinco meses entre rondas confirma que el capital sigue fluyendo hacia el hardware de inferencia. El riesgo es de concentracion: valoraciones que dependen de que la demanda de despliegue privado crezca al ritmo que el precio descuenta. Si la inferencia se abarata mas rapido en la nube, el argumento del on-premise se debilita.

    Analisis Blixel

    El dinero ya no persigue el modelo mas grande, sino el modelo que se puede ejecutar de forma barata y segura una y otra vez. Ese giro es el que explica que una empresa de hardware alcance los 11.000 millones vendiendo cajas que se instalan en el sotano de un banco. Durante mucho tiempo la conversacion giro en torno a quien entrena el modelo mas potente; hoy la pregunta operativa es cuanto cuesta cada respuesta cuando lo usan diez mil empleados a diario.

    La eleccion de JPMorgan es la parte que mas nos interesa. No es una prueba de concepto ni un piloto de laboratorio: es una entidad que decide que sus datos no salen de casa y que prefiere pagar por hardware propio antes que por consumo en la nube. Ese calculo tiene sentido para quien opera a gran escala y bajo regulacion estricta, pero es un traje a medida que no sirve para todos. Una PYME rara vez amortizara un sistema on-premise frente a una API gestionada.

    Nuestra lectura es de prudencia optimista. Que exista competencia real en inferencia es sano para todo el mercado y presiona precios a la baja. Pero conviene separar la senal del ruido: la valoracion descuenta un futuro de despliegue privado masivo que aun no esta garantizado. Si el coste de inferencia en la nube cae con fuerza, parte de ese argumento se evapora. De momento, la banca vota con su presupuesto, y eso pesa mas que cualquier presentacion.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.

  • Samsung y KDDI logran mejoras de dos digitos en 5G

    Samsung y KDDI logran mejoras de dos digitos en 5G

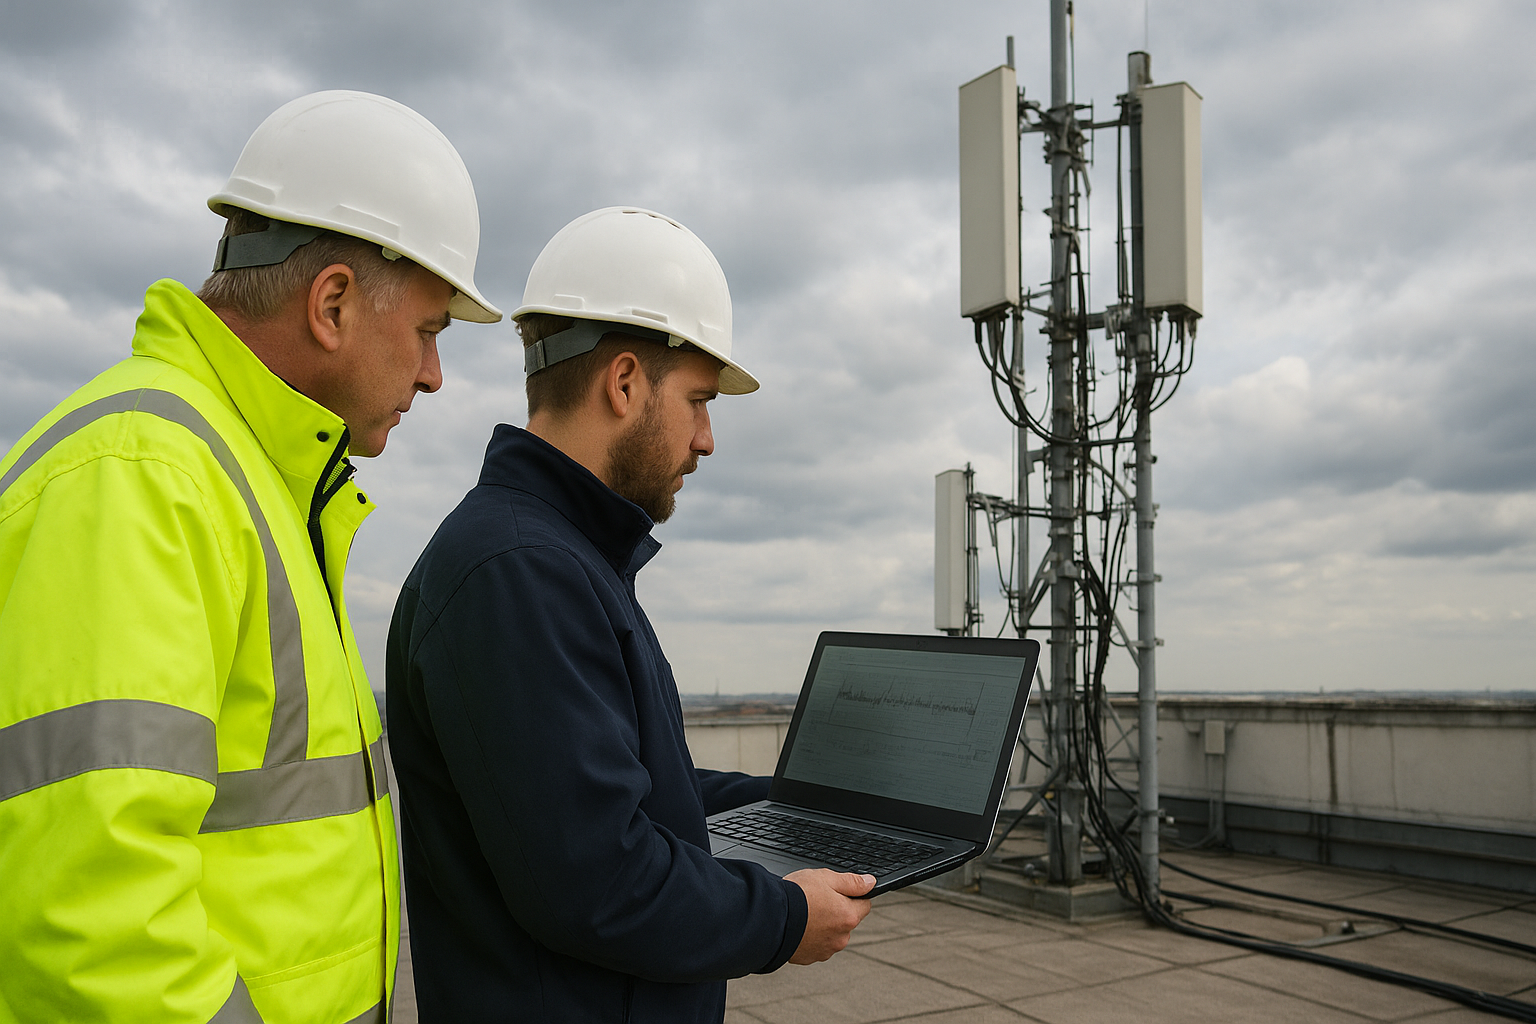
    La optimizacion de red con AI-RAN en 5G acaba de dejar de ser una promesa de laboratorio. Samsung y el operador japones KDDI han presentado los resultados de una prueba conjunta en la que aplicaron inteligencia artificial a la gestion de la red de acceso radio (RAN) y obtuvieron mejoras de dos digitos en el rendimiento de la red 5G. No es un anuncio de producto comercial todavia, pero si una de las primeras demostraciones con datos concretos de que la IA aplicada a la capa de radio puede traducirse en beneficios operativos medibles para un operador movil real.

    Que ha pasado y por que importa

    KDDI y Samsung ejecutaron una prueba de tecnologia de optimizacion RAN basada en inteligencia artificial que, segun los resultados presentados, logro ganancias de dos digitos en el rendimiento de la red 5G. La clave del anuncio no esta en la cifra aislada, sino en que aporta evidencia tangible de los beneficios operativos que la IA puede entregar cuando se integra en la gestion de la red de acceso radio, la parte de la infraestructura que conecta las antenas con los dispositivos de los usuarios.

    La RAN es historicamente uno de los componentes mas costosos y complejos de operar en una red movil. Ajustar parametros, equilibrar carga entre celdas y adaptar la red a patrones de trafico cambiantes ha dependido tradicionalmente de reglas fijas y de intervencion manual. La propuesta de AI-RAN consiste en delegar parte de esas decisiones a modelos que aprenden del comportamiento real de la red. Que un operador de la escala de KDDI valide la optimizacion de red con AI-RAN en 5G con resultados concretos marca un paso desde la teoria hacia el despliegue.

    Implicaciones tecnicas de la optimizacion de red con AI-RAN

    La optimizacion de red con AI-RAN en 5G funciona porque la capa de radio genera una enorme cantidad de datos en tiempo real: calidad de senal, congestion por celda, movilidad de usuarios y consumo de recursos. Los modelos de IA pueden analizar esos flujos y ajustar la configuracion de forma continua, algo inviable a mano en redes con miles de celdas. Una mejora de dos digitos en rendimiento puede significar mas capacidad efectiva con la misma infraestructura fisica, lo que impacta directamente en el coste por bit transmitido.

    Para el sector, este tipo de prueba encaja en la tendencia mas amplia de aplicar inteligencia artificial a toda la pila de red, no solo al nucleo. El concepto AI-RAN ha ganado traccion en los ultimos anos como via para exprimir la inversion en 5G, cuya monetizacion ha sido mas lenta de lo esperado en muchos mercados. Que Samsung, como proveedor de equipamiento, y KDDI, como operador, colaboren en esta linea sugiere que la optimizacion de red con AI-RAN en 5G podria pasar de piloto a funcion estandar del equipamiento en los proximos ciclos de despliegue. Conviene, eso si, tratar la cifra como un resultado de prueba controlada y no como un promedio garantizado en cualquier red en produccion.

    Como pueden aplicar esto las empresas hoy

    Para la mayoria de empresas, la optimizacion de red con AI-RAN en 5G es una tecnologia que llega a traves del operador, no algo que se compre e instale directamente. La accion concreta a corto plazo es distinta segun el perfil. Las empresas con redes privadas 5G (fabricas, logistica, puertos, campus industriales) si deberian preguntar a sus proveedores si incorporan o planean incorporar optimizacion basada en IA, porque ahi el rendimiento de la RAN afecta directamente a procesos criticos como automatizacion, vision artificial o vehiculos guiados. Para el resto, la lectura util es de planificacion: si estas evaluando casos de uso que dependen de baja latencia y ancho de banda estable, mejoras de este tipo hacen que ese escenario sea mas viable a medio plazo. Lo que conviene evitar es reescribir un plan de conectividad basandose en una unica prueba. Aun no hay disponibilidad comercial anunciada ni cifras de coste, asi que la decision sensata es monitorizar la evolucion y exigir metricas verificables antes de comprometer inversion.

    Analisis Blixel

    El valor real de este anuncio no esta en el porcentaje, sino en el mensaje de fondo: la industria de telecomunicaciones ha encontrado por fin un lugar donde la IA resuelve un problema concreto y caro en lugar de anadir una capa de marketing. Gestionar miles de celdas con reglas fijas era ineficiente por definicion, y delegar esas decisiones a modelos que aprenden del trafico real es una aplicacion honesta de la tecnologia. Dicho esto, conviene mantener el escepticismo profesional. Una prueba entre un fabricante y un operador tiene incentivos evidentes para lucir bien, y el salto entre un piloto controlado y una red nacional con millones de usuarios es enorme. Las variables de una demostracion rara vez sobreviven intactas al mundo real. Para las empresas espanolas el mensaje practico es de paciencia activa: esto no cambia nada esta semana, pero refuerza que el 5G que llegara en dos o tres anos sera mas capaz y probablemente mas barato de operar, lo que abre la puerta a casos de uso industriales que hoy no salen rentables. El error seria tratar cada anuncio de este tipo como una revolucion inminente. La telefonia movil avanza por acumulacion de mejoras incrementales, no por saltos milagrosos, y esta es una de esas mejoras que suma sin necesidad de exagerarla.

    Quieres aplicar esto en tu empresa? En Blixel.ai te ayudamos a integrar IA con sentido comun. Hablemos.